llms.txtとは?AI向けの案内ファイルの提案|標準規格ではなく、Google検索は「使用しない」と明記
社内でAI活用の話をしていると、自社サイトが生成AIにどう読まれているのか、という話題が出てきます。
そこで名前が挙がるのが llms.txt というファイルです。「置いておいたほうがいいらしい」と聞いた方も多いのではないでしょうか。
解説記事を開くと、AIに読ませるための標準ファイルで、サイトのルート直下に置くものだと書かれています。
ところが検索窓に llms.txt と打つと、候補に「意味ない」「効果」が並びます。置くべきだという説明と、置いても仕方ないという声が、同時に出てきます。
この記事では、llms.txt が何を提案しているファイルなのか、robots.txt や sitemap.xml と何が違うのか、そして誰が読むと公表しているのかを、提案の原文とGoogleの公式ドキュメントから整理します。
原文を開いてみたら、表題のすぐ下の一文が「標準化の提案」でした。出発点はここです!
この記事の監修者
AIリスキル株式会社 代表取締役
AIツールギャラリーを運営するAIリスキル株式会社の代表取締役。企業・自治体向けの生成AI研修とAI導入支援を手がけています。
実績: 大阪・関西万博 公式プログラム「AI HEROES COLLECTION」司会進行 / 神戸市デジタル人材育成エコシステム構築事業の運営 / MBS「せやねん!」「よんチャンTV」に生成AIの専門家として出演 / Felo日本初コアアンバサダー / Genspark第1期公式アンバサダー / Skywork公式アンバサダー / AKOOL公式パートナー など
llms.txtとは、何を提案しているファイルなのか
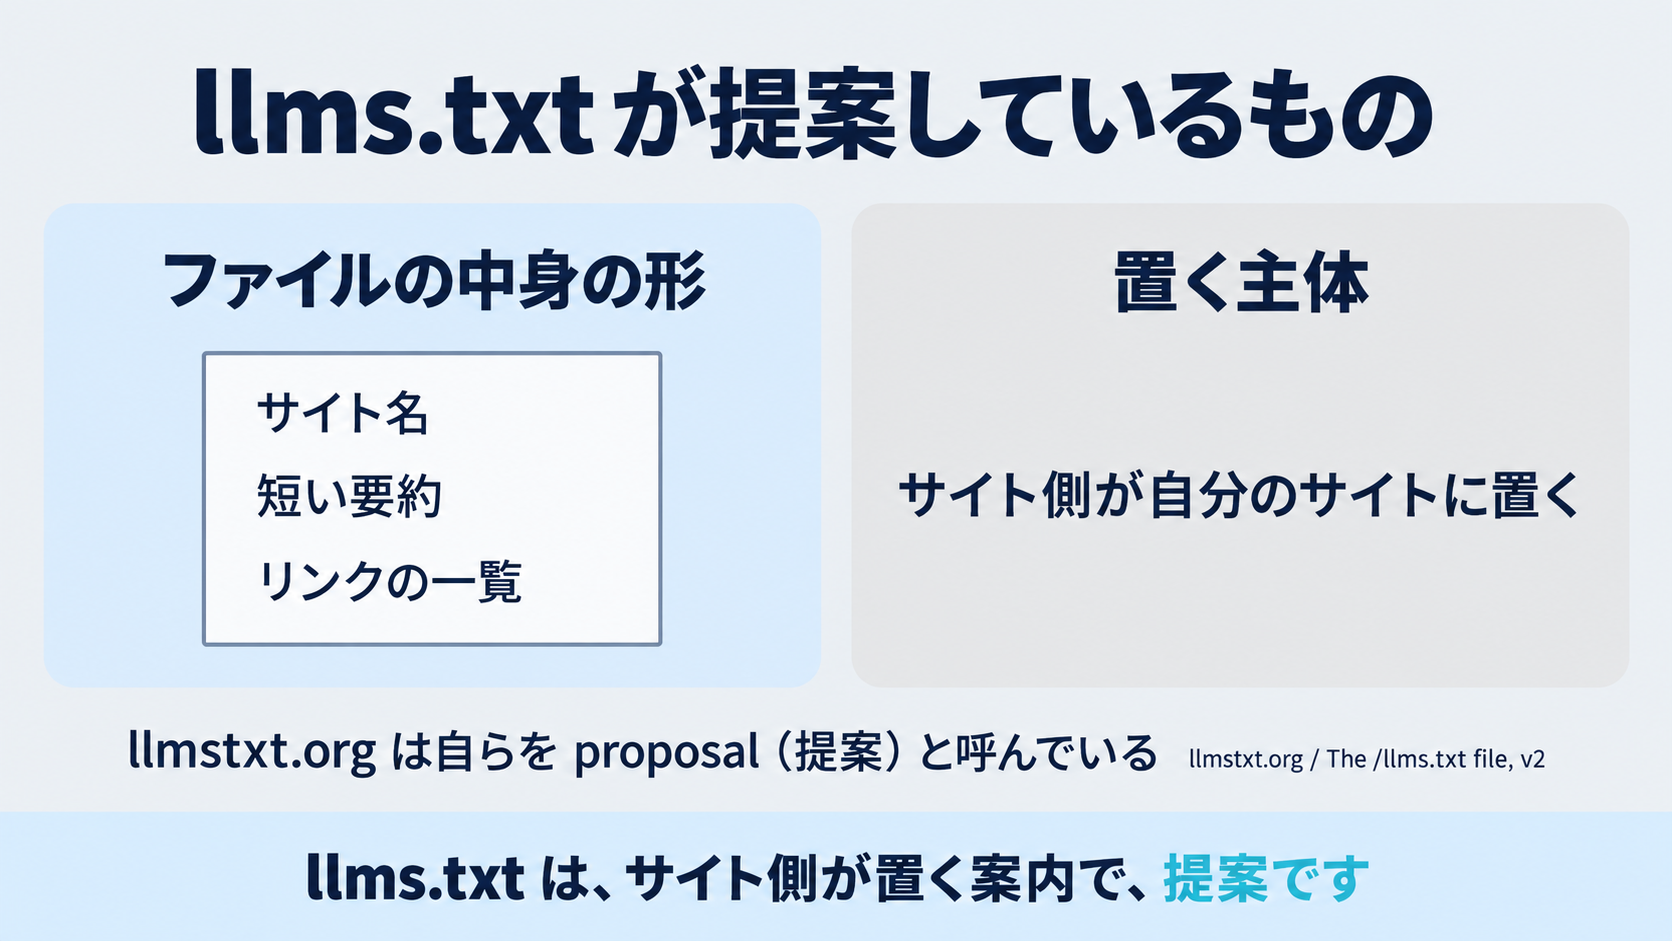
llms.txt は、llmstxt.org で公開されている一つの文書が提案しているファイル形式です。
その文書の表題は「The /llms.txt file, v2」、著者は Jeremy Howard 氏、公開日は 2024年9月3日と記載されています。
同じ場所に2026年8月10日の更新表示も並んでいます。公開は2024年ですが、中身はそのままではありません。
表題のすぐ下に置かれた一文が、この文書の性格を決めています。エージェントがウェブサイトを使う助けになる情報を提供するために、/llms.txt というファイルを使うことで標準化しよう、という提案、と書かれています。
この文書は、表題のすぐ下の一文から、標準化の「提案」として始まっています。
提案の中身は、本文でこう説明されています。LLMが扱いやすいコンテンツを提供するために、ウェブサイトに /llms.txt という Markdown ファイルを追加することを提案する、というものです。
原文は「propose」という語を使っています。文書自身が、自分を提案(proposal)と呼んでいます。
中身はごく素朴です。サイトやプロジェクトの名前、短い要約、そして「詳しくはここを読んでください」というリンクの一覧を、Markdown で1枚にまとめます。
人間向けのページは、ナビゲーションや広告やJavaScriptに情報が包まれています。原文は、そこから本文だけを取り出すのは難しく不正確だと書いています。
だから、あらかじめきれいなテキストで案内を用意しておこう、というのが提案の動機です。
置き場所は、ルート直下だけではありません
ここは注意が要ります。現行の原文は、置き場所をルート直下に限定していません。
原文にはこうあります。このファイルはサイトのルートに置くことも、その中の任意のパスに置くこともでき、そのパス配下のページをカバーする、という記述です。
複数のファイルが当てはまる場合は、エージェントは最も具体的なものを使うべきだ、とも書かれています。
実例として原文が挙げている FastHTML というプロジェクトは、ルートではなくドキュメント配下に置いています。ドキュメントのページだけをカバーさせる、という使い方です。
読者が生成AIの回答を通じて情報を探すようになった流れは、AI検索エンジンの記事で扱っています。llms.txt は、その流れをサイト側から見た話だと考えると位置づけがつかみやすくなります。
robots.txt や sitemap.xml とは、どこが違うのか
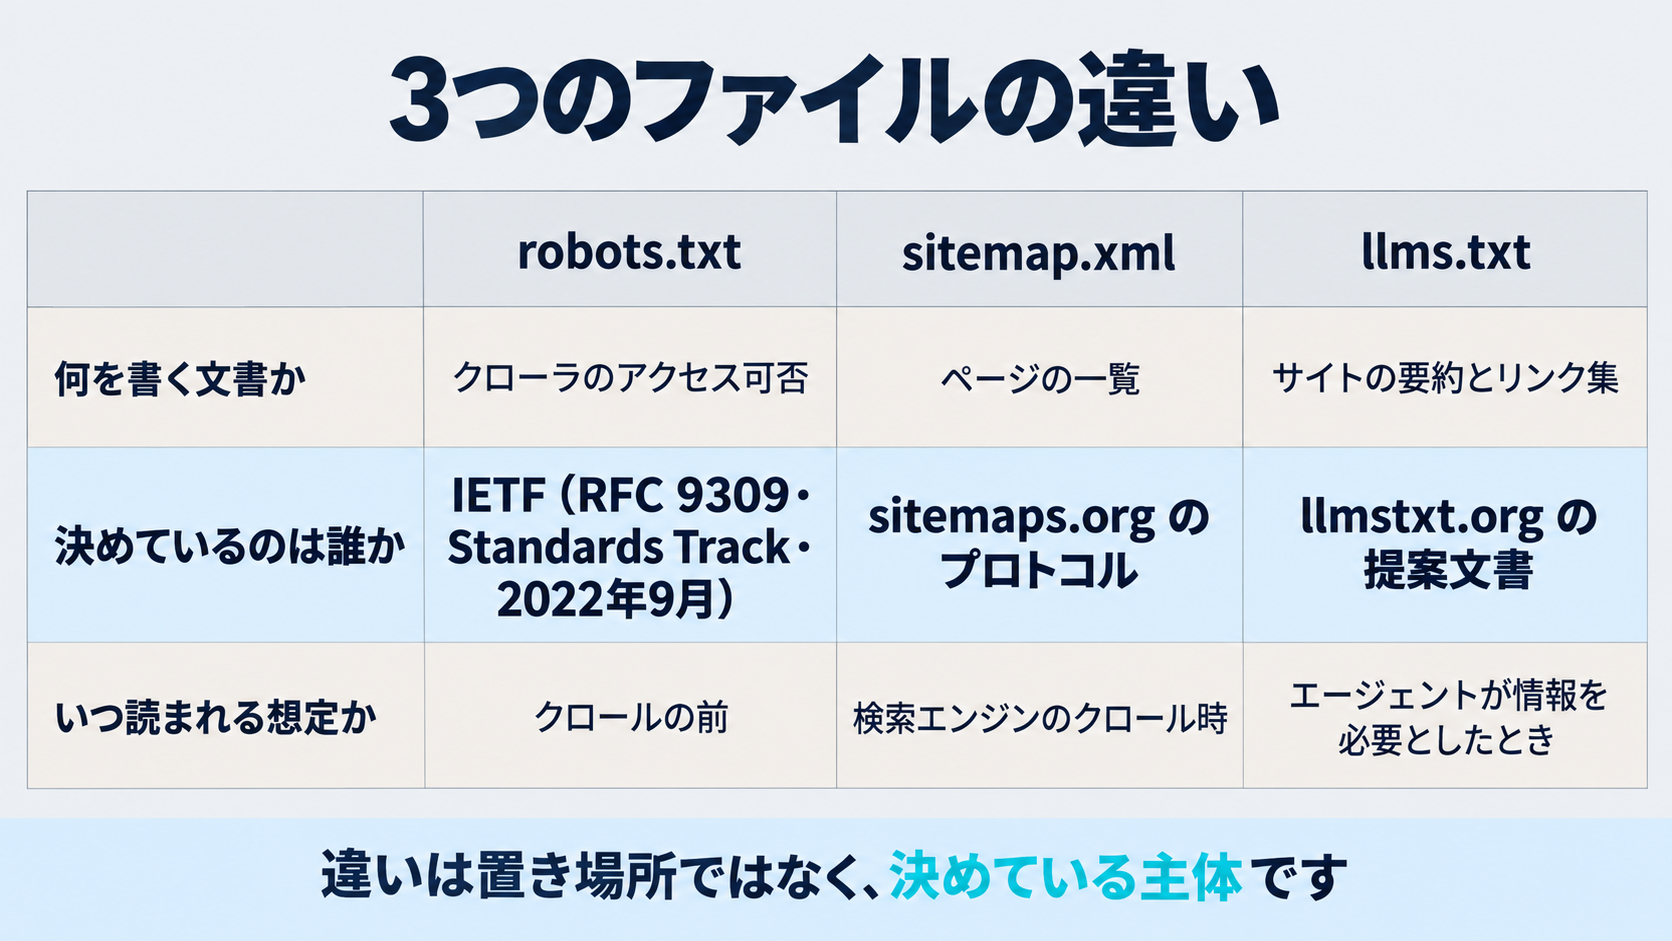
3つとも、サイトのルートに置かれる決まった名前のファイルです。見た目は似ています。
ただし、決めているのが誰なのかが、まったく違います。
robots.txt は、IETF が発行した RFC 9309 として定義されています。区分は Standards Track、発行は 2022年9月です。
著者にはGoogle所属の3名が名を連ねています。
その要旨には、1994年に Martijn Koster 氏が定義した方法を仕様として明文化し拡張したものだ、と書かれています。クローラからのアクセスをサイト側が制御するための文書です。
sitemap.xml は、sitemaps.org が公開しているプロトコルとして定義されています。XML のスキーマがあり、UTF-8 でなければならないといった形式要件も明記されています。
こちらはインデックス対象になる人間向けページを並べた一覧です。
llms.txt には、IETF や sitemaps.org にあたる標準化団体が関与していません。本記事で確認した範囲では、llmstxt.org という1つのサイトで公開されている提案文書があるだけです。
| robots.txt | sitemap.xml | llms.txt | |
|---|---|---|---|
| 何を書く文書か | クローラのアクセス可否 | ページの一覧 | サイトの要約とリンク集 |
| 決めているのは誰か | IETF(RFC 9309・Standards Track) | sitemaps.org のプロトコル | llmstxt.org の提案文書 |
| いつ読まれる想定か | クロールの前 | 検索エンジンのクロール時 | エージェントが情報を必要としたとき |
用途の違いは、提案側自身が書いています。
robots.txt は、サイトへのどんなアクセスが許容されるかを自動化ツールに伝えるものだという説明です。
これに対し、llms.txt の情報は、エージェントが利用者を手伝う途中で必要になったときに読まれるものだと書かれています。
sitemap.xml が代わりにならない理由も、原文が3つ挙げています。ページのLLM向け版が載っていないことが多いこと、外部サイトのURLを含まないこと、そして全体としてLLMのコンテキストに収まらない量になることです。
既存の標準をあえて使わなかった、と書いてあります
もう1つ、原文が正直に書いていることがあります。
Well-Known URIs という既存の標準(RFC 8615)を使う選択肢もあった、と原文は認めています。メタデータ用のファイルを置く場所として決められている仕組みです。
それを採らなかった理由は、その仕組みがオリジンのルートにしか置けないからです。共有ホスト上でパスしか管理できない発行者は、そこにファイルを追加できません。
既存の標準に乗らないという選択を、提案側が理由つきで説明しているわけです。ここも「標準ではない」の中身の一部です。
「標準になった」と書かれているのを見かけますが、実際はどうなのか
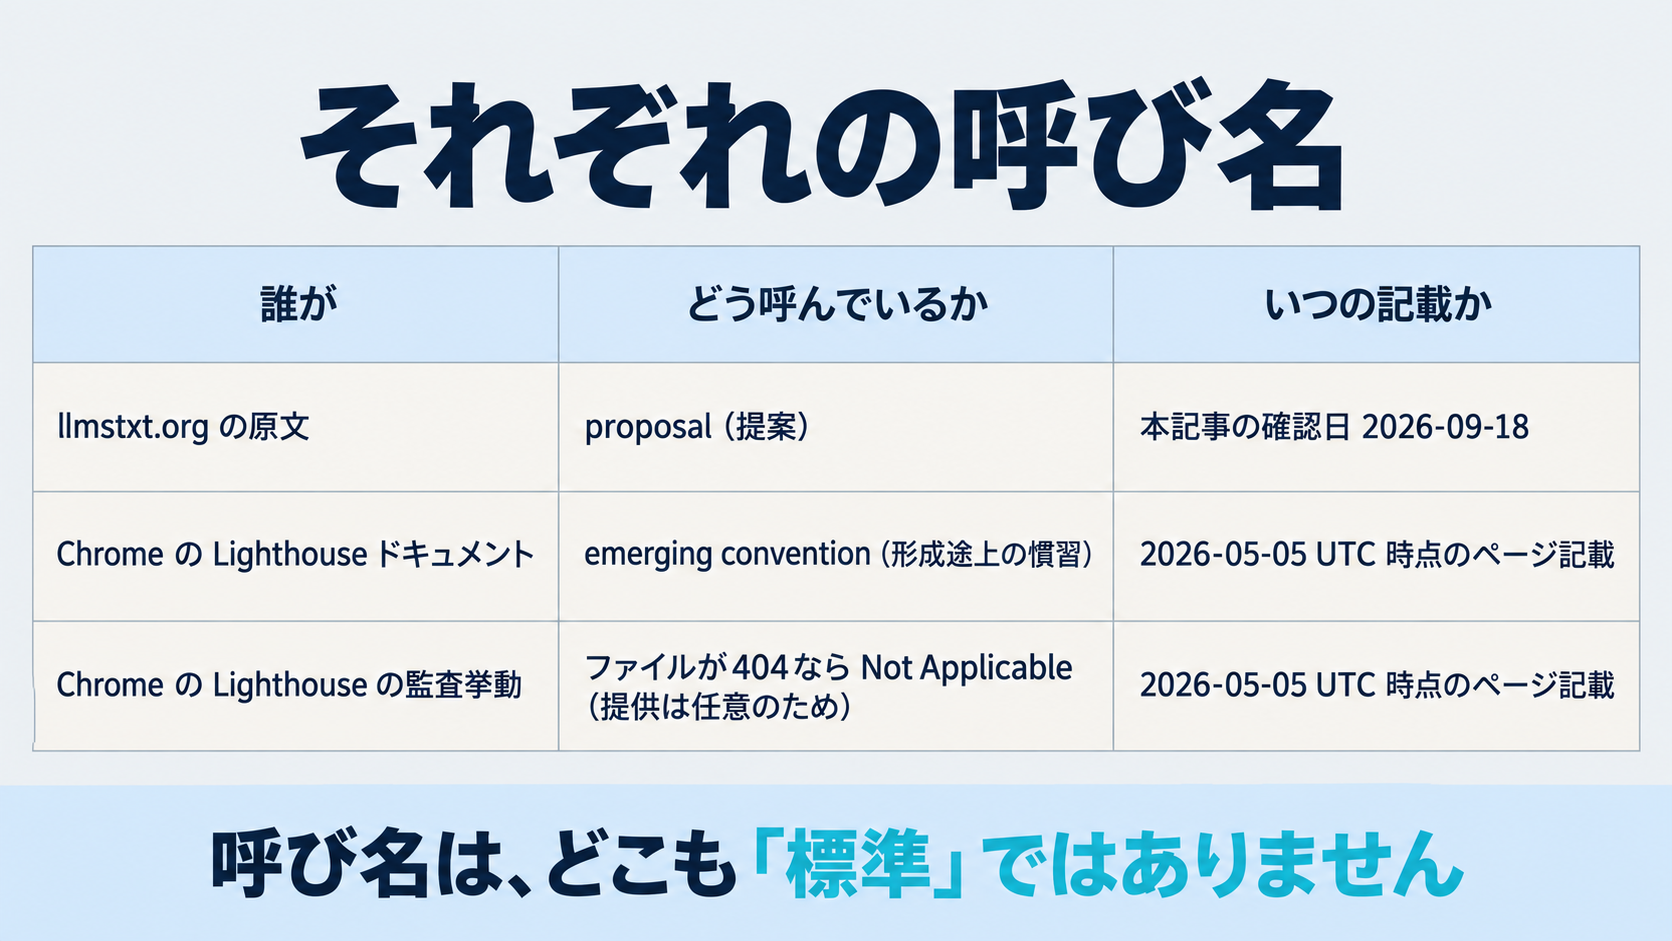
日本語の解説では、llms.txt を標準ファイルや標準規格と説明しているものがあります。
提案の原文は、自分を標準とは呼んでいません。冒頭から末尾まで proposal です。
別の呼び方も見ておきます。Chrome for Developers が公開している Lighthouse のドキュメントには、llms.txt の監査項目についてのページがあります。
そこでは llms.txt を、LLMやAIエージェント向けにサイトの内容を機械可読な要約として提供するための、形成途上の慣習(emerging convention)だと説明しています。
同じページには、監査の挙動も書かれています。ファイルの取得時にサーバエラーが起きた場合にページを指摘する一方で、ファイルが無くて404になる場合の監査はNot Applicableとして扱う、という記述です。
理由として、現時点ではファイルの提供は任意だからと書かれています。ページの最終更新表示は 2026-05-05 UTC でした。
提案そのものが、いま動いています
もう1つ、日本語の解説ではあまり触れられていない事実があります。
この提案は v2 になっています。llmstxt.org の Changes ページには、v2 が 2026年8月であることが記載されています。
v2 で足されたものと、消えたものがあります。
足されたのは、あるページからその Markdown 版や、それをカバーする llms.txt を見つけるための手段です。
HTMLのlink要素かHTTPのLinkヘッダーで、rel="alternate" と rel="describedby" を使う、と書かれています。
消えたのは、v1 にあったコンテキスト展開ツールです。それに伴って「Optional」という見出しの機械的な意味も失われたと Changes ページは書いています。
慣習としては残りますが、処理上の意味は無くなりました。
2年で中身が変わっているものを、確定した標準として扱うことはできません。
置けばAIに拾われるのか、誰が読むと公表しているのか
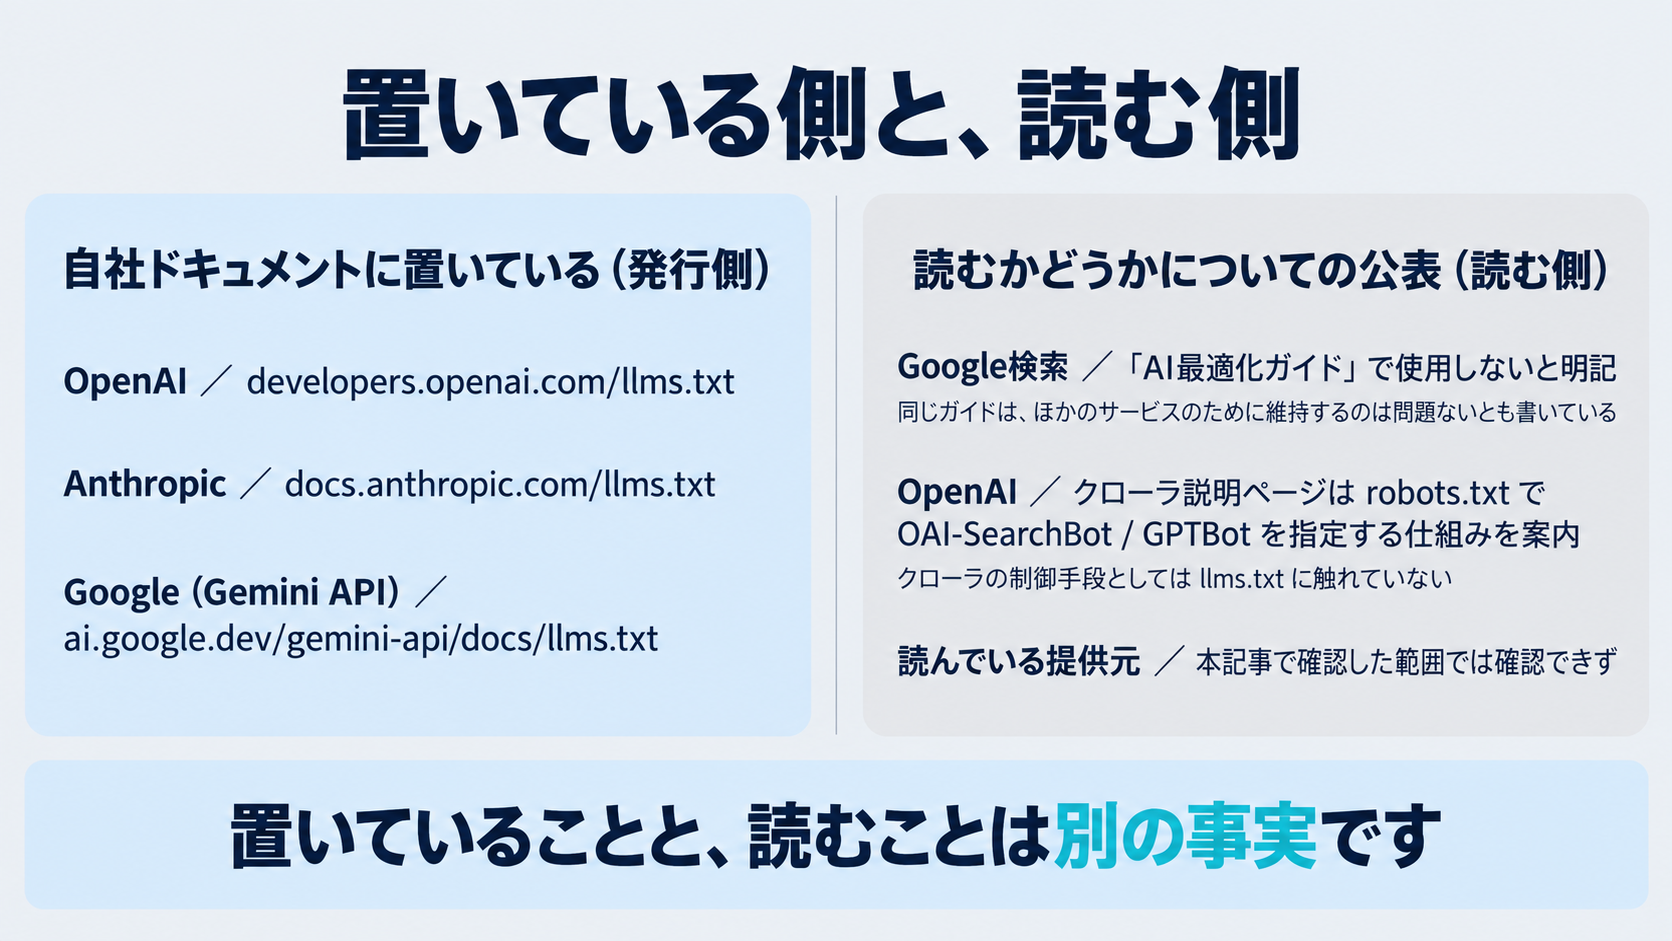
ここがいちばん知りたいところだと思います。確認できたことを、提供元ごとに分けて並べます。
Google検索は、名指しで「使わない」と書いています
Google 検索セントラルの「AI 最適化ガイド」には、生成AI検索についての誤解を解く節があります。そこに LLMS.txt が名指しで出てきます。
書かれているのは、Google 検索(生成AI機能を含む)で表示されるようにするために、新たにコンピュータが解読可能なファイルやAIテキストファイル、マークアップ、マークダウンを作成する必要はないということです。
理由は、Google 検索自体がそれらを使用しないためだと説明されています。
ただし、この記述には続きがあります。
同じ段落に、これらのファイルを使用するほかのサービスやシステムのために、LLMS.txtファイルを作成して維持することにしても、まったく問題ないと書かれています。
そして、Google 検索ではそれらは無視されるため、サイトのGoogle検索での表示やランキングに影響することはない、という記述が続きます。
つまり、Googleが言っているのは「うちは見ない」であって、「置くな」ではありません。
この注記がいつ入ったのかも分かります。Google 検索セントラルのドキュメント更新履歴に、2026年6月15日の項として「llms.txt ファイルに関するガイダンスを明確化」という記録があります。
追加の理由も、同じ更新履歴に書かれています。コミュニティからの質問に対応するため、という説明です。
明確にしたかったのは2点だと読み取れます。1つは、これらのファイルはGoogle検索には必要なく、可視性やランキングにプラスにもマイナスにも影響しないことです。
もう1つは、これらのファイルを使用するほかのサービスやシステムのために維持したい場合は問題ないことです。
同じGoogleでも、Chromeは監査項目として持っています
紛らわしいのですが、Google検索とChromeは別の製品です。
さきほど触れたとおり、Chrome の Lighthouse には llms.txt の監査項目があります。エージェントによる閲覧に関する監査群の1つとして置かれています。
Google検索が使わないことと、ChromeのLighthouseが監査項目を持っていることは、両立します。主体も用途も違うためです。
なお同じ監査群には、WebMCP に関する項目も並んでいます。llms.txt だけが特別扱いされているわけではありません。
OpenAIは、サイト側にrobots.txtで話しかけています
OpenAI が公開しているクローラの説明ページを開きました。
そこに書かれているのは、OAI-SearchBot と GPTBot という名前を robots.txt で指定することで、サイトとコンテンツがAIとどう関わるかをサイト運営者が管理できるという仕組みです。
検索結果に出したい場合は robots.txt で OAI-SearchBot を許可することを推奨する、とも書かれています。
このページに、llms.txt をクローラの制御手段として扱う記述はありませんでした。
3社とも、自社のドキュメントには置いています
提案の原文には、次の記述があります。AIラボ自身が、自社の開発者向けドキュメントのために llms.txt ファイルを公開しているとして、OpenAI・Anthropic・Gemini の3つのURLが挙げられています。
本記事では、この3つのURLを実際に開きました。いずれも実在し、中身も確認できました。
| 提供元 | URL | 冒頭の見出し |
|---|---|---|
| OpenAI | developers.openai.com/llms.txt | OpenAI Developers |
| Anthropic | docs.anthropic.com/llms.txt | Anthropic Developer Documentation |
| Google(Gemini API) | ai.google.dev/gemini-api/docs/llms.txt | Gemini API |
ここで線を引く必要があります。これは3社が発行側として置いているという事実です。
自社の製品が、他人のサイトの llms.txt を読むかどうかは、この事実からは何も言えません。
確認できなかったこと
正直に書きます。第三者のサイトに置かれた llms.txt を自社の製品が読む、と公表している提供元を、本記事で確認した範囲では見つけられませんでした。
OpenAI のクローラ説明ページに、その種の記述はなく、Anthropic と Google についても同種の公表を確認できていません。Perplexity など、ほかの提供元の文書は今回開いていません。
読まれていないという意味ではありません。確認できなかった、という意味です。
提案の原文には、コーディングエージェントが API リファレンスやチュートリアルを見つけるために llms.txt をたどっているという記述があります。ただしこれは提案の著者による記述であり、各提供元の公表ではありません。
AIブラウザやAIエージェントが実際にどのファイルを読みにいくのかは、製品ごとに違います。一律の答えを期待しないほうが安全です。
どういうサイトで実際に使われているのか
提案の原文には、実際の使われ方についての記述があります。
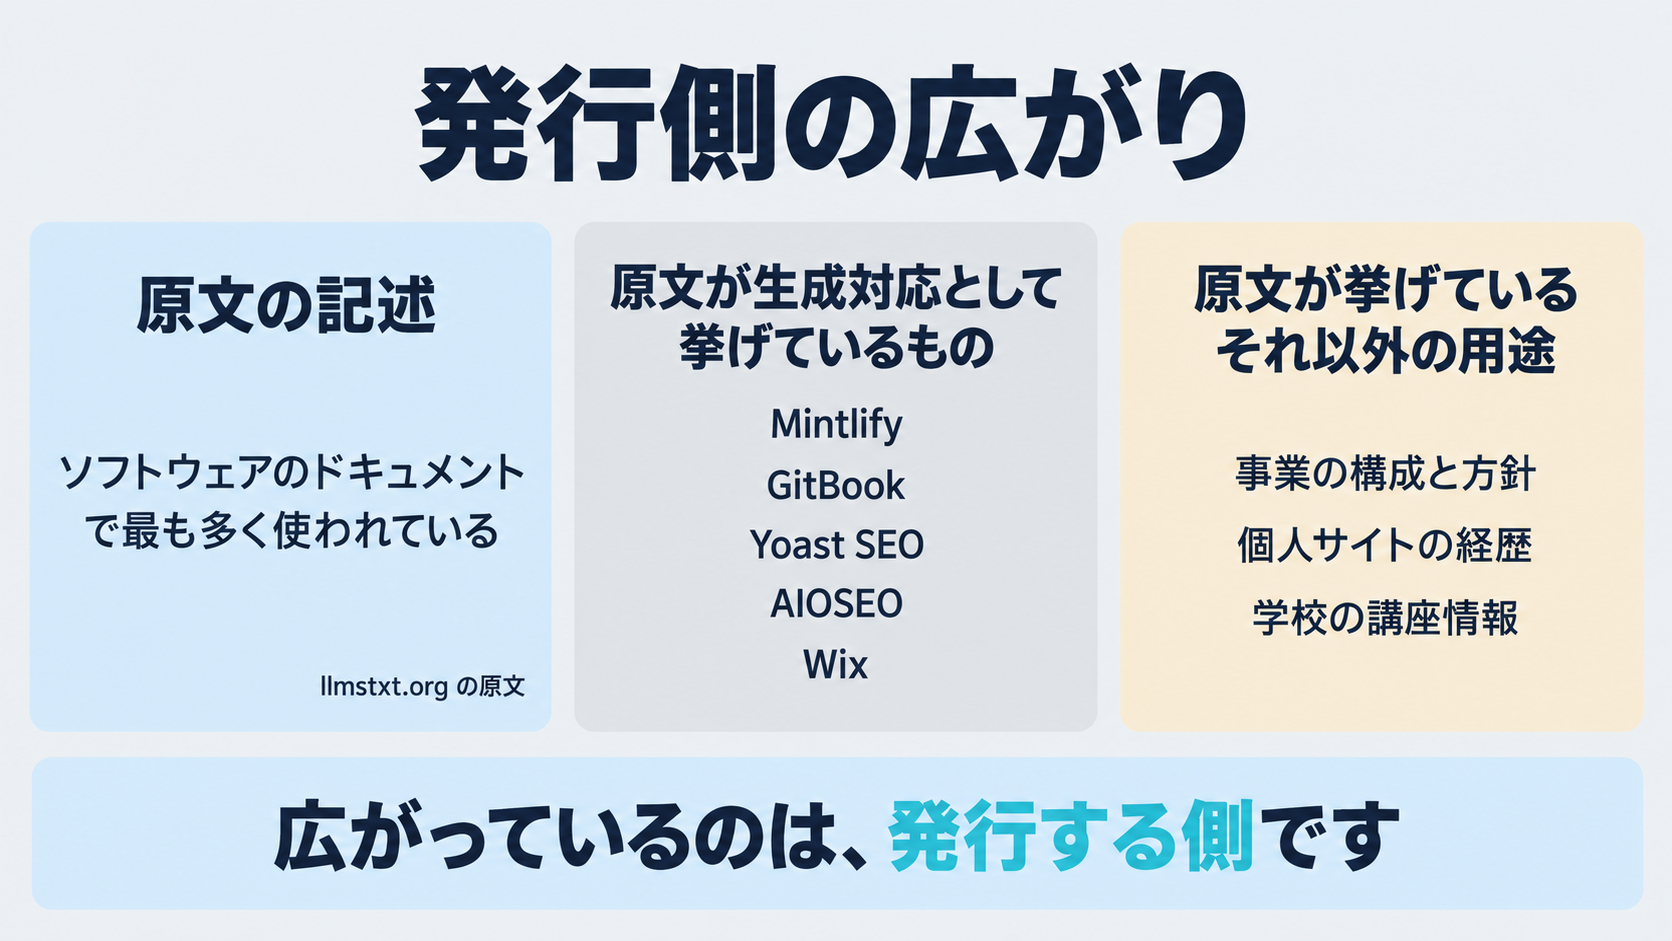
llms.txt はソフトウェアのドキュメントで最も多く使われており、そこではコーディングエージェントがAPIリファレンスやチュートリアルを見つけるためにたどっている、という説明です。
同じ構造は、エージェントがサイトの内容へ案内を必要とするところならどこでも使える、とも書かれています。事業の構成と方針を示す場合、個人サイトで経歴についての質問に答える場合、学校が講座情報への入口を用意する場合が例として挙がっています。
発行側の裾野は、ツールの対応から見えます。原文は、llms.txt を自動生成できるものとして Mintlify・GitBook・Yoast SEO・AIOSEO・Wix を挙げています。
ただし、これらはそれぞれのサービスについての事実です。生成してくれることと、生成したものが読まれることは別の話です。
社内のドキュメントをAIに読ませたい場合は、別の話になります
ここまで読んで、「社内資料をAIに読ませたいだけなのだが」と思った方もいるかもしれません。
その場合、llms.txt は必ずしも出発点になりません。公開サイトに置くファイルだからです。
社内の複数システムにある文書を横断して探す仕組みは、エンタープライズサーチとして整理しています。

AIに社内文書を参照させながら回答させる仕組みは、RAGの記事で扱っています。

公開サイトをAIに読ませる話と、社内文書をAIに読ませる話は、置く場所も仕組みも違います。混ぜないほうが判断しやすくなります。
中身には、何を書くことになっているのか
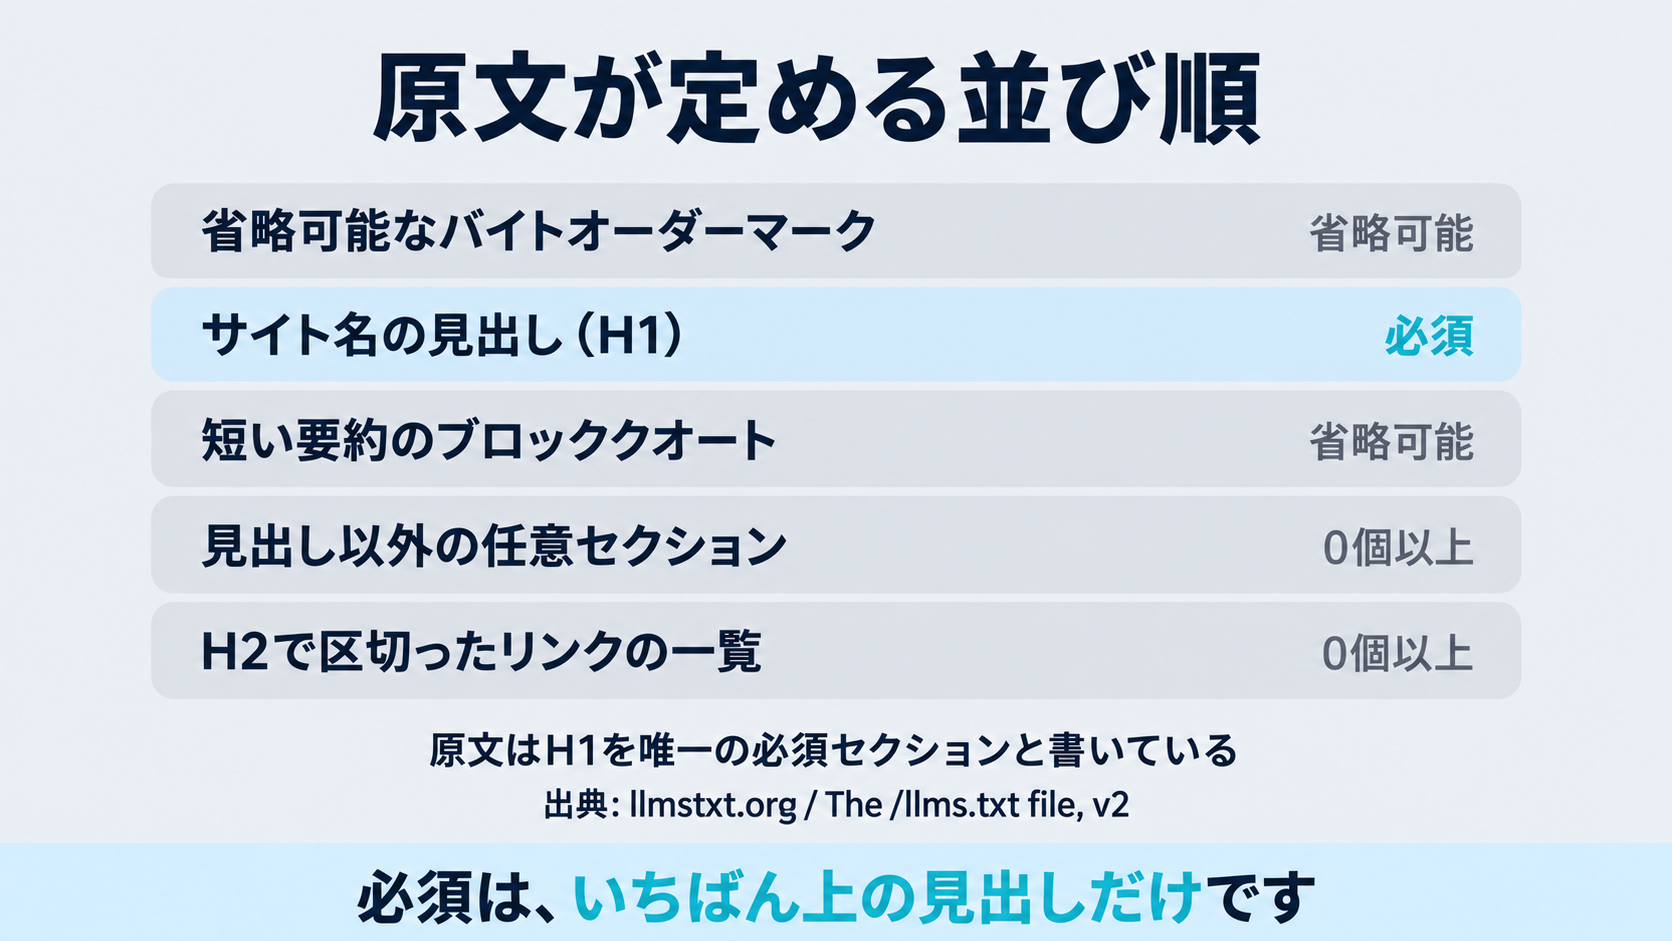
原文は、仕様に沿うファイルが含む内容を順序つきで定めています。
- 省略可能なバイトオーダーマーク
- プロジェクト名またはサイト名の見出し(H1)。原文はこれを唯一の必須セクションだと書いています
- 短い要約のブロッククオート。ファイルの残りを理解するのに必要な情報を入れます
- 見出し以外の任意のセクション。0個以上で、詳しい説明や読み方の注意を書きます
- H2 で区切ったリンクの一覧。0個以上です
リンクの一覧は、Markdown のリストとして書きます。リンク自体は必須で、そのあとにコロンを置いて説明を足すことができます。
「Optional」という見出しは、短いコンテキストが必要なときにエージェントが飛ばしてよい二次的な情報を置くための慣習だと原文は説明しています。
原文に見当たらなかった記述
ここは注意して読んでください。
日本語の解説でよく見かける次の3つは、本記事が取得した原文の全文には見当たりませんでした。
| よく見かける記述 | 原文での確認結果 |
|---|---|
| llms-full.txt は llms.txt の拡張版である | 原文に llms-full という文字列の出現なし |
| ファイルサイズは100KB未満にする | 原文にサイズ上限の記述なし |
| 文字コードはUTF-8にする | 原文に UTF-8 の記述なし |
別の出所がある可能性は残ります。ただし、提案の原文を根拠として書かれているのであれば、それは正確ではありません。
なお、本記事が2026年9月18日に「llms.txt 書き方」を検索したときは、検索結果の上部に出た生成AIの要約が「ファイルサイズは100KB未満、文字コードはUTF-8で作成するのが基本」と説明していました。
ただしこれは、その時点の表示を本記事が見たという観測です。生成AIの要約は利用者や時点によって変わるため、読者が同じ表示を再現できるとは限りません。
上の表の根拠は、この観測ではなく、原文の全文にあたった結果のほうです。
v2で足された、ページ側の準備
原文は、llms.txt とセットでもう1つ提案しています。エージェントが必要としそうな情報を持つページは、同じURLでクリーンな Markdown 版も提供する、というものです。
URLの作り方は、元のURLに .md を足す形と、拡張子を .md に置き換える形の両方が認められています。後者は v2 で足されました。
そして、それらを見つけてもらうための link 関係が v2 の追加点です。rel="alternate" でページの Markdown 版を指し、rel="describedby" でそのページをカバーする llms.txt を指します。
HTML の link 要素でも、HTTP の Link ヘッダーでも書けます。ヘッダー形式なら、ページを書き換えずにサーバやCDNの設定だけで足せる、と原文は説明しています。
置くかどうかは、何を見て決めればよいのか
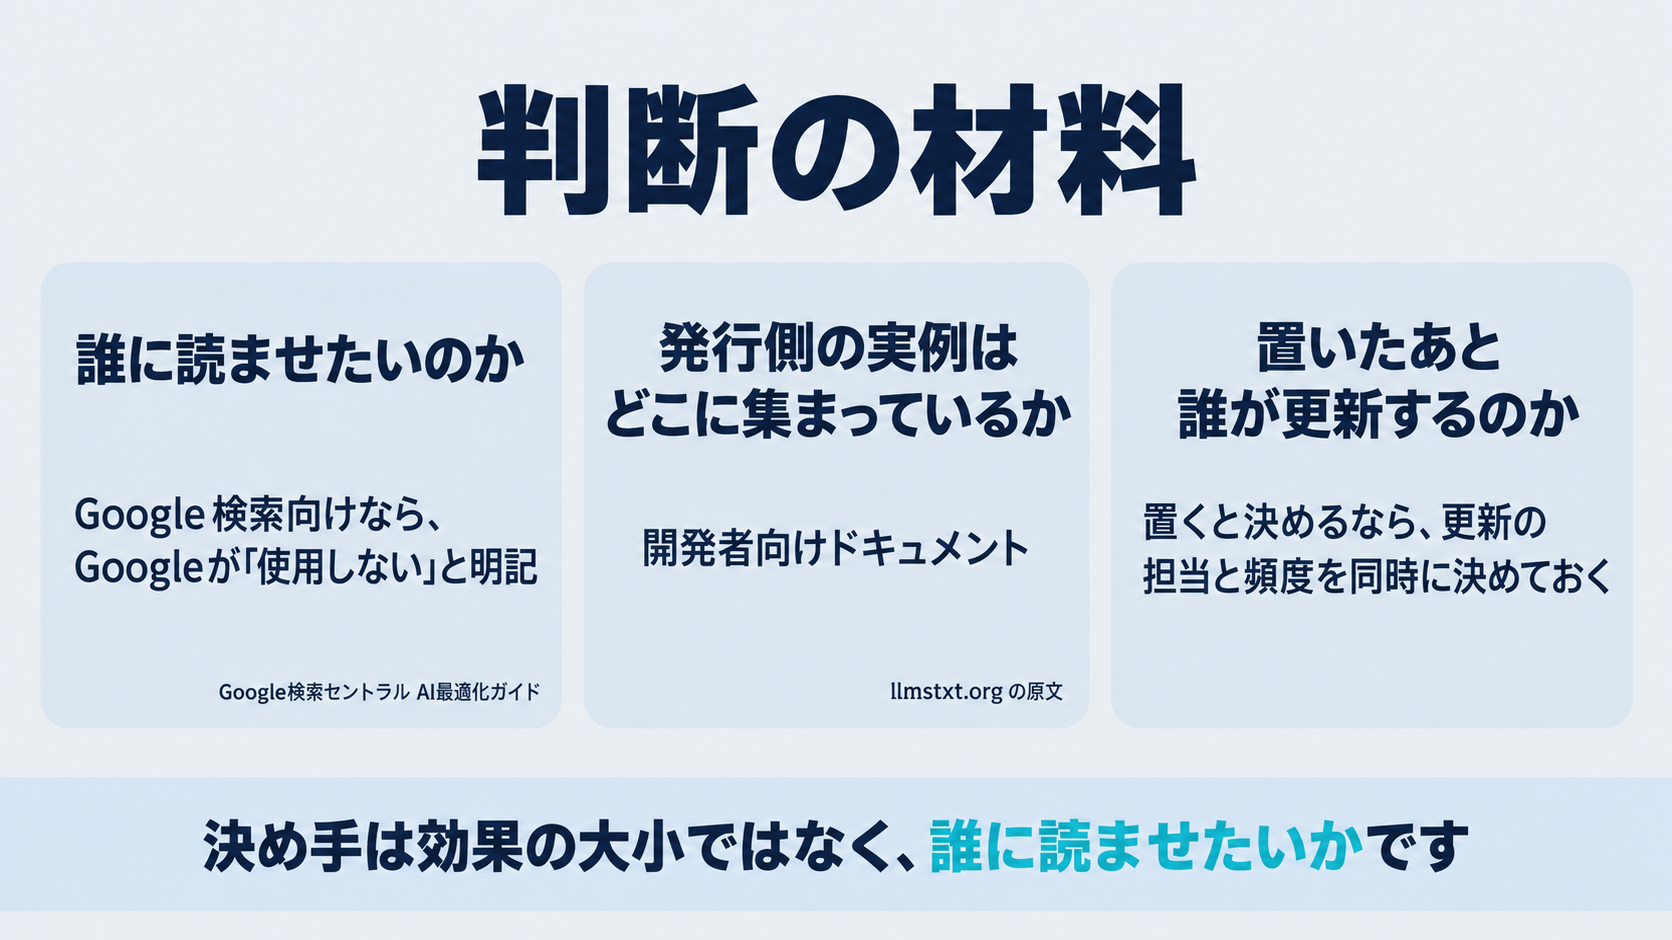
本記事は、置くべきかどうかの答えを出しません。効果を確かめた一次情報を持っていないためです。
代わりに、判断の材料を3つ整理します。
1. 誰に読ませたいのかを先に決めます
Google検索の結果やAIによる概要に出したいのであれば、Googleは使用しないと明記しています。
Googleの更新履歴の言い方を借りれば、可視性やランキングにプラスにもマイナスにも影響しない、ということになります。
一方で、社内やチームで使っているコーディングエージェントに自社の技術ドキュメントを読ませたい、という目的であれば話が変わります。
目的が「Google検索経由」なのか「特定のエージェント経由」なのかで、見るべき情報が変わります。
2. 発行側の実例がどこに集まっているかを見ます
提案の原文が挙げている実例は、開発者向けドキュメントに強く寄っています。AIラボ3社のURLも、いずれも開発者ドキュメントです。
自社サイトがドキュメントサイトに近い構造なのか、それとも一般的な事業サイトなのかで、参考にできる実例の量が変わります。
3. 置いたあと、誰が更新するのかを決めます
llms.txt は、サイトの要約とリンクの一覧です。サイトの構成が変われば、内容もずれます。
原文には、更新についての要件は書かれていません。つまり、仕様の側は更新を求めていません。
これは記載の不在からの読み取りです。古いまま置き続けても支障がない、という意味ではありません。
だからこそ、置くと決めるなら、更新の担当と頻度を同時に決めておくほうが安全です。
この記事が判断しないこと
クロールの可否や学習利用の可否について、法的な判断は書きません。
セキュリティ上の可否判定も書きません。公開サイトに置くファイルである以上、何を書くかは公開してよい情報かどうかの判断とセットになります。
そこは自社の基準で決めてください。
AIが外部のツールや社内システムと接続する仕組み全般はMCPの記事で、AIに調査をさせる使い方はディープリサーチの記事で扱っています。
自社でのAI活用の進め方についてご相談がある場合はお問い合わせはこちらからご連絡ください。
まとめ
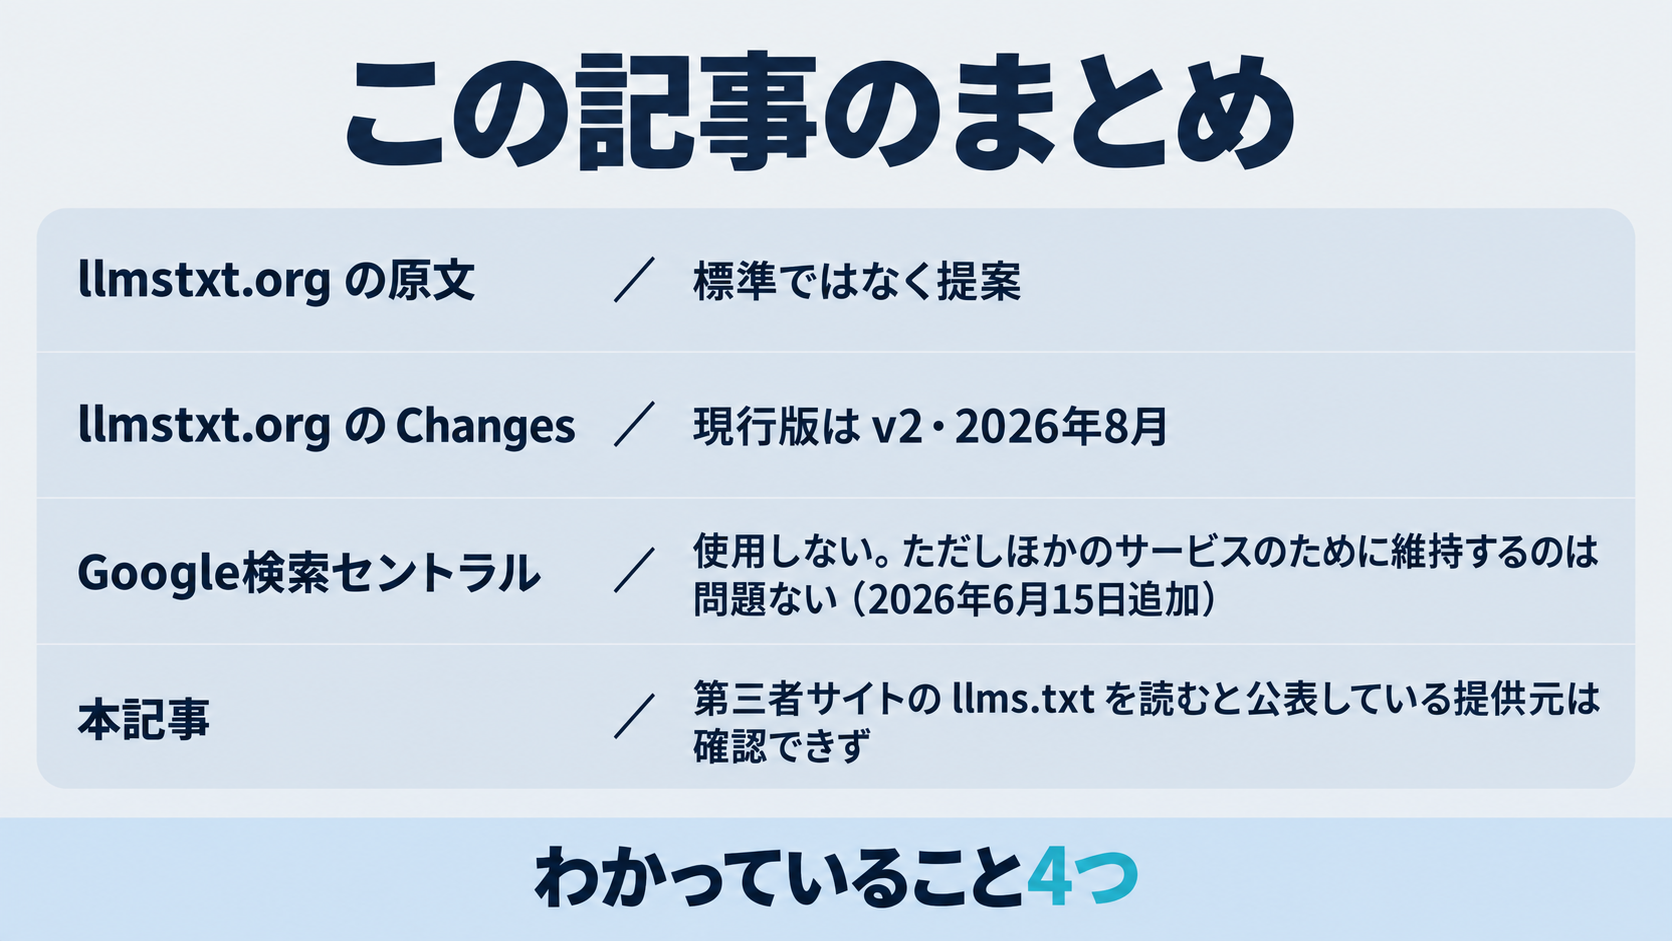
llms.txt は、AIエージェント向けにサイトの要約とリンクをMarkdownで置こう、という提案です。llmstxt.org で公開されている文書が、自分を proposal と呼んでいます。
標準規格ではありません。robots.txt が IETF の RFC 9309 として定義されているのとは、決めている主体が違います。
現行版は v2 で、2026年8月です。置き場所はルート直下に限らず、任意のパスに置けると書かれています。
Google検索は、名指しで使用しないと書いています。同時に、ほかのサービスのために維持するのは問題ないとも書いています。
この注記は 2026年6月15日に追加されたものです。
OpenAI・Anthropic・Googleの3社は、自社の開発者ドキュメントに llms.txt を置いています。ただしそれは発行側の事実であって、読む側の事実ではありません。
そして、第三者サイトの llms.txt を自社製品が読むと公表している提供元は、本記事で確認した範囲では確認できませんでした。
「置けばAIに拾われる」と読める説明に出会ったときは、それが誰の公表にもとづく話なのかを確かめてください。これが本記事のいちばんの結論です。
この記事の出典
- The /llms.txt file, v2(llmstxt.org、2026-09-18確認)
- llms.txt Changes(llmstxt.org、2026-09-18確認)
- AI 最適化ガイド(Google 検索セントラル、2026-09-18確認)
- Google 検索セントラル ドキュメントの更新履歴(Google 検索セントラル、2026-09-18確認)
- llms.txt | Lighthouse(Chrome for Developers、2026-09-18確認)
- Overview of OpenAI Crawlers(OpenAI、2026-09-18確認)
- OpenAI Developers の llms.txt(OpenAI、2026-09-18確認)
- Anthropic のドキュメントの llms.txt(Anthropic、2026-09-18確認)
- Gemini API ドキュメントの llms.txt(Google、2026-09-18確認)
- RFC 9309 Robots Exclusion Protocol(IETF、2026-09-18確認)
- Sitemaps XML format(sitemaps.org、2026-09-18確認)
この記事は役に立ちましたか?
感想は、今後の記事改善に活用します。
関連記事
プロンプトキャッシュとは?生成AIの入力を使い回して料金を下げる仕組み|効く条件と効かない場面
プロンプトキャッシュは、生成AIに毎回送る同じ前置きの計算結果を再利用して、入力の料金を下げる仕組みです。Windowsのコマンドプロンプトのキャッシュ削除とは別の言葉です。割引率も最小トークン数も保持時間も提供元とモデルで違うので、OpenAI・Anthropic・Google・AWSの公式ドキュメントから条件ごと整理しました。
ナレッジカットオフとは?AIが古い情報のまま答える理由|カットオフは1つとは限りません
ナレッジカットオフは、AIが学習に使ったデータの新しさの境目を指す言葉です。経理や検査のカットオフとは別の言葉です。同じモデルについて2つの日付を公表している例や、分野によって知識の新しさが違うと注記している例を、AnthropicとGoogleの公式ドキュメントとモデルカードから帰属つきで整理しました。
A2Aプロトコル(Agent2Agent)とは?MCPとの違いは「つなぐ相手がツールかエージェントか」|v1.0はいつ出たか
A2Aプロトコル(Agent2Agent)は、別々のベンダーが作ったAIエージェント同士をつなぐためのオープン標準です。決済分野でいうA2A(口座間の直接送金)とは別の言葉です。MCPとの関係、仕様がv1.0になった時期、試す前の確認点を、A2AとMCPの公式ドキュメントおよび公式ブログから整理しました。
知識蒸留とは?大きいモデルの答えで小さいモデルを訓練する仕組み|量子化との違いと「禁止」と検索される理由
知識蒸留は、大きいモデルに答えを出させ、その答えで小さいモデルを訓練する手法です。お酒や化学の蒸留とは別の話です。量子化や枝刈りとの違いと、OpenAI・Google・Anthropic・Metaの契約・規約・ライセンスに実際に書かれている文言を、それぞれが誰に向けた文書かも添えて、原論文と各社の公式ドキュメントから整理しました。
次のAIツール選びへ
気になるツールを並べて、料金や特徴の違いを確認できます。