プロンプトキャッシュとは?生成AIの入力を使い回して料金を下げる仕組み|効く条件と効かない場面
社内で生成AIのAPIを使った仕組みを動かしはじめて、毎月の請求を見るようになった。そんな段階に入った方も多いのではないでしょうか。
毎回同じ社内マニュアルを読ませているのだから、そこだけでも安くならないか。そう考えて調べると「プロンプトキャッシュ」という言葉に行き当たります。
ところが読み進めると、割引率の数字が記事ごとにそろっていません。桁が一つ違うものまであります。
さらにWindowsのコマンドプロンプトでキャッシュを消す話まで混ざってきて、どれが自分の探していた話なのか分からなくなります。
この記事では、プロンプトキャッシュが生成AIの何を使い回す仕組みなのか、なぜ割引率の数字がそろわないのか、そしてどんな条件で効いてどんなときに効かないのかを整理します。
根拠にしたのは、OpenAI・Anthropic・Google・AWSの公式ドキュメントです。
本記事で開いた公式ドキュメントには、無条件に「これだけ安くなる」と書いたものはありませんでした。条件のほうが本体でした!
この記事の監修者
AIリスキル株式会社 代表取締役
AIツールギャラリーを運営するAIリスキル株式会社の代表取締役。企業・自治体向けの生成AI研修とAI導入支援を手がけています。
実績: 大阪・関西万博 公式プログラム「AI HEROES COLLECTION」司会進行 / 神戸市デジタル人材育成エコシステム構築事業の運営 / MBS「せやねん!」「よんチャンTV」に生成AIの専門家として出演 / Felo日本初コアアンバサダー / Genspark第1期公式アンバサダー / Skywork公式アンバサダー / AKOOL公式パートナー など
プロンプトキャッシュとは何を使い回す仕組みなのか
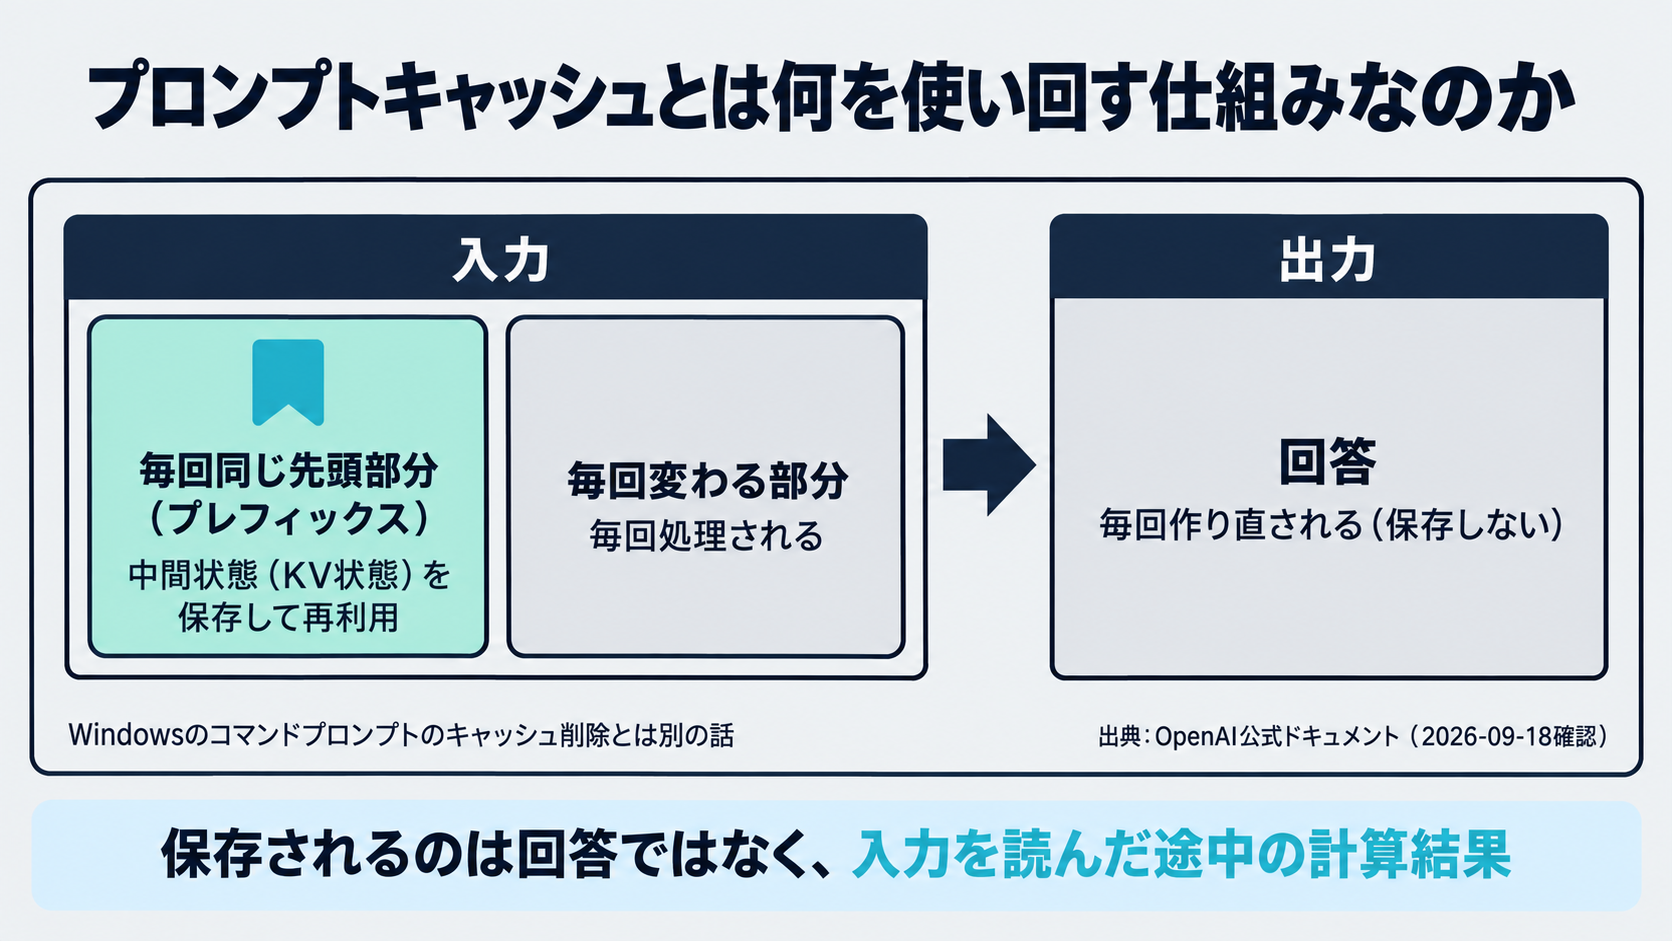
はじめに、まぎらわしい言葉を切り分けておきます。
ここで扱うプロンプトキャッシュは、Windowsのコマンドプロンプトでキャッシュを消す操作とは別の話です。生成AIに文章を送るときの、入力の扱いについての仕組みを指します。
OpenAIは公式ドキュメントで、この仕組みをリクエストどうしが同じプロンプトの先頭部分を共有するときに、処理を再利用するものだと説明しています。
同社は、モデルが入力トークンを処理するときにKV(キーバリュー)状態と呼ばれる中間状態を計算していると書いています。プロンプトキャッシュは、再利用できる先頭部分についてこの状態を保持します。
注意したいのは、保存されるのが回答ではなく、入力を読んだ途中の計算結果だという点です。
同社は、新しい入力は毎回処理されると明記しています。同じ前置きを使い回しても、質問が違えば回答は作り直されます。
この「先頭部分」はプレフィックスと呼ばれます。Anthropicは、キャッシュがツール定義、システムプロンプト、メッセージの順にプロンプト全体をたどると説明しています。
料金がトークン単位で決まる理由は、トークンの記事で扱いました。プロンプトキャッシュは、そのトークンのうち毎回同じ部分の単価を下げる仕組みだと考えると、位置づけが見えやすくなります。

使い回す前置きそのものの作り方については、プロンプトテンプレートの記事が近い話をしています。
なお、この機能をどう呼ぶかは提供元で違います。Googleはコンテキストキャッシュ保存と呼び、Gemini 2.5以降のすべてのモデルで暗黙的なキャッシュ保存が既定で有効だと書いています。
AWSはAmazon Bedrockのプロンプトキャッシュとして、暗黙的キャッシュと明示的キャッシュの2種類があり、対応はモデルとAPIで異なると書いています。
なぜ割引率の数字が記事ごとに違うのか
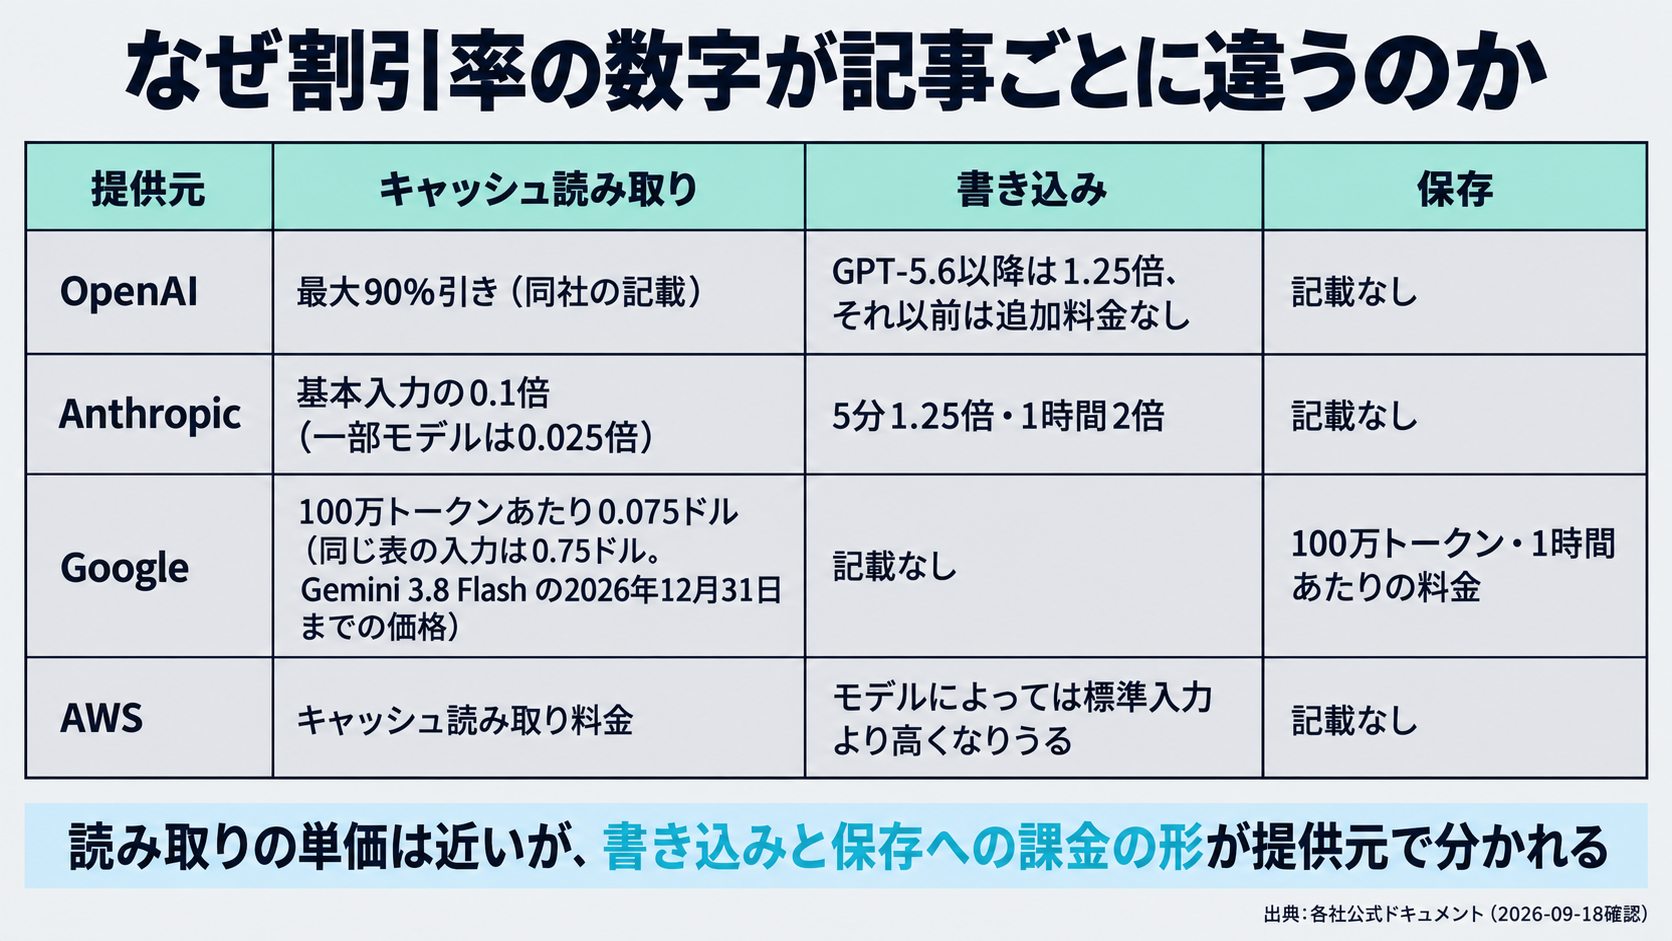
割引率が食い違って見えるのは、各社が同じものを指していないからです。
OpenAIは公式ドキュメントで、再利用されるトークンにはモデルのキャッシュ入力料金が適用され、最大90%割り引かれると書いています。
Anthropicは料金の倍率を明示しています。キャッシュ読み取りは基本入力の0.1倍で、Claude Fable 5.1 と Claude Mythos 5.1 では0.025倍だと注記しています。
Googleは料金ページに、モデルごとのコンテキストキャッシュの単価を載せています。
2026年9月18日に確認した表では、Gemini 3.8 Flash の入力が100万トークンあたり0.75ドル、コンテキストキャッシュが0.075ドルでした(いずれも2026年12月31日までの価格としての記載)。
ここまでは水準が近い話です。分かれるのはこの先です。
Googleの同じ料金ページには、トークン単価とは別建てで保存料金が載っています。100万トークン・1時間あたり0.50ドルで、2027年1月1日からは1.00ドルという書き方です。
同じページには、入力とコンテキストキャッシュの単価も2027年1月1日から倍になると記載されています。上がるのは保存料金だけではありません。
AWSはBedrockのユーザーガイドで、モデルによってはキャッシュに書き込まれたトークンが標準の入力料金より高い料金で課金されうると、条件つきで書いています。
つまり各社は、読み取りの安さだけでなく、書き込みや保存にどう課金するかまで含めて別の設計をしています。
一つの割引率に丸められないのは、このためです。
キャッシュの書き込みに割増はかかるのか
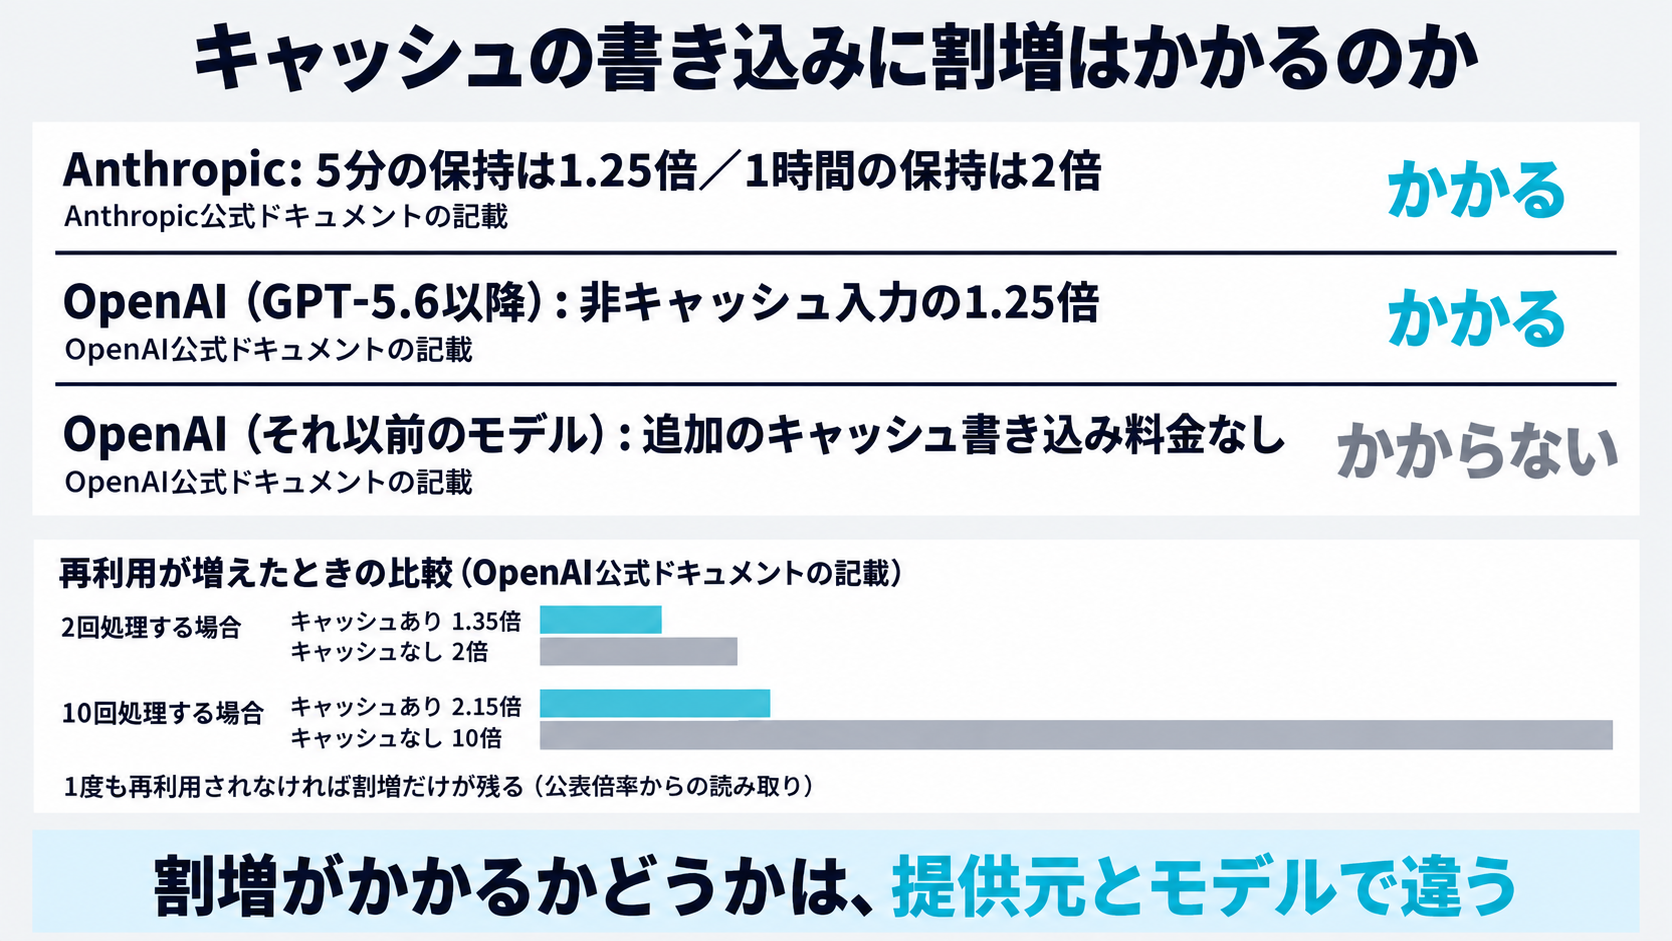
Anthropicは、キャッシュの区切りそのものには費用が発生せず、課金対象はキャッシュ書き込み、キャッシュ読み取り、通常の入力トークンの3つだと書いています。
そのうえで倍率を出しています。5分の保持での書き込みは基本入力の1.25倍、1時間の保持での書き込みは2倍です。
OpenAIは、同じ会社の中でもモデルの世代で書き分けています。GPT-5.6以降は書き込みが非キャッシュ入力の1.25倍で、読み取りが0.1倍です。
一方で同社のモデル比較表は、それ以前のモデルについては追加のキャッシュ書き込み料金がないとしています。
OpenAIは、この倍率で何回目から得になるかも具体的に書いています。1回書いて1回まるごと再利用すると通常の入力コストの1.35倍で、キャッシュを使わずに2回処理すると2倍です。
10回のリクエストで1回の書き込みと9回の読み取りなら2.15倍、キャッシュなしなら10倍だとも書いています。
この倍率から読み取れるのは、1度も再利用されなければ、割増を払っただけで終わるということです。これは出典が述べている文ではなく、公表された倍率からの読み取りです。
一度きりの長い資料を読ませる使い方では、キャッシュが費用を下げるとは限りません。
キャッシュはいつまで残るのか
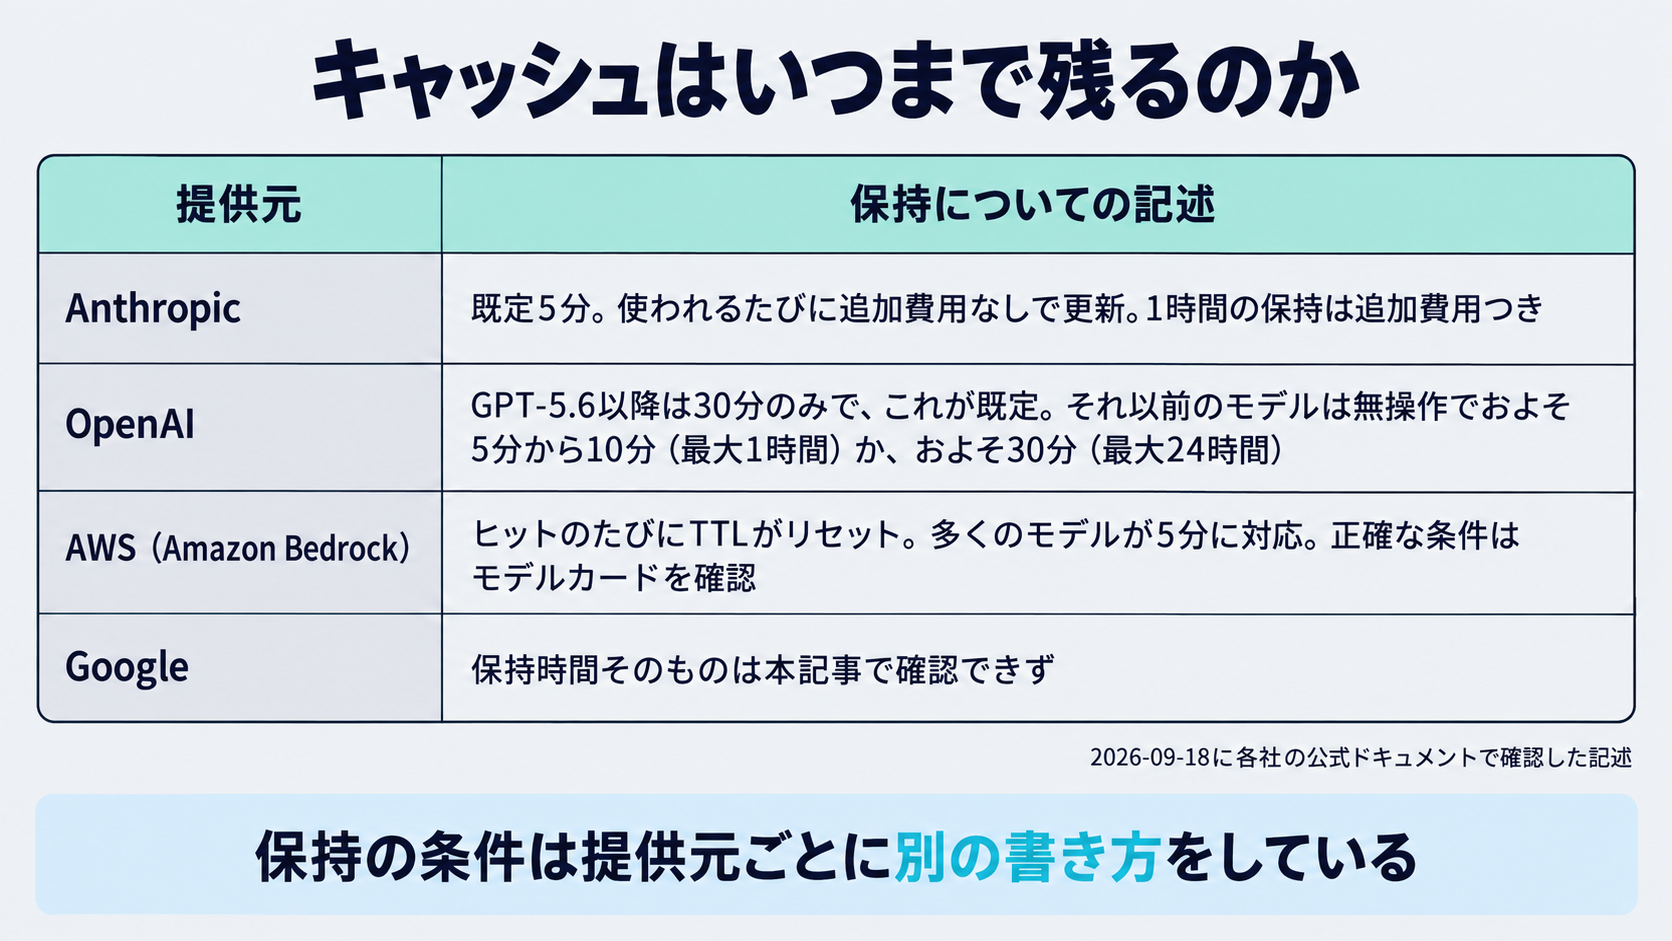
Anthropicは、既定のキャッシュ寿命を5分とし、キャッシュされた内容が使われるたびに追加費用なしで更新されると書いています。
同社は、寿命の計測がレスポンスの終了時ではなくリクエストの開始時点からであることも注記しています。応答生成に4分かかった場合、次のリクエストはその完了からおよそ1分以内に始める必要があるという例を挙げています。
5分では短い場合には、1時間の保持が追加費用つきで提供されるとしています。
OpenAIは、GPT-5.6以降で設定できる値が30分のみで、これが既定でもあると書いています。直近の書き込みか再利用から30分は再利用の対象で、それより長く保持されることもあるとしています。
それ以前のモデルには、無操作でおよそ5分から10分、最大1時間という設定と、およそ30分、最大24時間という拡張の設定が示されています。
ただし同社のモデル比較表は、この2つの両方に対応するモデルと、長い側だけに対応するモデルがあると書き分けています。
AWSは、TTLがキャッシュヒットのたびにリセットされ、その間にヒットがなければ期限切れになると書いています。多くのモデルが5分のTTLに対応し、正確な条件はモデルカードで確認するという書き方です。
Googleについては、料金ページに1時間あたりの保存料金が載っていることまでを確認しました。明示的なキャッシュ保存の保持時間そのものは、本記事で確認した範囲では確認できていません。
以下は、2026年9月18日に各社の公式ドキュメントで確認した保持についての記述です。
| 提供元 | 保持についての記述 |
|---|---|
| Anthropic | 既定5分。使われるたびに追加費用なしで更新。1時間の保持は追加費用つき |
| OpenAI | GPT-5.6以降は30分のみで、これが既定。それ以前のモデルは無操作でおよそ5分から10分(最大1時間)か、およそ30分(最大24時間)で、対応する値はモデルで分かれる |
| AWS(Amazon Bedrock) | ヒットのたびにTTLがリセット。多くのモデルが5分に対応。正確な条件はモデルカードを確認 |
| 料金ページに100万トークン・1時間あたりの保存料金の記載。保持時間そのものは本記事では確認できず |
この表は各社の書き方をそのまま並べたもので、横に比べて優劣を出すためのものではありません。
短いプロンプトでも効くのか
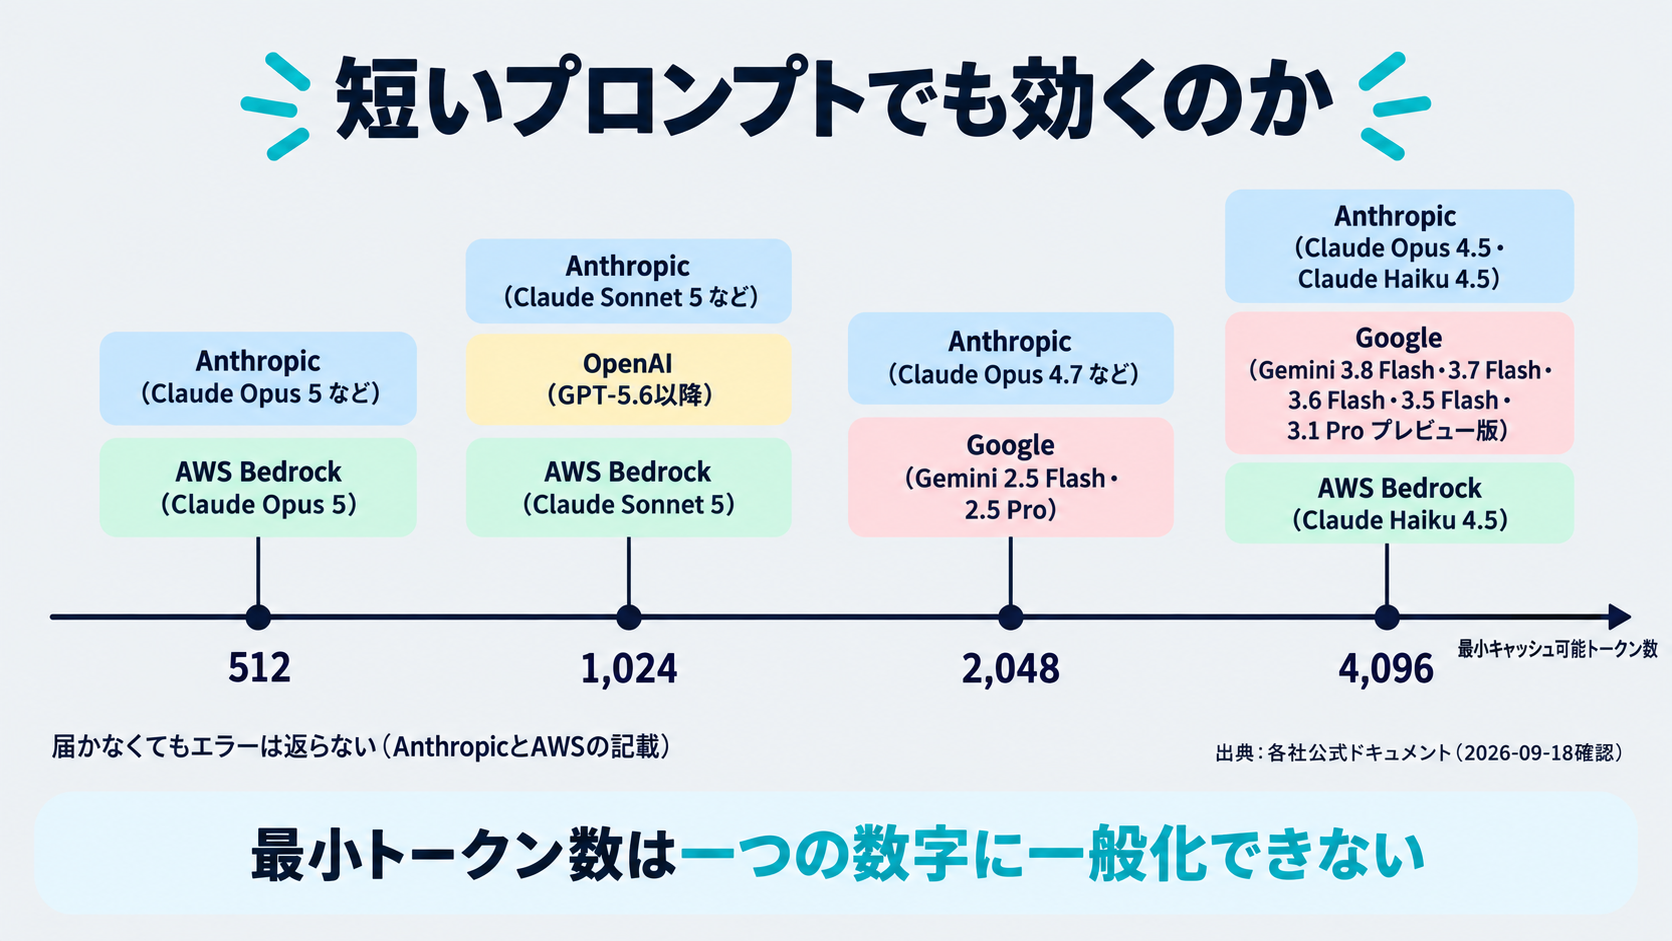
どの提供元も、一定の長さに届かないとキャッシュしないという条件を置いています。そして、その長さが提供元とモデルで違います。
Anthropicは最小キャッシュ可能長をモデル別に列挙しています。
- 512トークン(Claude Opus 5 など)
- 1,024トークン(Claude Sonnet 5 など)
- 2,048トークン(Claude Opus 4.7 など)
- 4,096トークン(Claude Opus 4.5 と Claude Haiku 4.5 など)
OpenAIは、GPT-5.6以降で1,024トークンとし、それ以前のモデルではリクエストの設定で変わると書いています。
Googleは、コンテキストキャッシュ保存の最小入力トークン数を表で示しています。2026年9月18日に確認した英語版の表には、7モデルが載っていました。
- 4,096トークン(Gemini 3.8 Flash・Gemini 3.7 Flash・Gemini 3.6 Flash・Gemini 3.5 Flash・Gemini 3.1 Pro プレビュー版)
- 2,048トークン(Gemini 2.5 Flash・Gemini 2.5 Pro)
同じURLでも、日本語の環境では日本語版に切り替わり、2026年7月30日時点の4モデルのままでした。どちらを見ているかで数が変わります。
AWSは、Bedrock上のキャッシュチェックポイントについて、モデルごとの最小トークン数の例を挙げています。
Claude Opus 5 が512トークン以上、Claude Sonnet 5 が1,024トークン以上、Claude Haiku 4.5 が4,096トークン以上という例です。
本記事が確認した範囲では、512から4,096まで分かれていました。ひとつの数字に一般化できません。
こわいのは、届かなかったときの挙動です。
Anthropicは、最小に満たないプロンプトは指定を付けてもキャッシュされず、エラーは返らないと書いています。AWSも、最小を満たさない位置に区切りを置いても推論自体は成功するが、プレフィックスはキャッシュされないとしています。
黙って効かないまま動くということです。請求を見るまで気づけません。
何トークンがどれくらいの分量なのかという感覚は、コンテキストウィンドウの記事で扱いました。

どう並べるとキャッシュが効くのか
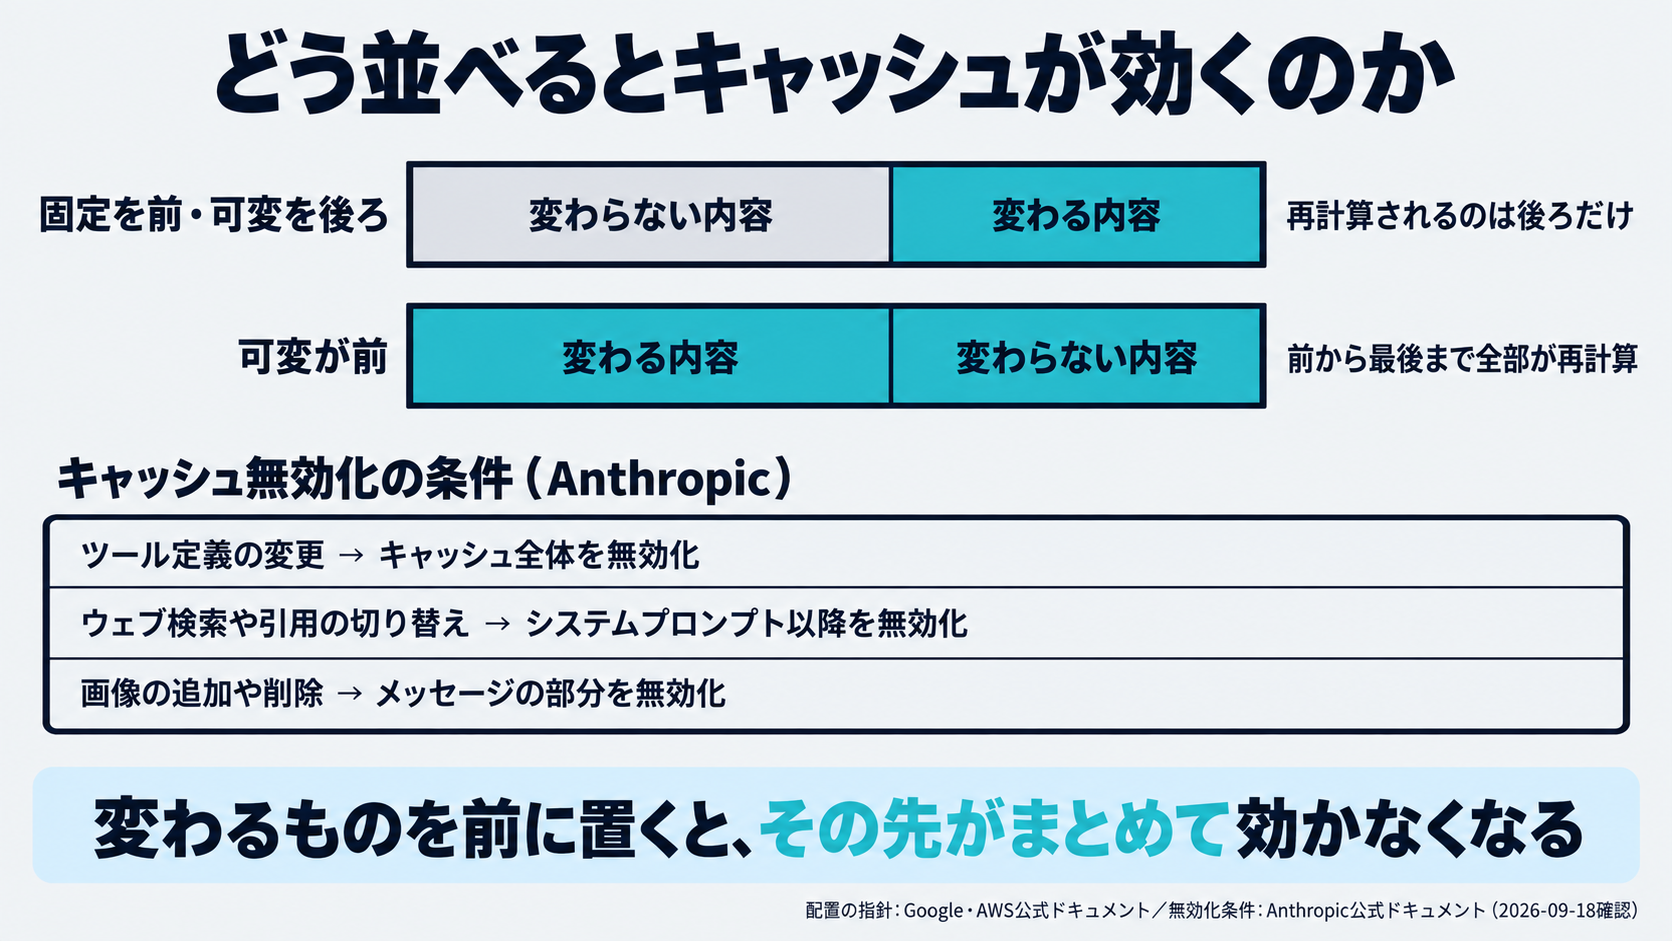
再利用されるのは先頭部分だけなので、変わらないものを前に、変わるものを後ろにという並べ方になります。
Googleは、ヒットの可能性を高める方法として、大規模で一般的なコンテンツをプロンプトの先頭に置き、類似した接頭辞を含むリクエストを短時間で送ることを挙げています。
AWSも、静的な内容をプロンプトの先頭に、動的な内容を末尾に置くことで、先頭部分が完全一致する可能性が高まるとしています。
OpenAIは、プレフィックス全体が一致しないと再利用されないと書いています。区切りより前の内容や関連する設定が変われば、その先は既存のエントリに一致しません。
Anthropicは、何がキャッシュを無効化するかを表で示しています。ツール定義の変更はキャッシュ全体を無効化し、ウェブ検索や引用の切り替えはシステムプロンプト以降を無効化し、画像の追加や削除はメッセージの部分を無効化するという整理です。
毎回同じ文言を前に置くという運用が効いてくるのは、この条件があるからです。固定の指示をどこに置くかは、システムプロンプトの記事で扱いました。
逆に、先頭へ現在時刻のような毎回変わる値を入れると、その先が一致しなくなります。Anthropicの説明では、区切りまでの内容から作られるハッシュが変われば、次のリクエストでは別のハッシュになります。
同じ内容を送れば必ず効くのか
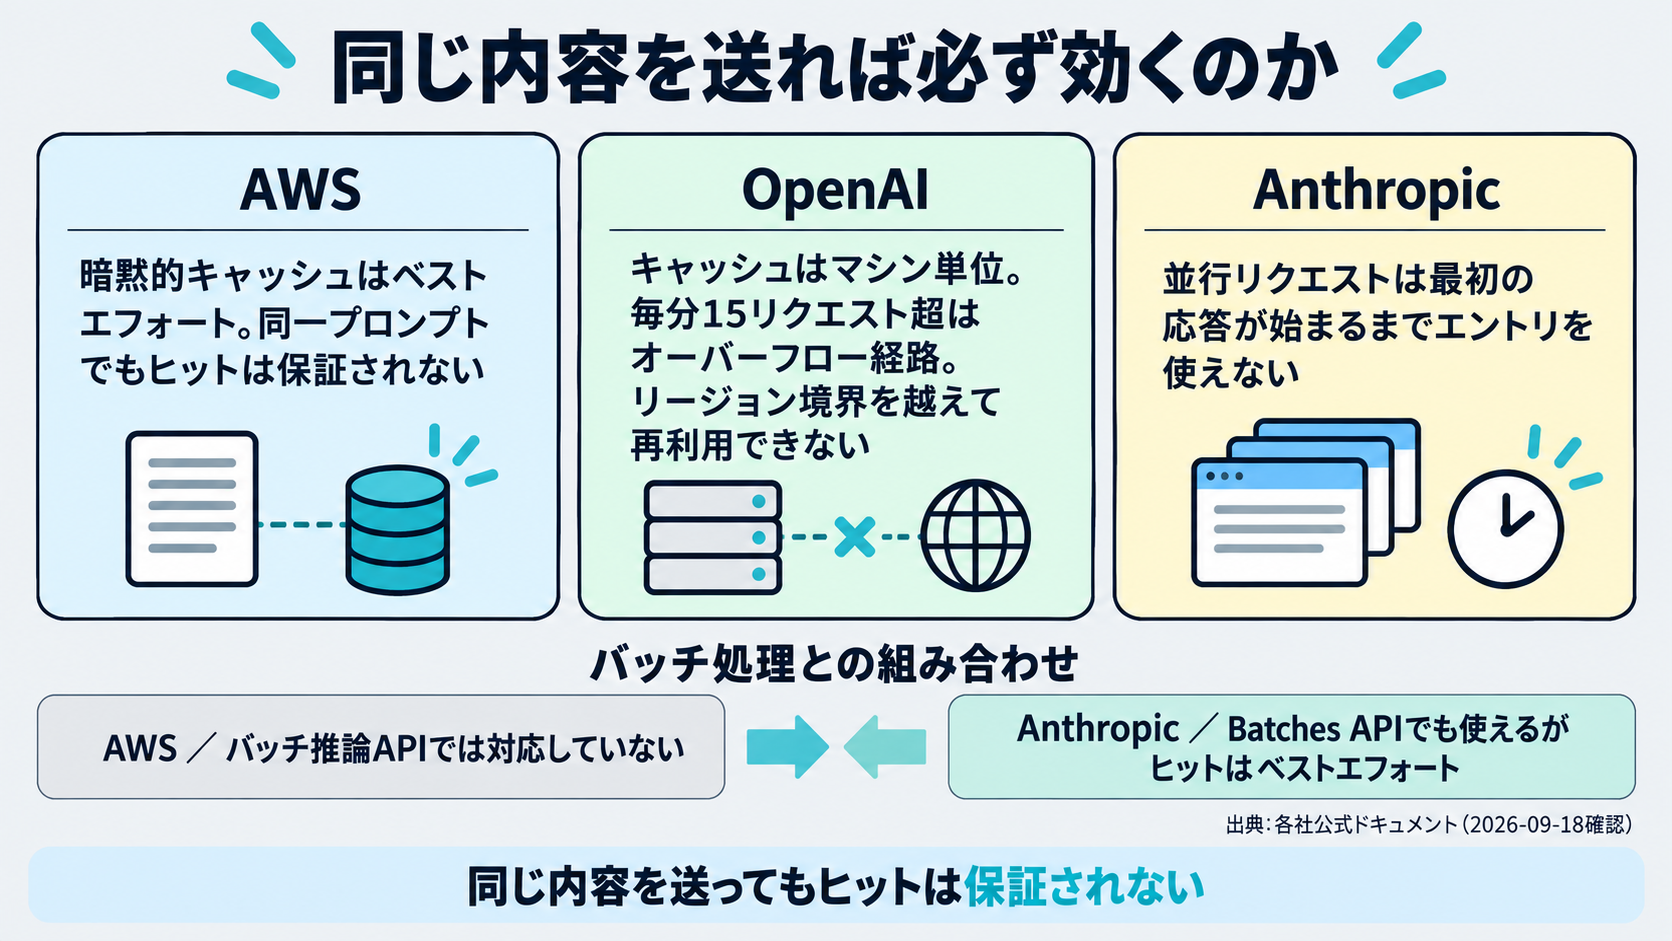
本記事で開いた一次情報のうち、必ず効くと書いたものはありませんでした。
AWSはこの点をはっきり書いています。暗黙的キャッシュはベストエフォートであり、同一のプロンプトを繰り返してもキャッシュヒットは保証されず、ヒット率は変動しうるとしています。
同社はさらに、プロンプトキャッシュへの対応はどのリクエストについてもキャッシュヒットを保証しないとも書いています。
OpenAIは、その理由になりうる事情を挙げています。キャッシュ状態は個々のマシン上に置かれ、毎分15リクエストを超えるトラフィックはオーバーフロー経路に回されうるという説明です。
同社は、キャッシュが組織をまたいで共有されず、処理リージョンの境界を越えて再利用できないとも書いています。
Anthropicは、並行して投げたリクエストについて、最初のレスポンスが始まってからでないとキャッシュエントリは使えないとしています。
もうひとつ、費用を下げる手段どうしを重ねられるかという論点があります。バッチ処理との組み合わせです。可否は提供元で分かれます。
ここは提供元で記述が逆になります。AWSは、プロンプトキャッシュがオンデマンド推論エンドポイントでのみ対応し、バッチ推論APIでは対応していないと書いています。
一方でAnthropicは、Batches APIでもプロンプトキャッシュは使えるとしたうえで、非同期のバッチ要求は同時かつ任意の順で処理されうるため、ヒットはベストエフォートで提供されると書いています。
同社は、キャッシュの料金倍率がBatch APIの割引などの価格要素と重ねて効くとも注記しています。重ねられるかどうかと、ヒットするかどうかは別の話です。
複数の提供元を切り替えて使う構成については、AIゲートウェイの記事で扱いました。提供元が変われば、ここまでの条件もそのつど変わります。

効いているかどうかは、どこで確かめるのか
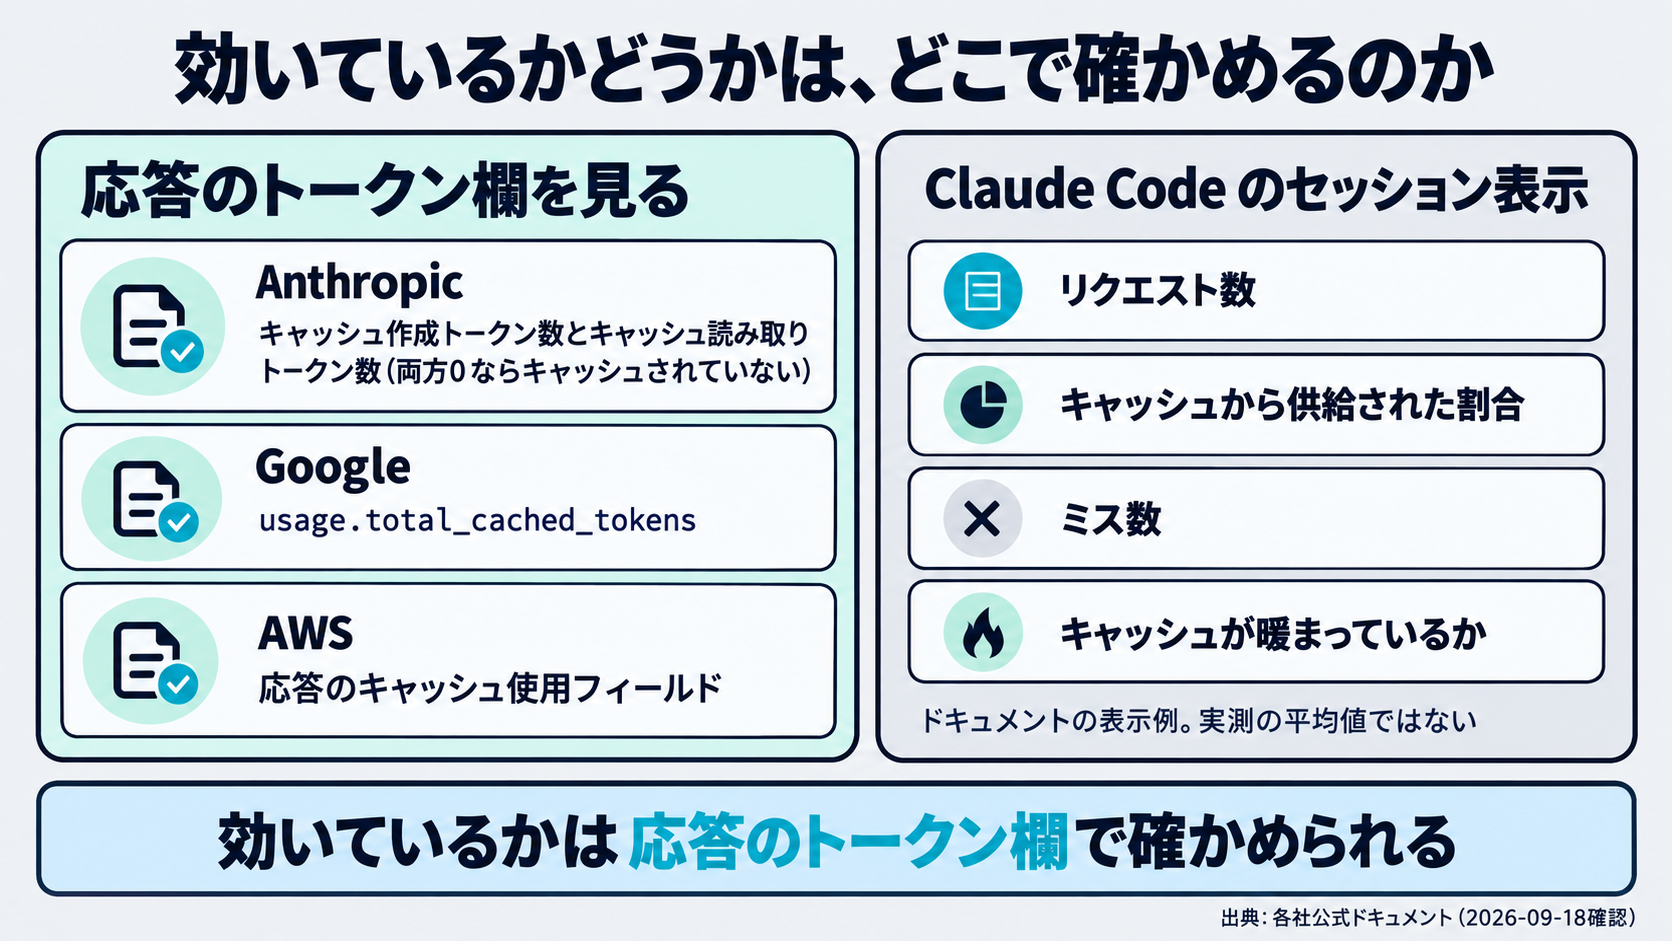
各社とも、応答のトークン欄で確認する方法を用意しています。
Anthropicは、応答のキャッシュ作成トークン数とキャッシュ読み取りトークン数が両方とも0なら、そのプロンプトはキャッシュされていないと書いています。最小の長さに届かなかった場合が理由として挙げられています。
Googleは、ヒットしたトークン数をレスポンスのキャッシュ済みトークン数の欄で確認できるとしています。
AWSは、応答のキャッシュ使用フィールドで、トークンがキャッシュから読まれたか書き込まれたかを確認するよう書いています。
この欄を読んで画面に出す道具もあります。
Anthropicは、Claude Codeがセッションの表示にプロンプトキャッシュの行を足すと説明しています。
そこに並ぶのは、リクエスト数、入力トークンのうちキャッシュから供給された割合、ミス数、いまキャッシュが暖まっているかの4つです。
同社のドキュメントは、その行の表示例として、リクエスト数と割合とミス数が並ぶ1行を載せています。これは表示形式を示す例であり、実測の平均値ではありません。
同社は、この数値がAPI応答のキャッシュトークン欄から取られているため、この行はどの提供元やゲートウェイでも動くと書いています。
一方で、ChatGPTやClaudeのチャット画面だけを使う人が、プロンプトキャッシュを自分で操作したり確認したりする設定は、本記事で確認した範囲では見つかりませんでした。
ここまでに引いた各社の文書は、いずれもAPIの利用者に向けたものです。
会社で使うとき、預けた内容の扱いはどうなっているのか
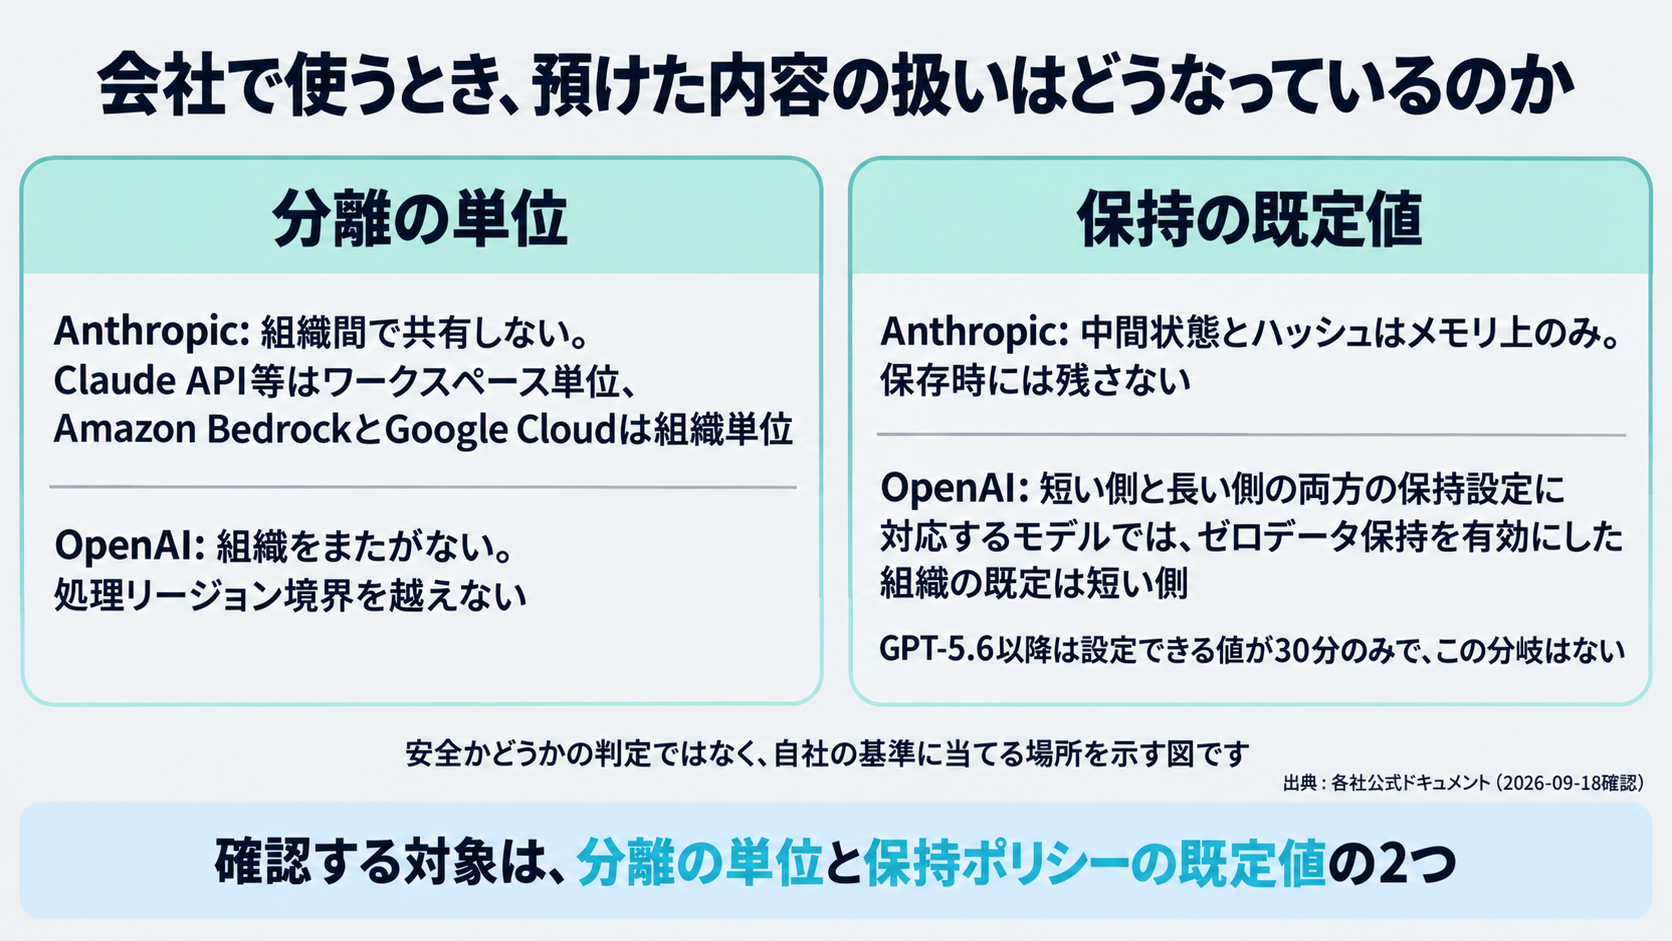
キャッシュは入力の途中結果を提供元の側に置く仕組みなので、誰と共有されるのかが気になります。
ここで可否を判定することはできません。自社の基準に当てて確認する対象がどこにあるかまでを書きます。
Anthropicは、組織間でキャッシュは共有されないと書いています。同一のプロンプトであっても、組織が違えば共有されないという書き方です。
同社はさらに分離の粒度も書き分けています。
Claude API・Claude Platform on AWS・Microsoft Foundry ではワークスペース単位、Amazon Bedrock と Google Cloud では組織単位で分離されるとしています。
保持の形についても記述があります。中間状態とその内容のハッシュはメモリ上にのみ保持され、保存時には残さないとし、エントリは最短5分(標準)または1時間(拡張)の後に速やかに削除されるとしています。
OpenAIも、キャッシュが組織をまたいで共有されないと書いています。
同社は保持設定の既定も開示しています。ただしこれは、短い側と長い側の両方の保持設定に対応するモデルについての記述です。
そのモデルでは、ゼロデータ保持を有効にした組織の既定が短い側になり、有効にしていない組織の既定は長い側になるとしています。
GPT-5.6以降は設定できる値が30分のみなので、この分岐はありません。自社がどの世代を使っているかで、見る場所が変わります。
ゼロデータ保持そのものについては、ゼロデータ保持(ZDR)の記事で扱いました。
社内の基準に当てて確認するとき、この2点が見どころになります。どの単位で分離されるかと、自社の保持ポリシーが既定値を変えるかです。
結局、プロンプトキャッシュは自分に効くのか
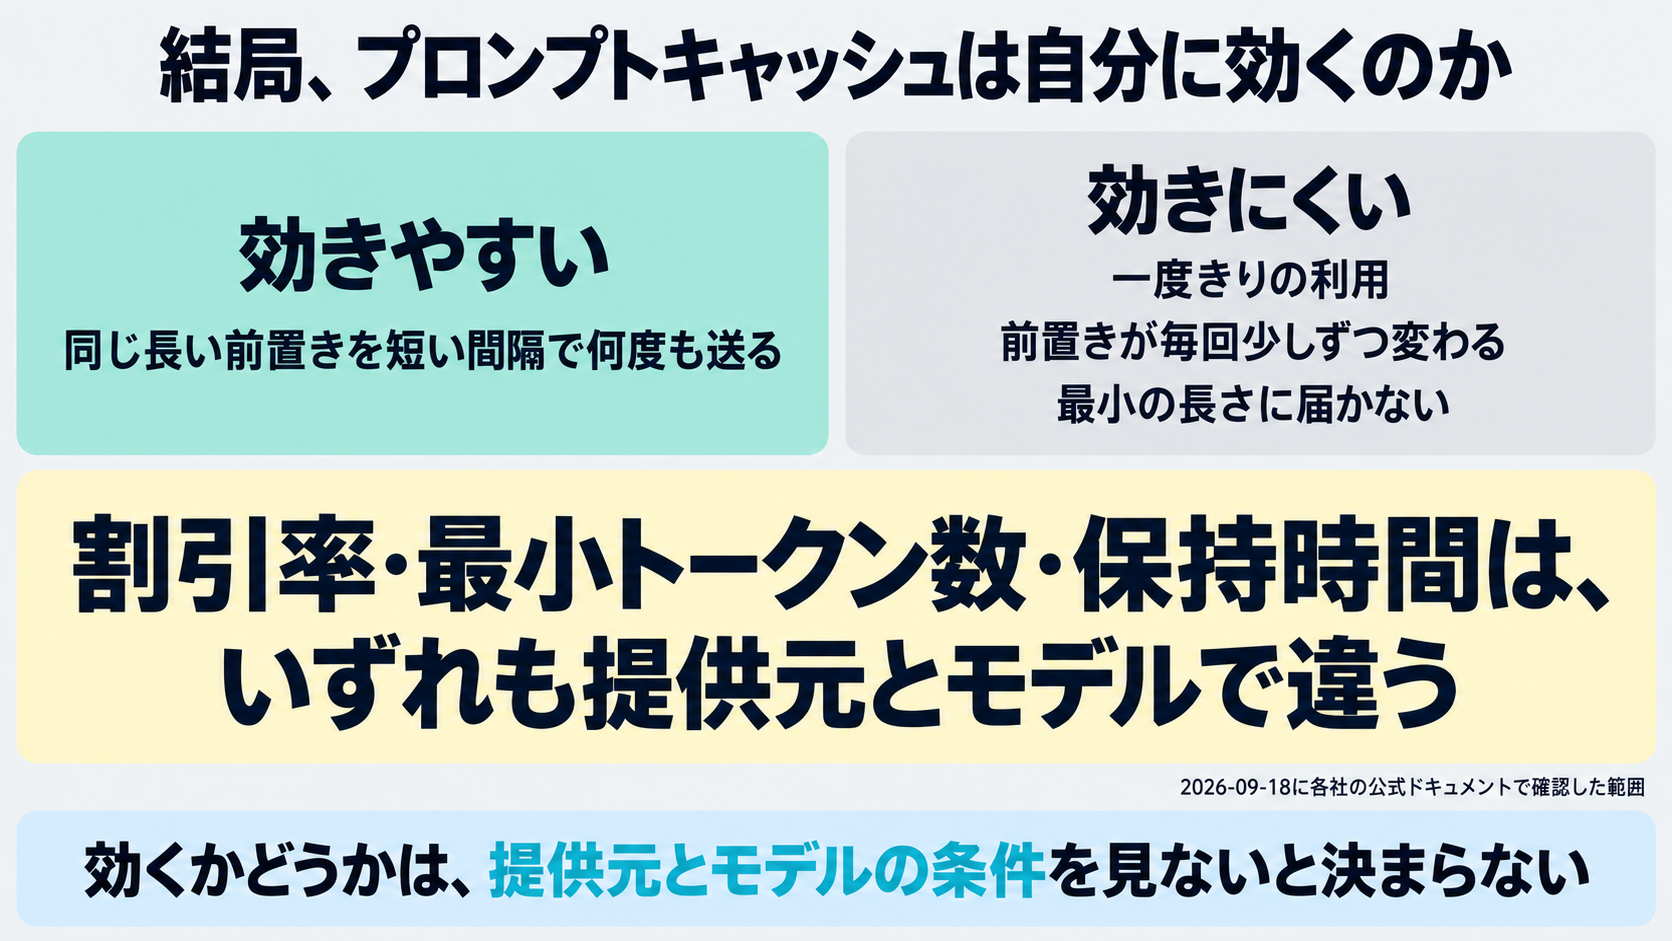
効きやすいのは、同じ長い前置きを短い間隔で何度も送る使い方です。書き込みの割増を払っても、再利用が重なれば取り返せるという構造になっています。
効きにくいのは、一度きりの利用と、前置きが毎回少しずつ変わる作りと、最小の長さに届かない短いプロンプトです。
そして、どれも提供元とモデルで条件が違います。本記事に並べた数値は、2026年9月18日に各社の公式ドキュメントで確認したものです。自分が使っている提供元とモデルの記述を、そのつど確かめてください。
費用を下げる道は、キャッシュだけではありません。モデルそのものを軽くする方向については、LLMの量子化の記事で扱いました。
社内のどこまでを生成AIに任せるか、どの提供元を選ぶかといった段階でお困りでしたら、お問い合わせからご相談ください。
この記事の出典
- Prompt caching(OpenAI Platform Docs、2026-09-18確認)
- Prompt caching(Anthropic Claude Docs、2026-09-18確認)
- Manage costs(Anthropic Claude Code Docs、2026-09-18確認)
- Context caching(Google AI for Developers、2026-09-18に英語版を確認。最終更新日は2026-09-02 UTC。日本語版は2026-07-30 UTCのまま)
- Gemini Developer API pricing(Google AI for Developers、2026-09-18確認)
- Prompt caching for faster model inference(Amazon Bedrock User Guide、2026-09-18確認)
この記事は役に立ちましたか?
感想は、今後の記事改善に活用します。
関連記事
ナレッジカットオフとは?AIが古い情報のまま答える理由|カットオフは1つとは限りません
ナレッジカットオフは、AIが学習に使ったデータの新しさの境目を指す言葉です。経理や検査のカットオフとは別の言葉です。同じモデルについて2つの日付を公表している例や、分野によって知識の新しさが違うと注記している例を、AnthropicとGoogleの公式ドキュメントとモデルカードから帰属つきで整理しました。
A2Aプロトコル(Agent2Agent)とは?MCPとの違いは「つなぐ相手がツールかエージェントか」|v1.0はいつ出たか
A2Aプロトコル(Agent2Agent)は、別々のベンダーが作ったAIエージェント同士をつなぐためのオープン標準です。決済分野でいうA2A(口座間の直接送金)とは別の言葉です。MCPとの関係、仕様がv1.0になった時期、試す前の確認点を、A2AとMCPの公式ドキュメントおよび公式ブログから整理しました。
知識蒸留とは?大きいモデルの答えで小さいモデルを訓練する仕組み|量子化との違いと「禁止」と検索される理由
知識蒸留は、大きいモデルに答えを出させ、その答えで小さいモデルを訓練する手法です。お酒や化学の蒸留とは別の話です。量子化や枝刈りとの違いと、OpenAI・Google・Anthropic・Metaの契約・規約・ライセンスに実際に書かれている文言を、それぞれが誰に向けた文書かも添えて、原論文と各社の公式ドキュメントから整理しました。
llms.txtとは?AI向けの案内ファイルの提案|標準規格ではなく、Google検索は「使用しない」と明記
llms.txtは、AIエージェント向けにサイトの要約とリンクをMarkdownで置こうという提案です。原文が自らを「提案」と呼んでおり、標準規格ではありません。robots.txtとも目的が違います。現行版(v2)の原文と、Google検索セントラルの記述を確認日つきで整理しました。
次のAIツール選びへ
気になるツールを並べて、料金や特徴の違いを確認できます。