ゼロデータ保持(ZDR)とは?「学習されない」と「保存されない」は別の話|提供元の公式文書で確認する
事業部から「業務で生成AIを使いたい」と相談され、入力する社内資料の扱いを確認することになる場面があります。
提供元の案内を読むと、学習に使わないという説明と、データを保持しないという説明が、別々の場所に出てきます。
この記事では、ゼロデータ保持(ZDR)が何を指すのか、学習に使わないという説明と何が違うのかを、提供元の公式文書をたどって解説します。
この記事では、各社の公式ドキュメントで確認できた範囲を、学習と保存に分けて整理します!
この記事の監修者
AIリスキル株式会社 代表取締役
AIツールギャラリーを運営するAIリスキル株式会社の代表取締役。企業・自治体向けの生成AI研修とAI導入支援を手がけています。
実績: 大阪・関西万博 公式プログラム「AI HEROES COLLECTION」司会進行 / 神戸市デジタル人材育成エコシステム構築事業の運営 / MBS「せやねん!」「よんチャンTV」に生成AIの専門家として出演 / Felo日本初コアアンバサダー / Genspark第1期公式アンバサダー / Skywork公式アンバサダー / AKOOL公式パートナー など
ゼロデータ保持(ZDR)とは何を指しますか
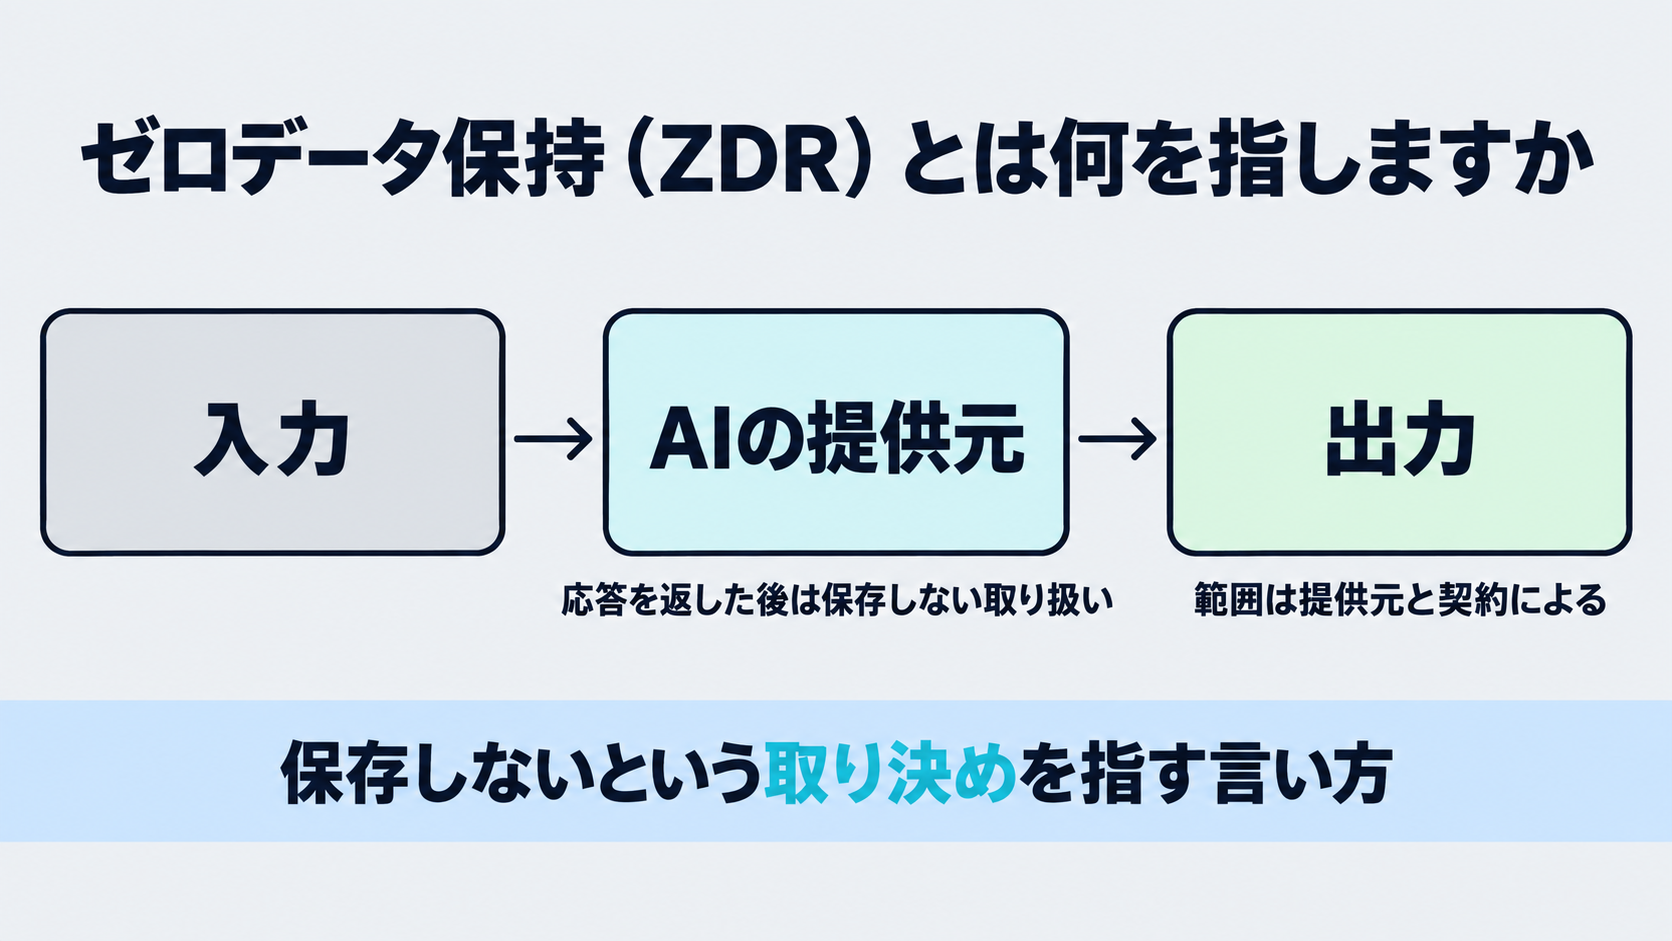
ゼロデータ保持は、AIの提供元が、応答を返した後に入力と出力を保存しない取り扱いを指す言い方です。英語のZero Data Retentionを略して、ZDRと書かれることもあります。
ただし、どこまでを保存しないかは提供元と契約の条件で変わります。本記事では一般的な定義を置かず、各社の公式文書に書かれている内容を確認します。
提供元は何と説明していますか
OpenAIは2026年8月19日の記事で、ゼロデータ保持を対象となるAPI顧客への約束と位置づけ、リクエストの処理後にプロンプトやモデルの応答を保持しないと説明しています。
Anthropicは、APIのデータ保持に関する文書で、ZDRの取り決めの下ではAPI応答を返した後に顧客のプロンプトと応答を保存しないと説明しています。
なぜ「取り決め」という言い方になるのですか
どちらの説明も、画面から切り替える機能としてではなく、対象となる顧客や組織との取り決めとして書かれています。Anthropicの文書は、ZDRを組織ごとに有効化するものとし、営業担当へ依頼する流れを案内しています。
つまり、OpenAIとAnthropicの文書では、ZDRは製品に最初から付いてくる設定として説明されていません。この点は、後半で保存の範囲を読むときに効いてきます。
「学習されない」と「保存されない」はなぜ混ざるのですか
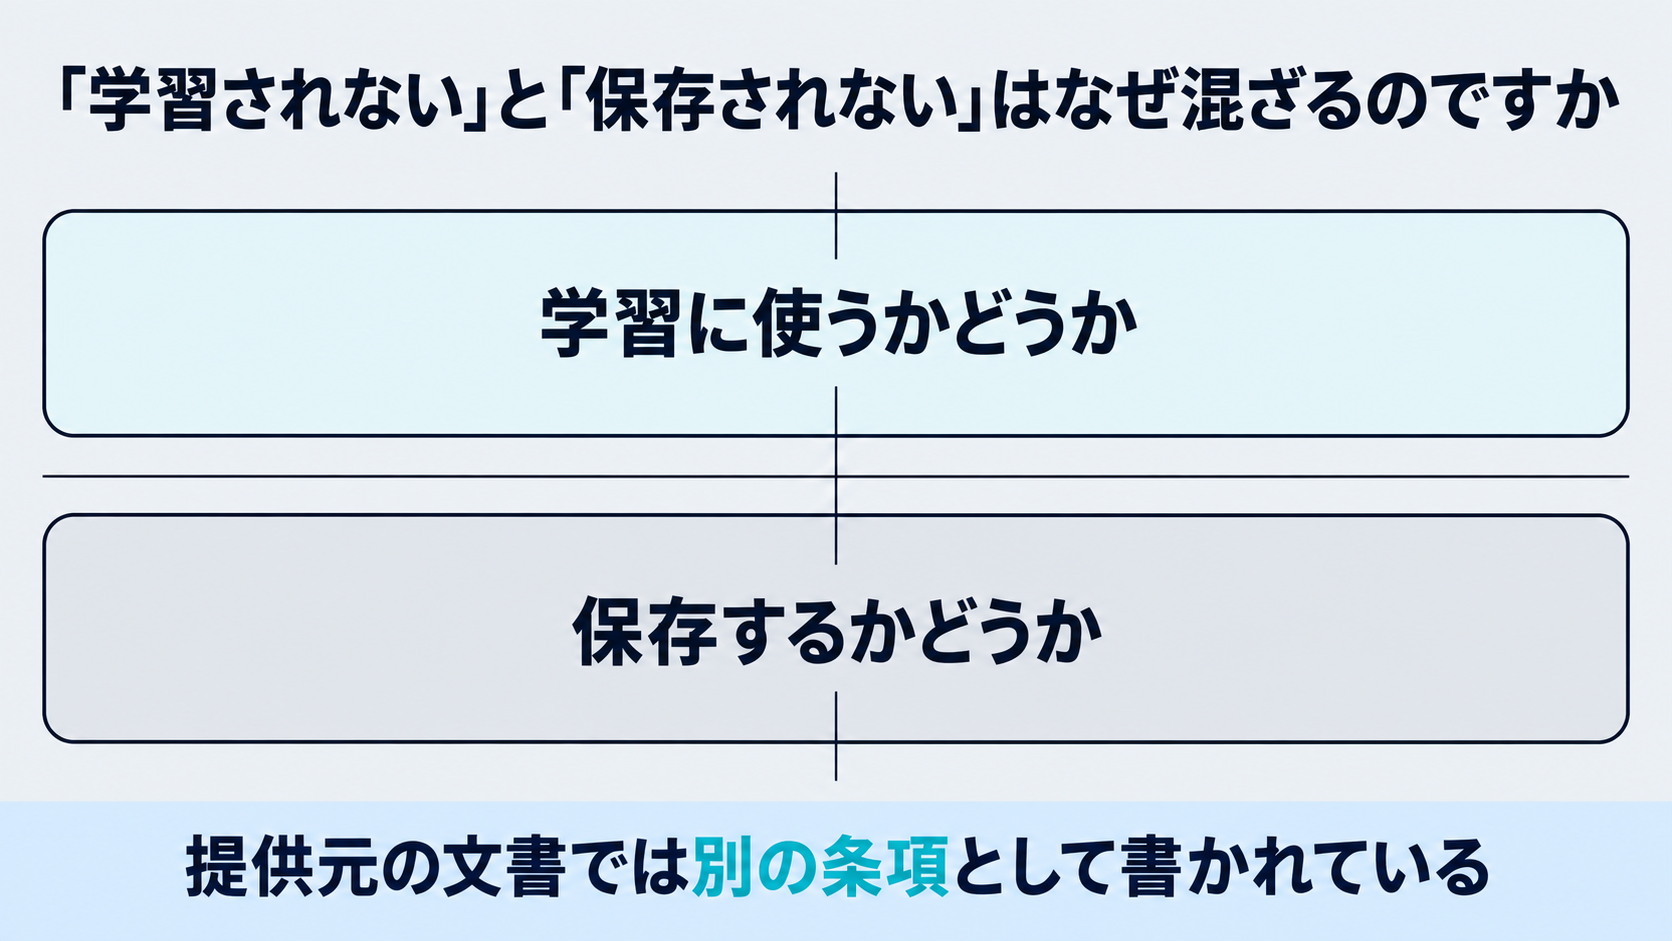
この2つは、日本語の解説でもよく並べて説明されます。ただし提供元の文書では、学習に使うかどうかと、保存するかどうかが、別の条項として書かれています。
混ざったまま読むと、学習に使われないならどこにも残らない、という結論へ飛びやすくなります。提供元の説明は、そこまでは書いていません。
学習をオフにしても会話が残る場合があります
OpenAIのヘルプセンターは、ChatGPTで「Improve the model for everyone」をオフにする手順を案内したうえで、会話は履歴に残るがChatGPTの学習には使われないと明記しています。
これは、学習に使わせない設定が保存をやめる設定ではないことを、提供元自身が書いている例です。ChatGPTの設定についての記述であり、他社や他のプランへ一般化はできません。
履歴を消すことと学習に使わせないことも別です
Anthropicの消費者向けの案内は、会話を削除すると履歴からは即座に消え、バックエンドの保存からは30日以内に削除されると説明しています。
同じページは、学習への利用を許可していた場合、すでに進行中の学習や学習済みのモデルからは取り除かれないとも書いています。削除と学習の停止は、効く範囲が違います。
設定画面で切り替える操作は本記事では扱いません
本記事は、提供元の公式文書を読んで、学習の扱いと保存の扱いを分けて確認する記事です。
利用者が自分の設定画面で学習利用をオフにする操作は、サービスごとに設定名と場所が変わるため、本記事では手順を扱いません。
手順を探す前に決めることは、本記事の後半と同じです。どの製品の、どのプランで、どの経路から使うのかを先に特定してから、対応する案内を読みます。
提供元は学習について何を説明していますか
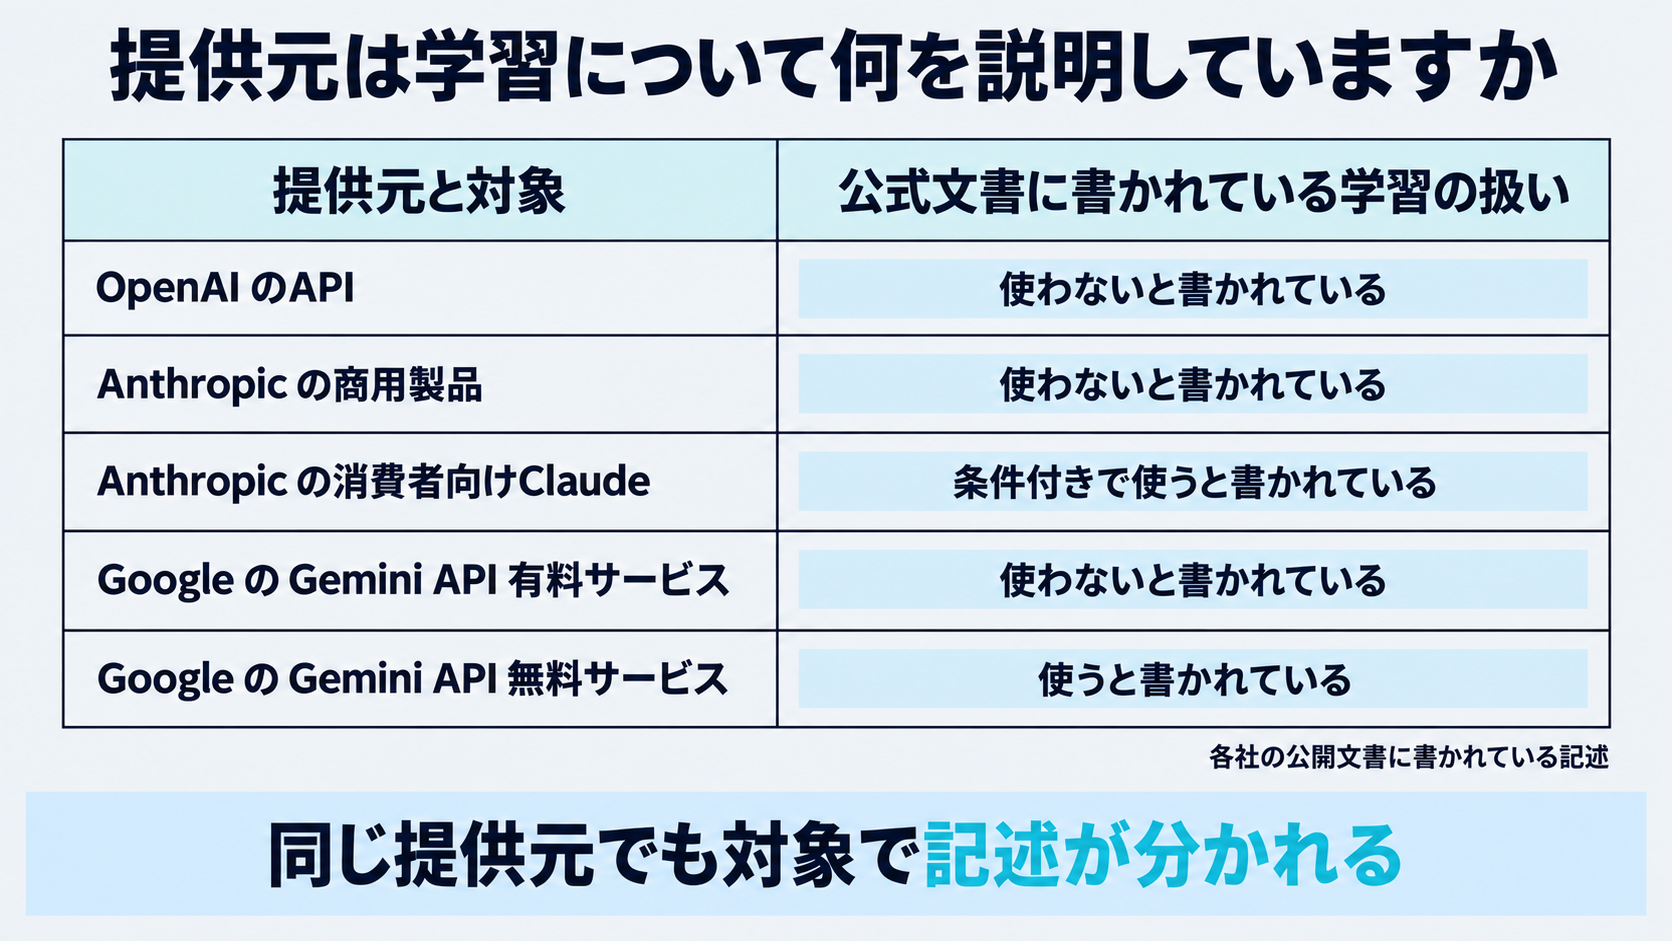
ここでは学習だけを取り出して並べます。保存については次の見出しで扱います。
| 提供元と対象 | 公式文書に書かれている学習の扱い |
|---|---|
| OpenAI のAPI | 2023年3月1日以降、APIへ送られたデータはモデルの学習・改善に使わない(明示的にオプトインした場合を除く) |
| Anthropic の商用製品 | 保持したデータは、明示的な許可なしにモデルの学習に使わない |
| Anthropic の消費者向けClaude | 利用者が許可した場合や、安全性のレビューでフラグが立った場合などに使う |
| Google の Gemini API 有料サービス | プロンプトや回答をプロダクトの改善に使用しない |
| Google の Gemini API 無料サービス | 送信したコンテンツと回答を、プロダクト、サービス、機械学習技術の提供、改良、開発に使用する |
この表は、各社の公開文書に書かれている記述を並べたものです。自社の契約に同じ条件が適用されるかは、契約書と提供元の案内で確認します。
無料と有料で説明が分かれる例があります
GoogleのGemini API追加利用規約は、無料サービスと有料サービスで、データの利用方法の条項を分けて書いています。無料サービスについては、品質向上のために人間のレビュアーが入出力を確認する場合があるとも記載しています。
同じ規約は、無料サービスにプライベート情報、機密情報、個人情報を送信しないよう求めています。同じAPIでも、課金の状態によって読むべき条項が変わります。
学習を許可する選択は保存期間にも及ぶ例があります
Anthropicの消費者向けの案内は、学習への利用を許可した場合、識別子を外した形で最長5年間、学習のパイプラインに保持されることがあると説明しています。
学習と保存は別の条項ですが、無関係でもありません。どちらか一方だけを見て結論を出すと、説明が抜けます。
「保存されない」はどこまでと説明されていますか
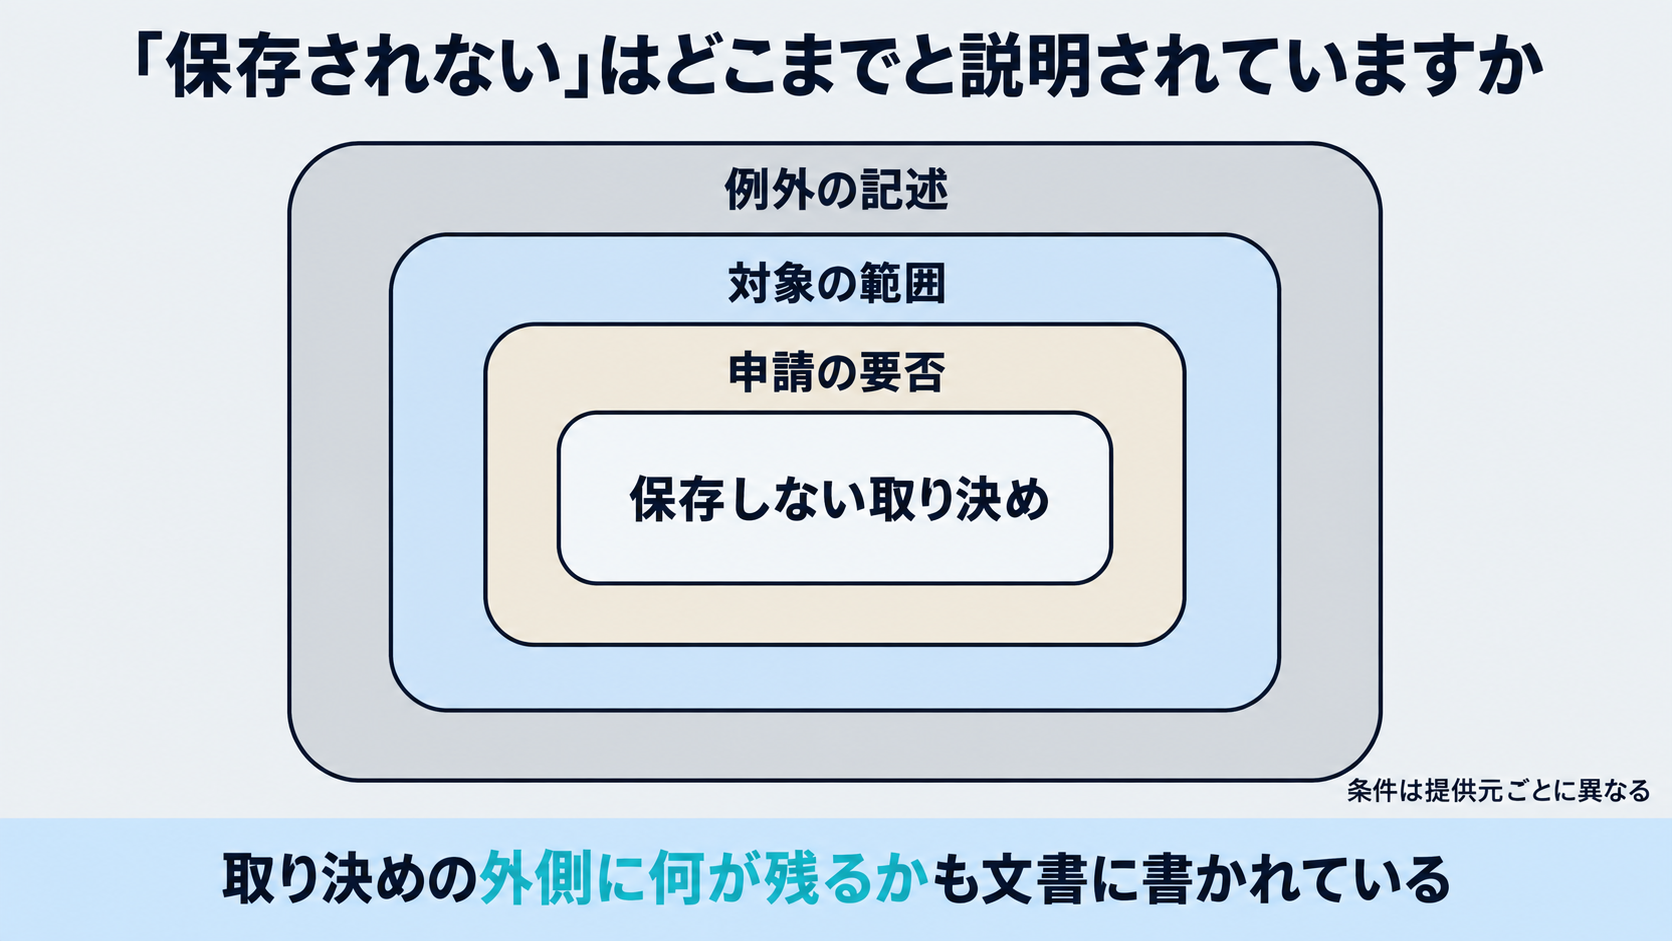
ここが、読み違えの起きやすい部分です。提供元の文書は、保存しない取り決めの外側に何が残るかも、あわせて書いています。
申請や契約が前提になる例があります
OpenAIのAPIのデータ管理に関する文書は、不正利用の監視ログを既定で最長30日保持すると書いています。そのうえで、ゼロデータ保持などの管理機能は、OpenAIの事前承認と追加要件の受諾が前提だと記載しています。
同じ文書は、ゼロデータ保持の対象になるエンドポイントと、対象にならないエンドポイントを一覧で分けています。どのAPIを使うかによって、同じ契約でも扱いが変わります。
取り決めの後にも保持されると書かれている場面があります
Anthropicの文書は、ZDRの取り決めがあっても、法令上必要な場合や、自動の信頼性・安全性システムでフラグが立った場合には、入力と出力を最長2年保持することがあると書いています。
同じ文書は、Claude Fable 5.1やClaude Fable 5などを対象モデルとして挙げ、30日のデータ保持が必要で、明示的な許可がない限りZDRでは利用できないと説明しています。
OpenAIの2026年8月19日の記事も、脚注で、児童の性的虐待にあたる可能性があるとしてフラグが付いた画像は、ゼロデータ保持の環境でも手動のレビューと報告のために保持されると書いています。
提供元によっては、ゼロにするために個別の対応が要ります
Google CloudのGemini Enterprise Agent Platformのドキュメントは、データの保持をゼロにするには領域ごとに特定のアクションが必要だと書いています。
そのうえで、一部の高度なAI機能を使っている場合は、保持期間をゼロにできないとも記載しています。
同じページは、Google検索によるグラウンディングのログが最長3日保存され、その保存を無効にできないことも挙げています。ひとつの切り替えで完結する説明にはなっていません。
社内で確認するときは何を見ますか
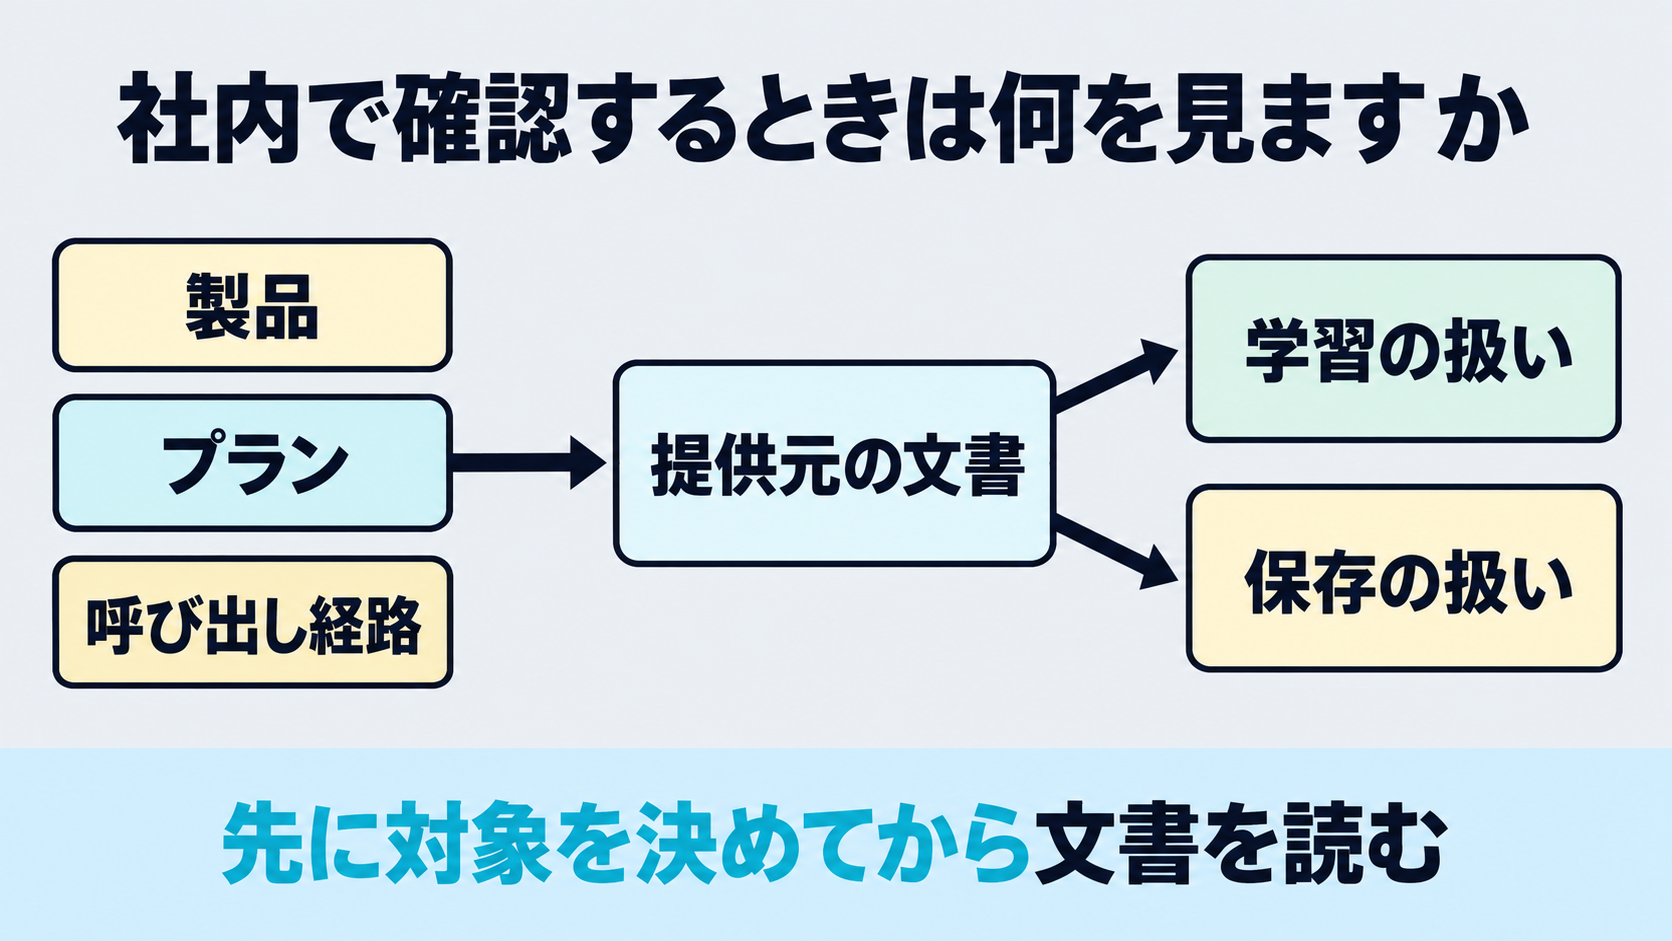
ここまでの内容は、どの会社にも同じように当てはまるものではありません。確認するのは、自社が実際に使う製品とプランについての、提供元の現在の案内です。
先に特定するのは製品・プラン・経路です
同じ提供元でも、消費者向けプラン、法人向けプラン、API、クラウド事業者経由の提供では、参照する文書が変わります。
Anthropicの文書は、Amazon BedrockとGoogle CloudのAgent Platformでの提供では、クラウド事業者がデータ処理者になると案内しています。
そのため、どの会社のAIかを決めるだけでは足りません。どのプランで、どの経路から呼ぶのかまで決めてから、対応する文書を読みます。
自社の文書へ書き写す前に確認します
確認した内容を社内へ伝えるときは、学習の扱いと保存の扱いを分けて書くと、後から読む人が誤解しにくくなります。例外として書かれている条件も、省かずに残します。
入力してよい情報の区分は機密情報とは、想定されるリスクの考え方は情報漏洩とはで確認できます。確認した結果を社内文書へまとめる段は、AI利用ポリシーとはへ渡します。
本記事は、特定のサービスが安全かどうかや、法令上問題がないかどうかを判断しません。必要な判断は、社内規程、提供元の公式案内、契約条件にもとづいて行います。
まとめ
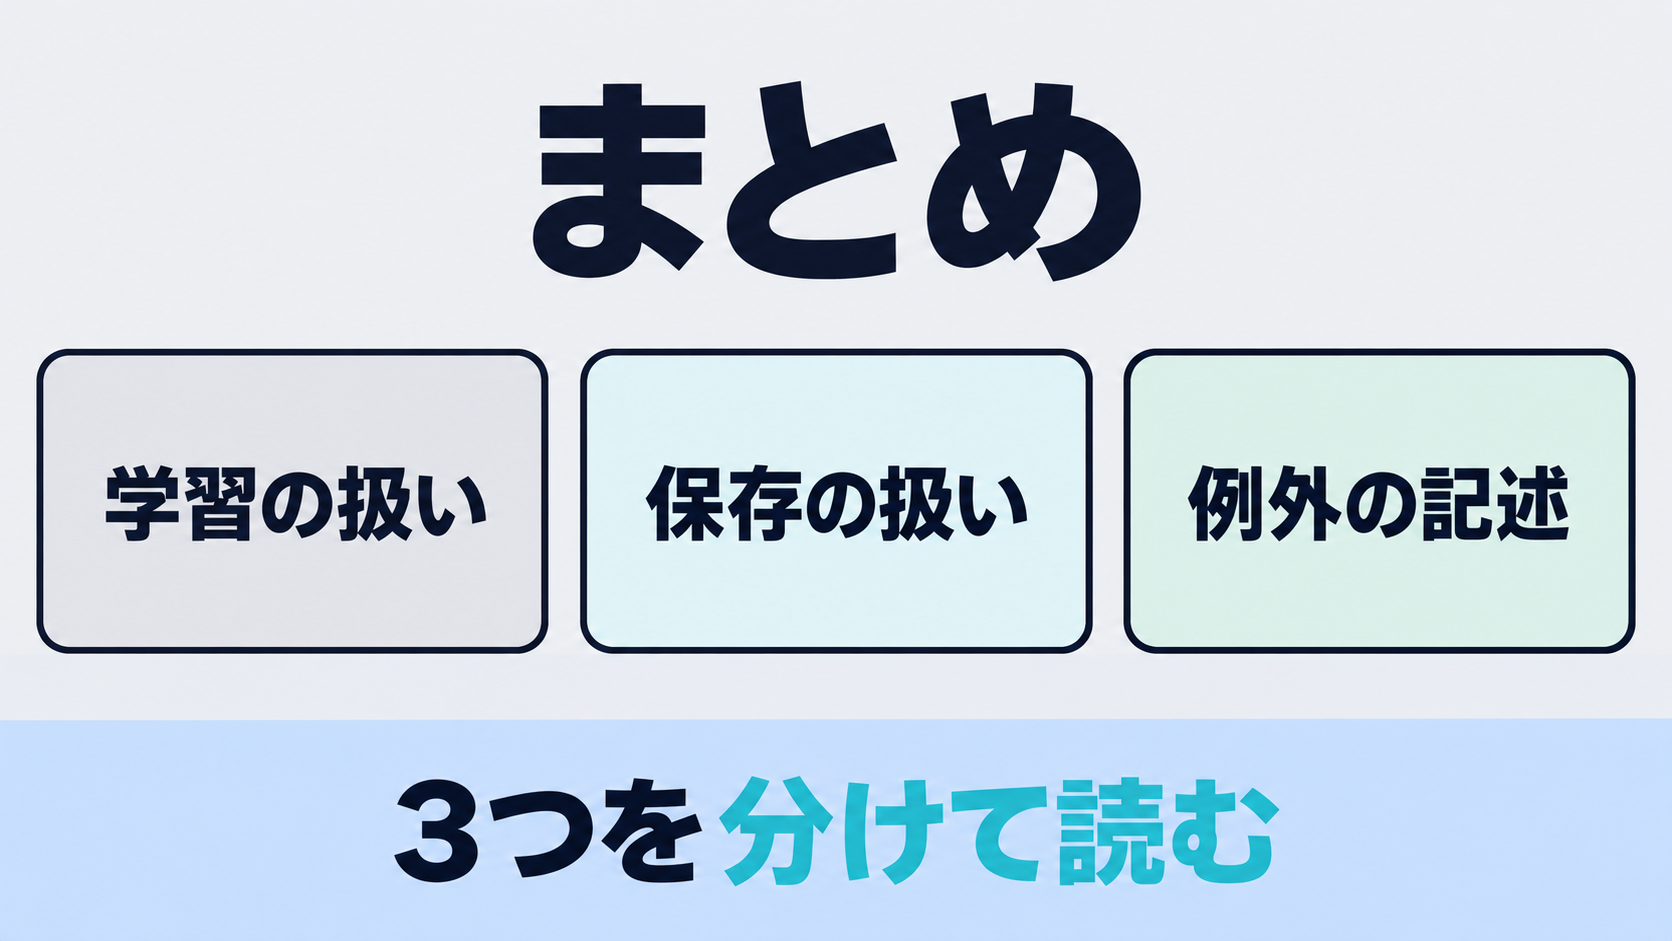
ゼロデータ保持(ZDR)は、応答を返した後に入力と出力を保存しない取り扱いを指す言い方です。提供元の文書では、学習に使うかどうかとは別の条項として書かれています。
学習に使わせない設定が保存をやめる設定ではないことは、OpenAIのヘルプセンターが明記しています。保存しない取り決めについても、申請の要否、対象の範囲、例外が各社の文書に書かれています。
社内で確認するときは、製品、プラン、呼び出し経路を先に特定し、学習と保存を分けて読みます。なお、本記事で扱っていない提供元やクラウド経由の提供については、本記事で確認した範囲では確認できませんでした。
AI導入時のデータの扱いを社内で整理したい企業の方へ
どのツールをどの範囲で使うかが決まると、確認すべき文書も絞れます。社内での進め方や利用の広げ方を具体化したい場合は、お問い合わせはこちらからご相談ください。
この記事の出典
- Data controls in the OpenAI platform(OpenAI、2026年9月18日確認)
- フロンティアモデルへのゼロデータ保持の提供(OpenAI、2026年8月19日、2026年9月18日確認)
- Data Controls FAQ(OpenAI、2026年9月18日確認)
- API and data retention(Anthropic、2026年9月18日確認)
- ゼロデータ保持(Anthropic、2026年9月18日確認)
- Is my data used for model training?(Anthropic、2026年3月17日、2026年9月18日確認)
- How long do you store my data?(Anthropic、2026年7月2日、2026年9月18日確認)
- Gemini API 追加利用規約(Google、2026年3月23日発効、2026年9月18日確認)
- Gemini Enterprise Agent Platform とデータの保持ゼロ(Google Cloud、最終更新2026年9月17日、2026年9月18日確認)
この記事は役に立ちましたか?
感想は、今後の記事改善に活用します。
関連記事
プロンプトキャッシュとは?生成AIの入力を使い回して料金を下げる仕組み|効く条件と効かない場面
プロンプトキャッシュは、生成AIに毎回送る同じ前置きの計算結果を再利用して、入力の料金を下げる仕組みです。Windowsのコマンドプロンプトのキャッシュ削除とは別の言葉です。割引率も最小トークン数も保持時間も提供元とモデルで違うので、OpenAI・Anthropic・Google・AWSの公式ドキュメントから条件ごと整理しました。
ナレッジカットオフとは?AIが古い情報のまま答える理由|カットオフは1つとは限りません
ナレッジカットオフは、AIが学習に使ったデータの新しさの境目を指す言葉です。経理や検査のカットオフとは別の言葉です。同じモデルについて2つの日付を公表している例や、分野によって知識の新しさが違うと注記している例を、AnthropicとGoogleの公式ドキュメントとモデルカードから帰属つきで整理しました。
A2Aプロトコル(Agent2Agent)とは?MCPとの違いは「つなぐ相手がツールかエージェントか」|v1.0はいつ出たか
A2Aプロトコル(Agent2Agent)は、別々のベンダーが作ったAIエージェント同士をつなぐためのオープン標準です。決済分野でいうA2A(口座間の直接送金)とは別の言葉です。MCPとの関係、仕様がv1.0になった時期、試す前の確認点を、A2AとMCPの公式ドキュメントおよび公式ブログから整理しました。
知識蒸留とは?大きいモデルの答えで小さいモデルを訓練する仕組み|量子化との違いと「禁止」と検索される理由
知識蒸留は、大きいモデルに答えを出させ、その答えで小さいモデルを訓練する手法です。お酒や化学の蒸留とは別の話です。量子化や枝刈りとの違いと、OpenAI・Google・Anthropic・Metaの契約・規約・ライセンスに実際に書かれている文言を、それぞれが誰に向けた文書かも添えて、原論文と各社の公式ドキュメントから整理しました。
次のAIツール選びへ
気になるツールを並べて、料金や特徴の違いを確認できます。