AI OCRとは?従来のOCRとの違いは「読み取った後」|表・項目の残り方と、生成AIに渡す前の確認点
請求書や申込書の束をスキャナに通しながら、この入力作業をAIに任せられないかと考えたことはないでしょうか。
調べはじめると「AI OCR」という言葉に行き当たります。ただ、出てくるのは製品の比較と導入メリットの紹介ばかりです。
従来のOCRとの違いを探しても、見つかるのは「手書きや崩れた文字も読めるようになった」という説明が中心です。それなら自社の帳票で試せばいいのか、他に確かめることがあるのかが見えてきません。
実は各社の公式ドキュメントを読むと、違いの重心は文字を読む部分ではなく、その先に置かれています。
この記事では、AI OCRという言葉が何を指しているのか、従来のOCRとの違いがどこにあるのか、読み取った結果がどんな形で返ってくるのかを、Google Cloud・Microsoft・AWSの公式ドキュメントの記述から整理します。
いちばんの分かれ目は「読めるかどうか」ではなく「読んだ後」でした。ここを先に押さえると、製品を見る目が変わります!
この記事の監修者
AIリスキル株式会社 代表取締役
AIツールギャラリーを運営するAIリスキル株式会社の代表取締役。企業・自治体向けの生成AI研修とAI導入支援を手がけています。
実績: 大阪・関西万博 公式プログラム「AI HEROES COLLECTION」司会進行 / 神戸市デジタル人材育成エコシステム構築事業の運営 / MBS「せやねん!」「よんチャンTV」に生成AIの専門家として出演 / Felo日本初コアアンバサダー / Genspark第1期公式アンバサダー / Skywork公式アンバサダー / AKOOL公式パートナー など
AI OCRとは何を指す言葉なのか
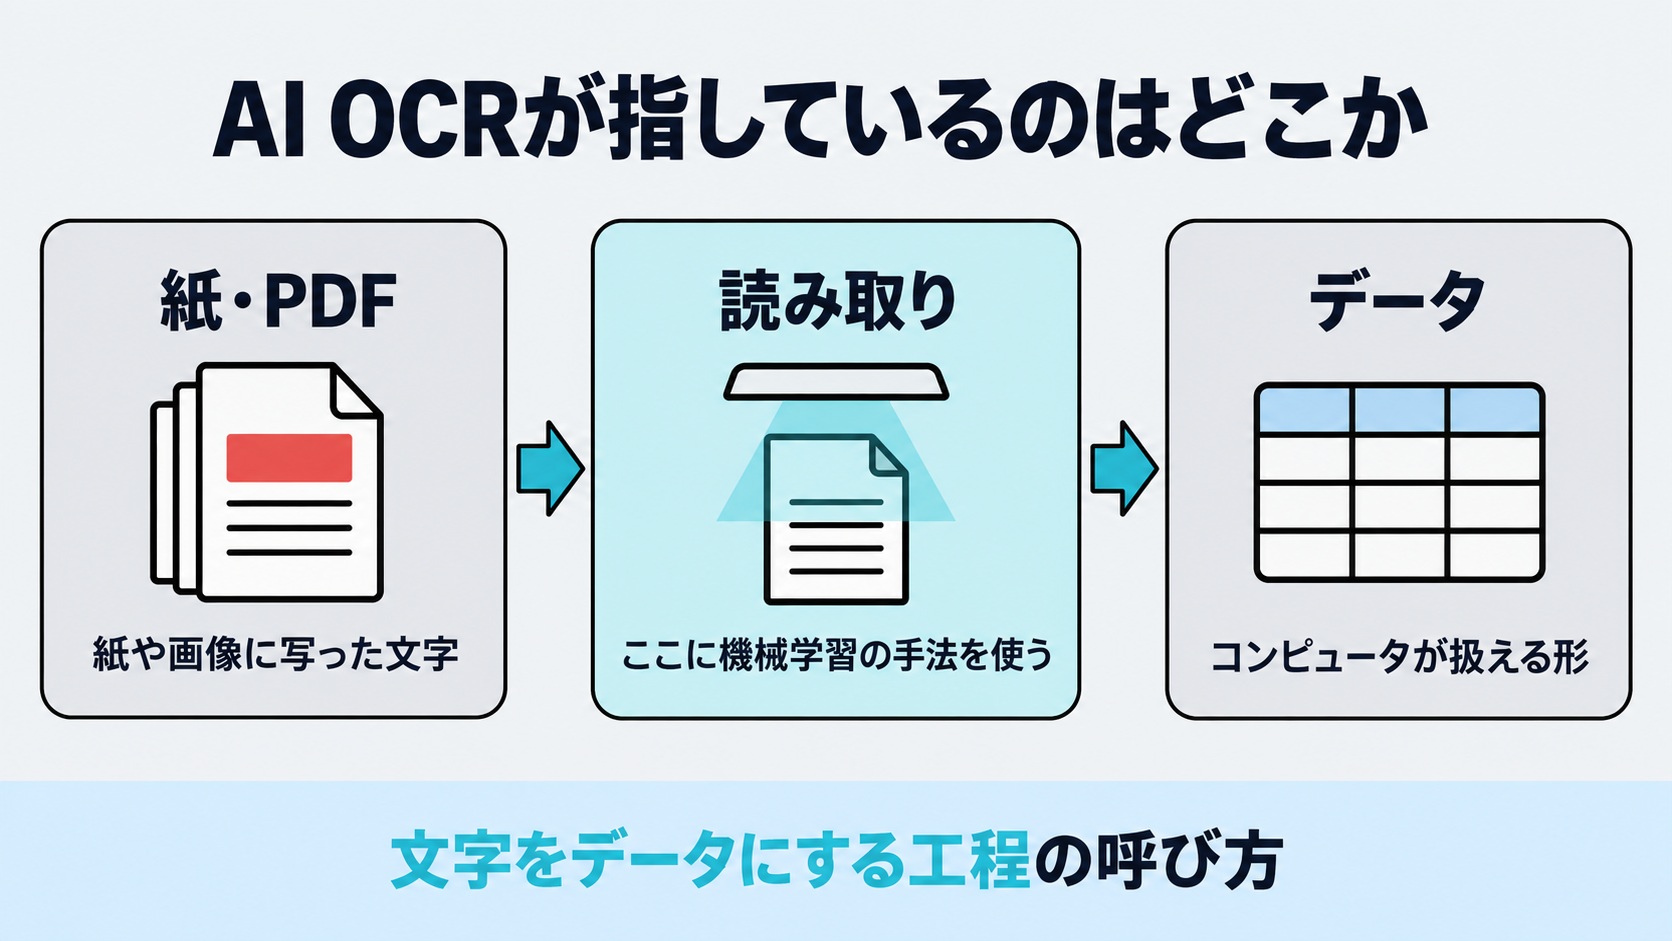
OCRは、紙や画像に写った文字をコンピュータが扱えるデータに変換する技術を指します。
AI OCRは、その文字の読み取りと文書の解釈に機械学習の手法を使うサービスを指す呼び方です。日本語の製品紹介でよく見かける言い方です。
ここで先に断っておきたいことがあります。本記事で確認した各社の公式ドキュメントは、この「AI OCR」という呼称そのものを使っていませんでした。
Google Cloudは「Document AI」、Microsoftは「Azure AI Document Intelligence」、AWSは「Amazon Textract」という製品名で説明しています。
Microsoftは自社サービスを、機械学習にもとづくOCRおよび文書処理のサービスだと説明しています。呼び名は違っても、扱っている範囲は近いものです。
したがって**AI OCRに公式な統一定義があるかどうかは、本記事で確認した範囲では確認できませんでした。**製品カテゴリの呼び名として読むのが実態に近いところです。
従来のOCRとの違いは、どこにあるのか
違いとしてよく挙げられるのは、手書きや崩れた文字、決まった書式のない帳票も読めるようになった、という点です。
読み取れる対象が広がったことは確かに違いの一つです。ただし、それだけでは説明しきれない部分があります。
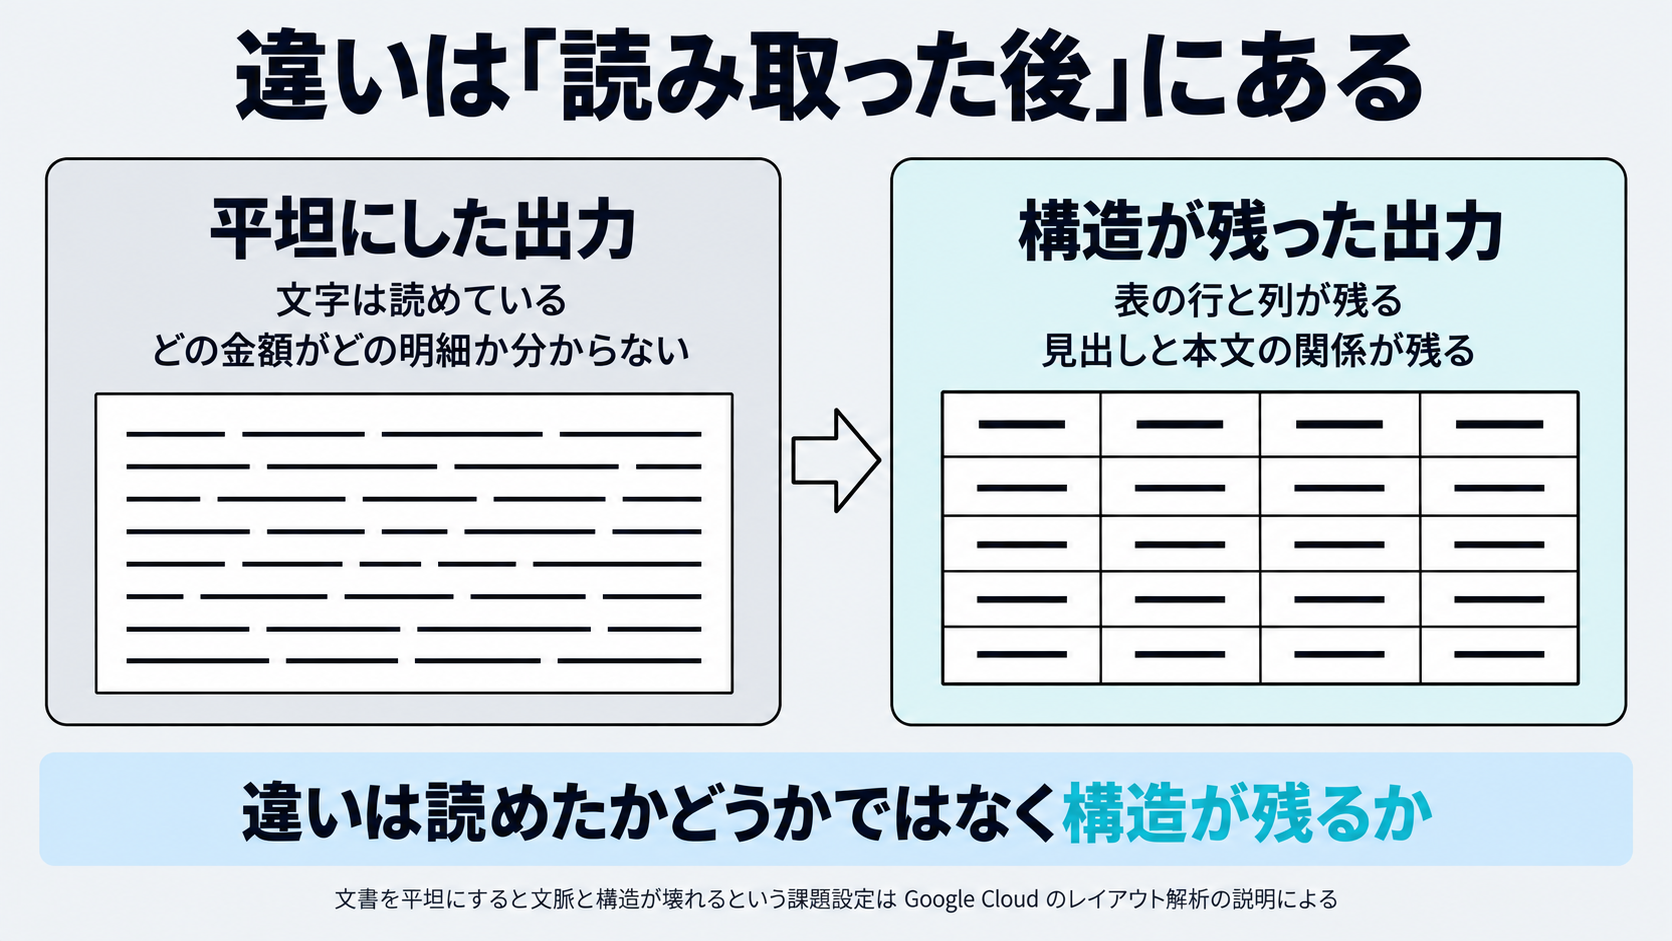
Google Cloudは、Document AIのレイアウト解析機能について、標準的なOCRは文書を平坦にしてしまい、意味を与えている文脈と構造そのものを壊してしまうという趣旨の課題設定を書いています。
つまり同社が置いている論点は、文字が読めたかどうかではありません。読み取った結果に、元の文書が持っていた構造が残っているかです。
請求書を例にすると分かりやすくなります。文字がすべて正しく読めても、金額が一列の文章に流し込まれてしまえば、どの金額がどの明細行のものかは分からなくなります。
Microsoftも、文書レイアウトの役割を二つに分けて説明しています。テキスト・表・図・選択マークといった幾何的な役割と、タイトル・見出し・フッターといった論理的な役割です。
この二つを分けて扱うということは、どこに何が書いてあるかだけでなく、それが文書の中でどういう位置づけの要素なのかまで返そうとしているということです。
違いの重心は、読み取った後にあります。
読み取った後、どんな形で返ってくるのか
ここからは各社の公式ドキュメントに書かれている仕様です。いずれも各社の製品の仕様であり、AI OCR全般に共通する保証仕様ではありません。
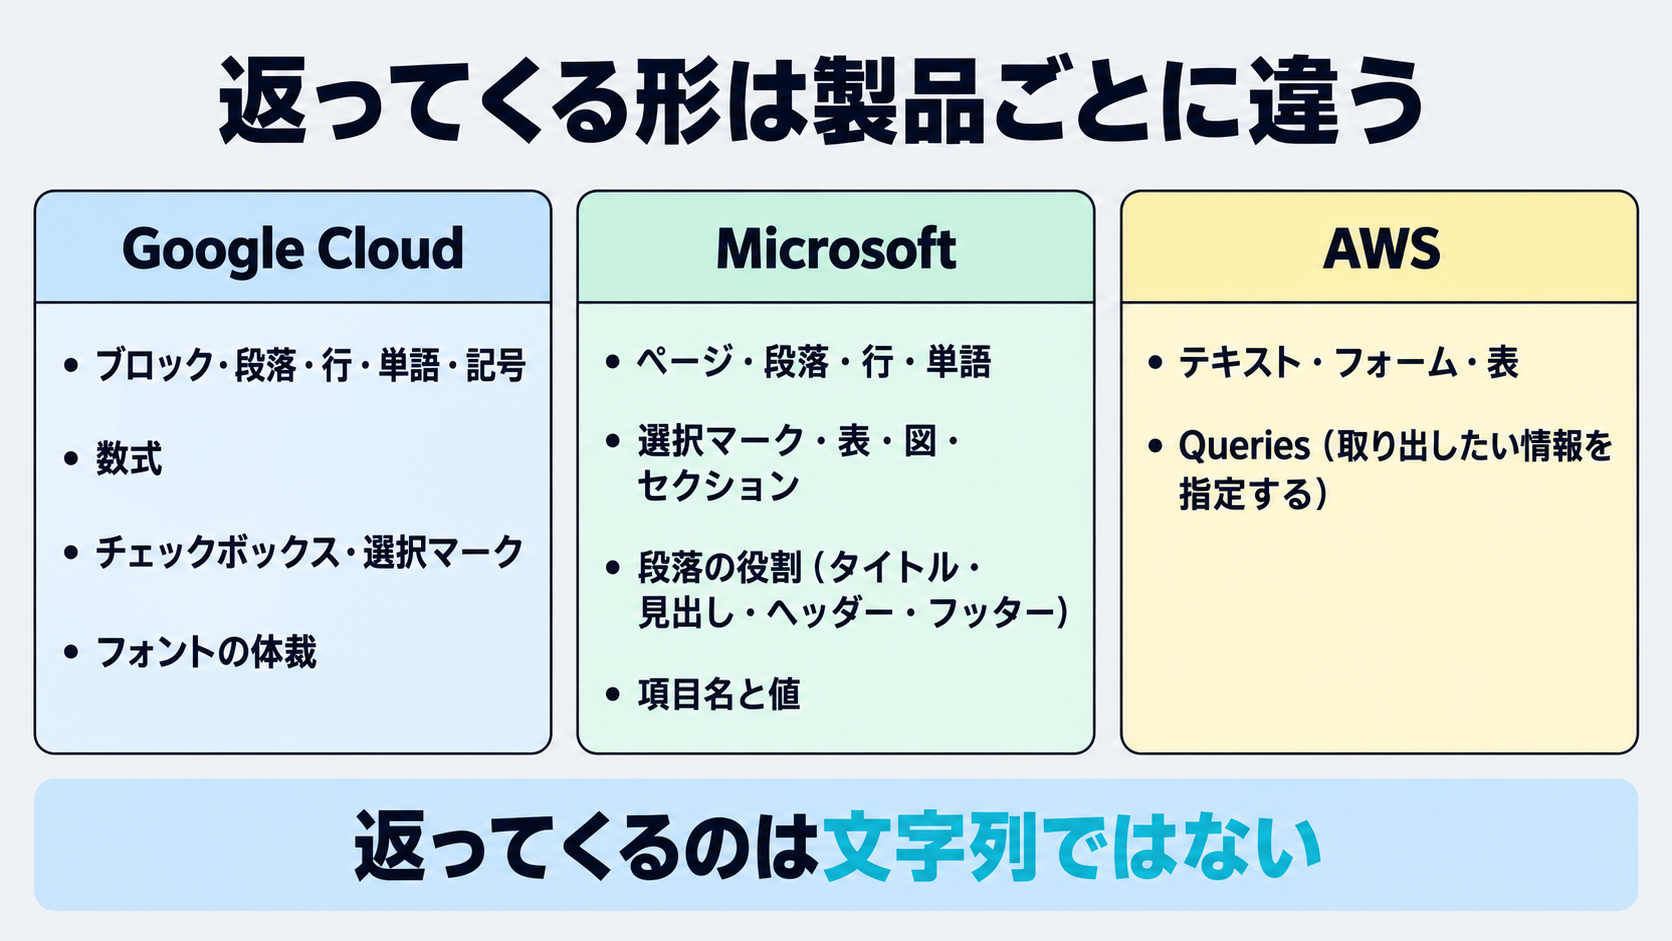
Google CloudのEnterprise Document OCRは、テキストとレイアウト情報を検出・抽出するとしています。構造の単位として、ブロック・段落・行・単語・記号を挙げています。
同社はアドオン機能として、数式の抽出、チェックボックスや選択マークの抽出、書体や太字・斜体・下線といったフォントの体裁の検出も挙げています。
MicrosoftのAzure AI Document Intelligenceは、用途別にモデルを分けています。Readは活字と手書きのテキストを抽出し、Layoutはテキスト・表・文書構造を抽出するとしています。
Layoutモデルが返す構造要素として、ページ・段落・テキスト・行・単語・選択マーク・表・図・セクションが挙げられています。
さらに段落には役割が付きます。タイトル、セクション見出し、ページヘッダー、ページフッターといった区別です。
同社の旧バージョンの表記には、テキスト・構造に加えて項目名と値の組み合わせを抽出するモデルの説明もあります。請求書なら「請求金額」という項目名と、その金額を対にして取り出す考え方です。
Microsoftは用途別の事前構築モデルも用意しています。確認できた例として、請求書、領収書、契約書、銀行取引明細、小切手、給与明細、米国の税務フォームがあります。
AWSのAmazon Textractも、Document Analysis APIでテキスト・フォーム・表を抽出するとしています。フォームの抽出は、先ほどの項目名と値の組み合わせにあたります。
同社にはQueriesという機能もあり、文書から取り出したい情報を指定して抽出できると説明されています。
ここまで並べると、読み取った後に返ってくるものが「文字列」ではないことが見えてきます。
決まった形で受け取りたいという考え方は、生成AIの構造化出力とも通じるところがあります。後工程が扱える形を先に決めておく、という点が共通しています。
手書きや崩れた帳票は、どこまで読めるのか
**本記事では認識率の数値を書きません。**特定の製品がどこまで読めるかを一次資料で確認できた形で示せないためです。
代わりに、公式ドキュメントが「何が読み取りを難しくするか」をどう扱っているかを見ておきます。
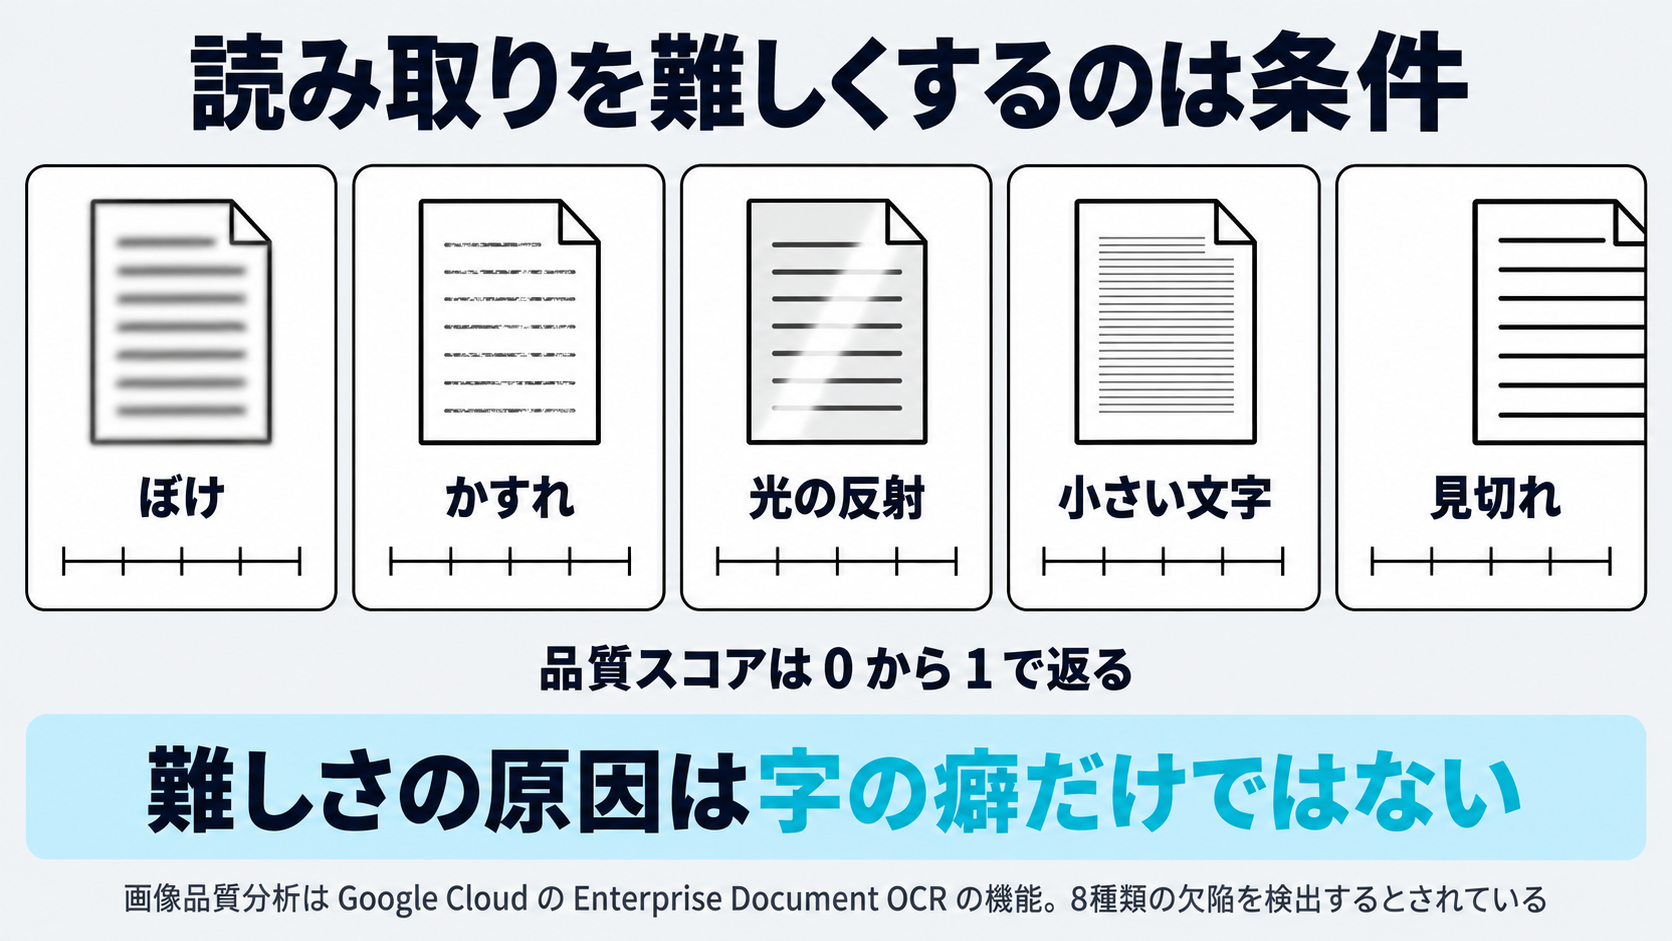
Google CloudのEnterprise Document OCRには、画像品質分析という設定があります。0から1の品質スコアを返し、8種類の欠陥を検出するとしています。
列挙されている欠陥には、ぼけ、ノイズ、暗さ、かすれ、文字が小さいこと、見切れ、光の反射が含まれます。
つまり難しさの原因は、書いた人の字の癖だけではありません。撮影や読み取りの条件そのものが、かなりの部分を占めています。
Microsoftの出力には、**確からしさを示す値が含まれます。**単語ごと、選択マークごとに信頼度が返る例がドキュメントに示されています。
この値が返るということは、出力の一部を人が確認する工程を設計に組み込めるということでもあります。確認が要らなくなるという意味ではありません。
なお、AWSのAmazon Textractについては、本記事で確認したページに信頼度の値に関する記述を確認できませんでした。Microsoftの仕様を他社に当てはめることはできません。
読める範囲は、扱う書類と読み取り条件によって変わります。自社の実物で試すこと以外に、確かめる方法はありません。
生成AIに渡すとき、なぜ出し方が効いてくるのか
社内の紙やPDFを生成AIに検索させたい場合、OCRはその手前の工程になります。
Google CloudのEnterprise Document OCRは、想定される使い方の一つとして大規模言語モデルのアプリケーションでの利用を挙げています。
言語モデルの文脈理解と、OCRのテキストおよびレイアウト抽出を組み合わせて、質問と回答を自動化するという説明です。
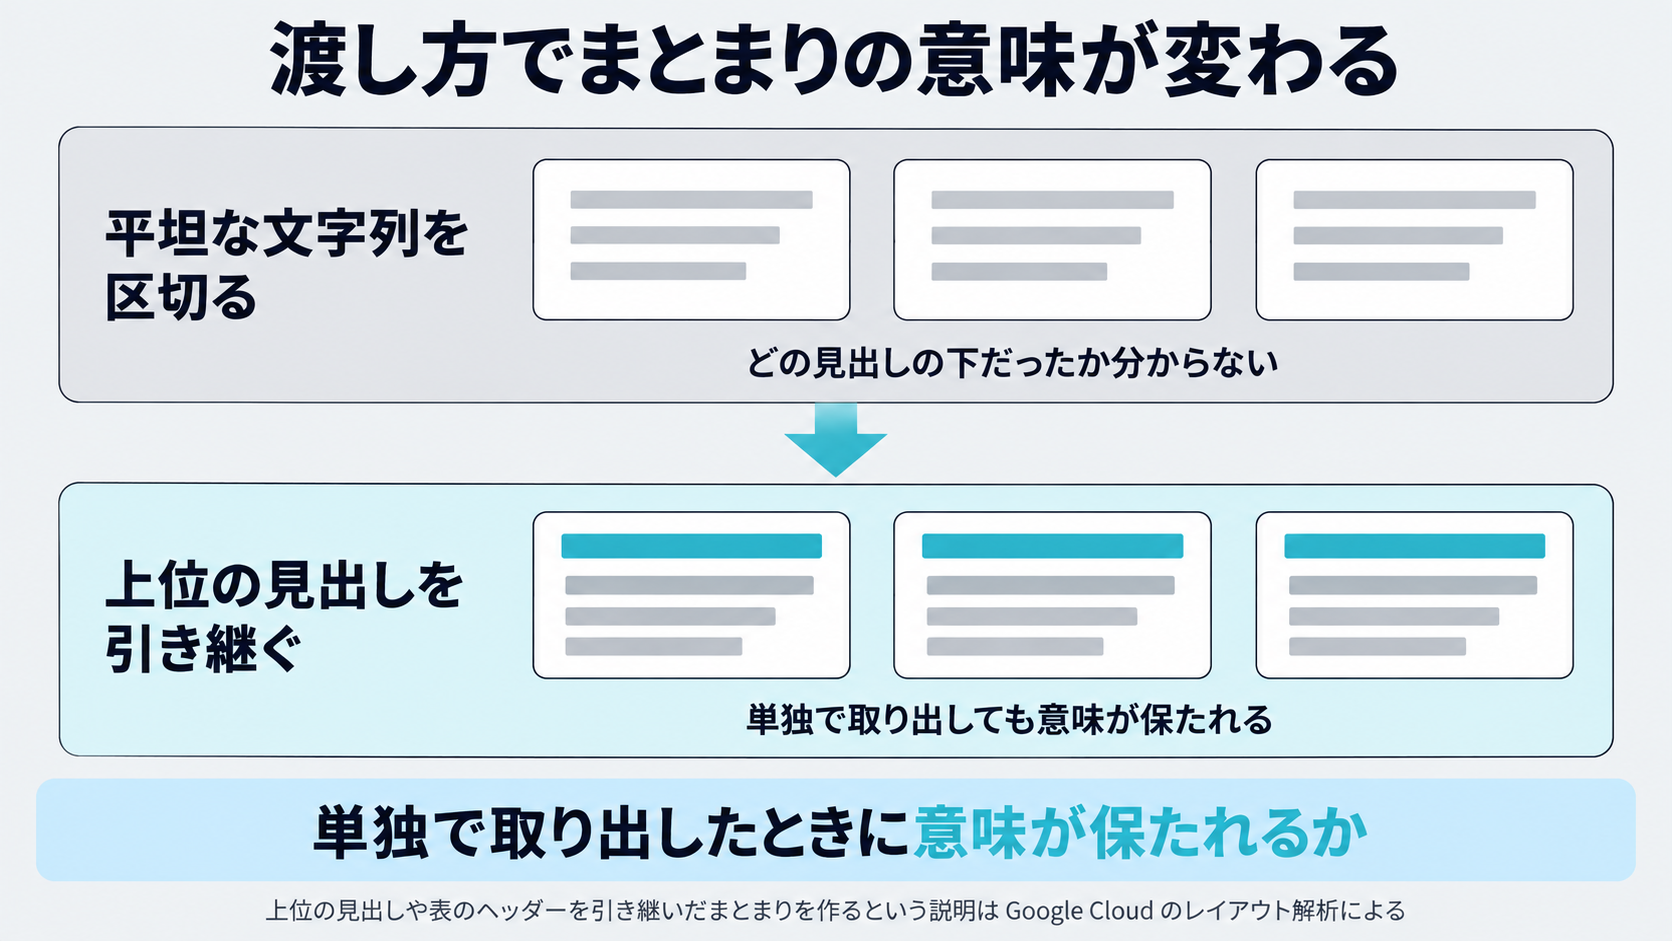
同社のレイアウト解析機能は、文書を階層的な構造として解析し、意味のまとまりごとに区切ったかたまりを作るとしています。
このとき、上位の見出しや表のヘッダーの内容を引き継いだかたまりを作ると明記されています。目的は、そのかたまりが単独で取り出されたときにも意味が保たれるようにするためです。
ここが効いてきます。文書を区切って渡す作業はチャンクと呼ばれますが、平坦な文字列から区切ると、どの見出しの下の記述だったかという情報は失われます。
そのままRAGの仕組みに載せると、取り出されたかたまりだけを見ても何の話か分からない、という状態が起こりえます。

Microsoftも、Layoutモデルの用途として構造による文書のインデックス作成と検索を挙げています。
同社はさらに、文書生成AIにおけるRAGの登場が、階層的な文書構造の解析の重要性を際立たせているという趣旨の記述を置いています。Layoutモデルがセクションとサブセクションを出力に持つのは、この関係を示すためだと説明されています。
同社のLayoutモデルには、抽出したテキストをMarkdown形式で出力する設定もあります。
ただしバージョンによって表の表現が変わります。v4.0の2024-11-30の一般提供では、結合セルや複数行の見出しを表現できるよう、表がHTMLの表として出力されるようになったと注記されています。
AWSのAmazon Textractも、自然言語処理のアプリケーション向けの用途として、テキストがどのようにまとめられて入力されるかを制御できる点を挙げています。単語や行として取り出すことも、表の解析を有効にしてセル単位でまとめることもできるとしています。
社内文書を対象にした検索の全体像は文書検索AIで扱っているので、取り込んだ後の設計はそちらに譲ります。
本記事の範囲で言えることは一つです。OCRの出力の形は、その後ろにつながる工程の質を左右する前提条件になります。
検討するとき、何から確かめるのか
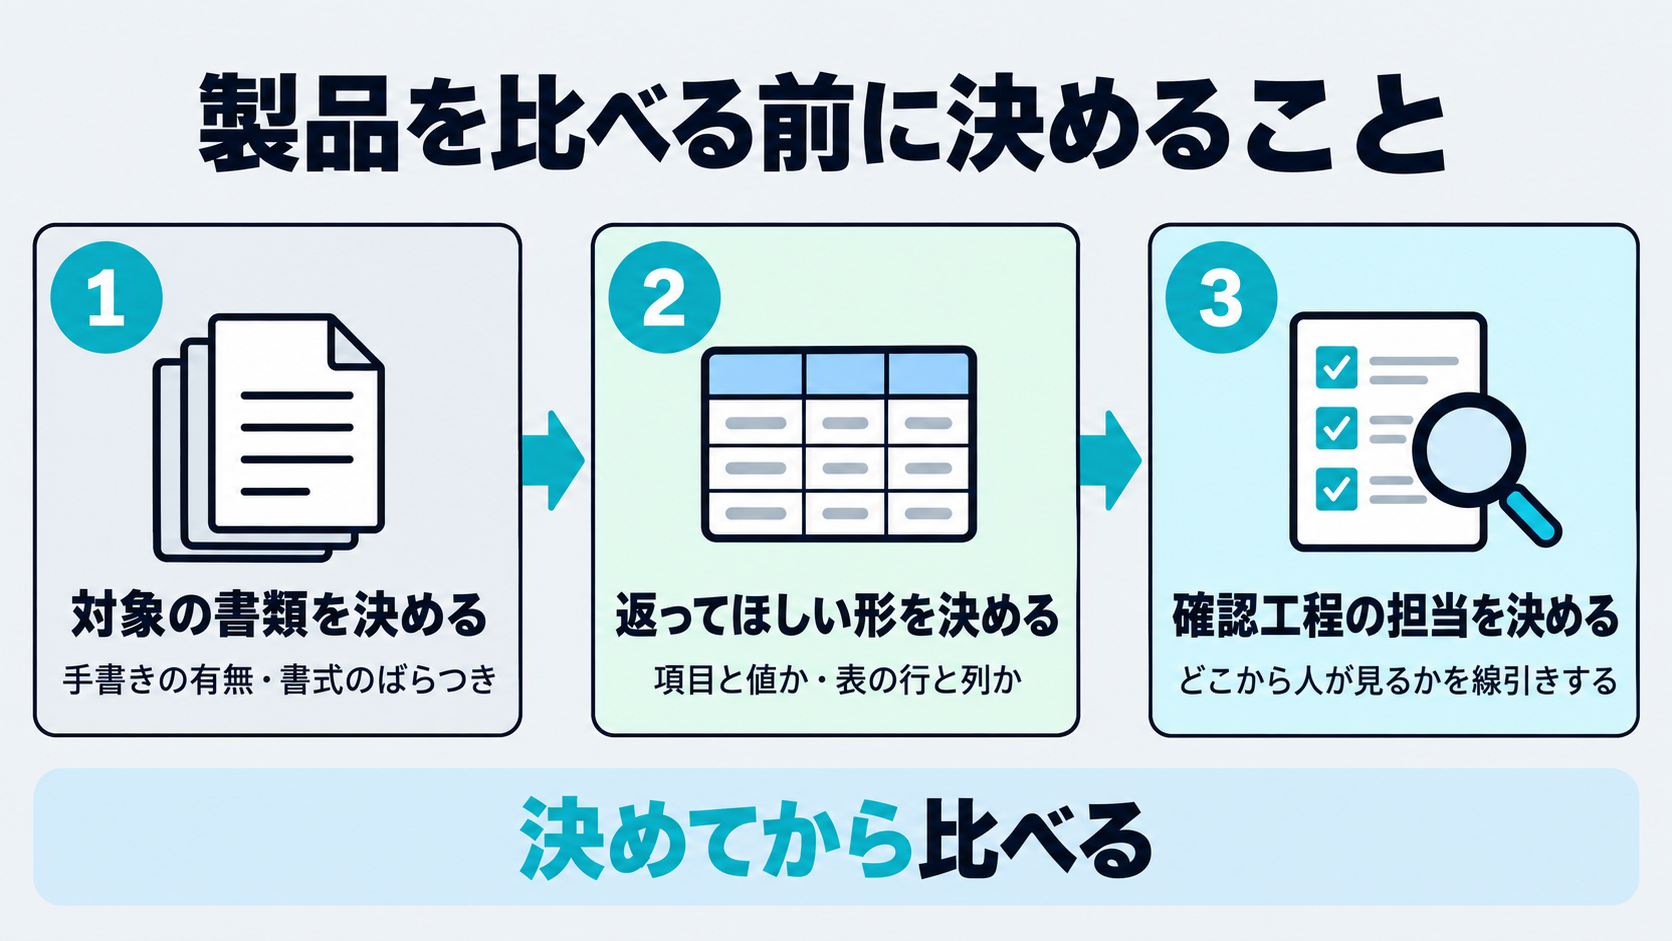
製品の比較や料金は本記事では扱いません。その前に決めておくと判断が楽になることを、順番に挙げます。
一つ目は、対象の書類を具体的に決めることです。請求書なのか申込書なのか、手書きが含まれるのか、書式が取引先ごとに違うのかで、確かめるべき点が変わります。
業務の側から候補を洗い出す手順は業務棚卸しで扱っています。
二つ目は、読み取った結果にどんな形で返ってきてほしいかを先に決めることです。
ここまで見てきたとおり、返ってくる形は製品によって異なります。項目名と値の組み合わせが要るのか、表の行と列の関係が要るのか、文書の見出し構造が要るのかを、先に言語化しておきます。
三つ目は、確認の工程を誰が持つかを決めることです。
確からしさの値が返る製品であれば、どの値を下回ったら人が見るのかという線引きを設計できます。読み取りから後工程までの手順を組み立てる考え方はAIワークフローで扱っています。
なお、社外のサービスに文書を送る形になる場合、**どの範囲の文書を対象にするかは、自社の文書の取り扱い基準に沿って判断することになります。**本記事はその可否を判断するものではありません。
よくある質問
AI OCRと従来のOCRは別物ですか
まったく別の技術というより、文字をデータにするという目的は同じで、そのやり方と返ってくるものが変わったものと捉えるのが近いところです。
本記事で確認した各社の公式ドキュメントは、テキストの抽出だけでなく、表・選択マーク・文書構造・項目名と値の組み合わせといった出力を説明しています。
手書きの帳票は必ず読めますか
必ず読めるとは言えません。
Google Cloudは活字と手書きの両方を既定で扱うとしていますが、同時に、ぼけ・かすれ・光の反射といった画像品質の欠陥を検出する仕組みも用意しています。読み取り条件によって結果が変わることが前提になっています。
読み取り結果に誤りが混ざる可能性がある以上、その結果を生成AIに渡した先で、もっともらしい誤りが生まれるハルシネーションの問題とも切り離せません。自社の実物で試して確かめることになります。
読み取った文書は、そのまま生成AIに渡せばよいですか
渡す形によって後工程の結果が変わる、というのが公式ドキュメントの立場です。
Google Cloudは、平坦にすると文脈と構造が壊れるという課題を挙げ、上位の見出しを引き継いだまとまりを作ると説明しています。Microsoftも構造による検索とRAGへの関係を挙げています。
どちらも特定製品の説明ですが、出力の形を先に決めておくという考え方は共通しています。
まとめ
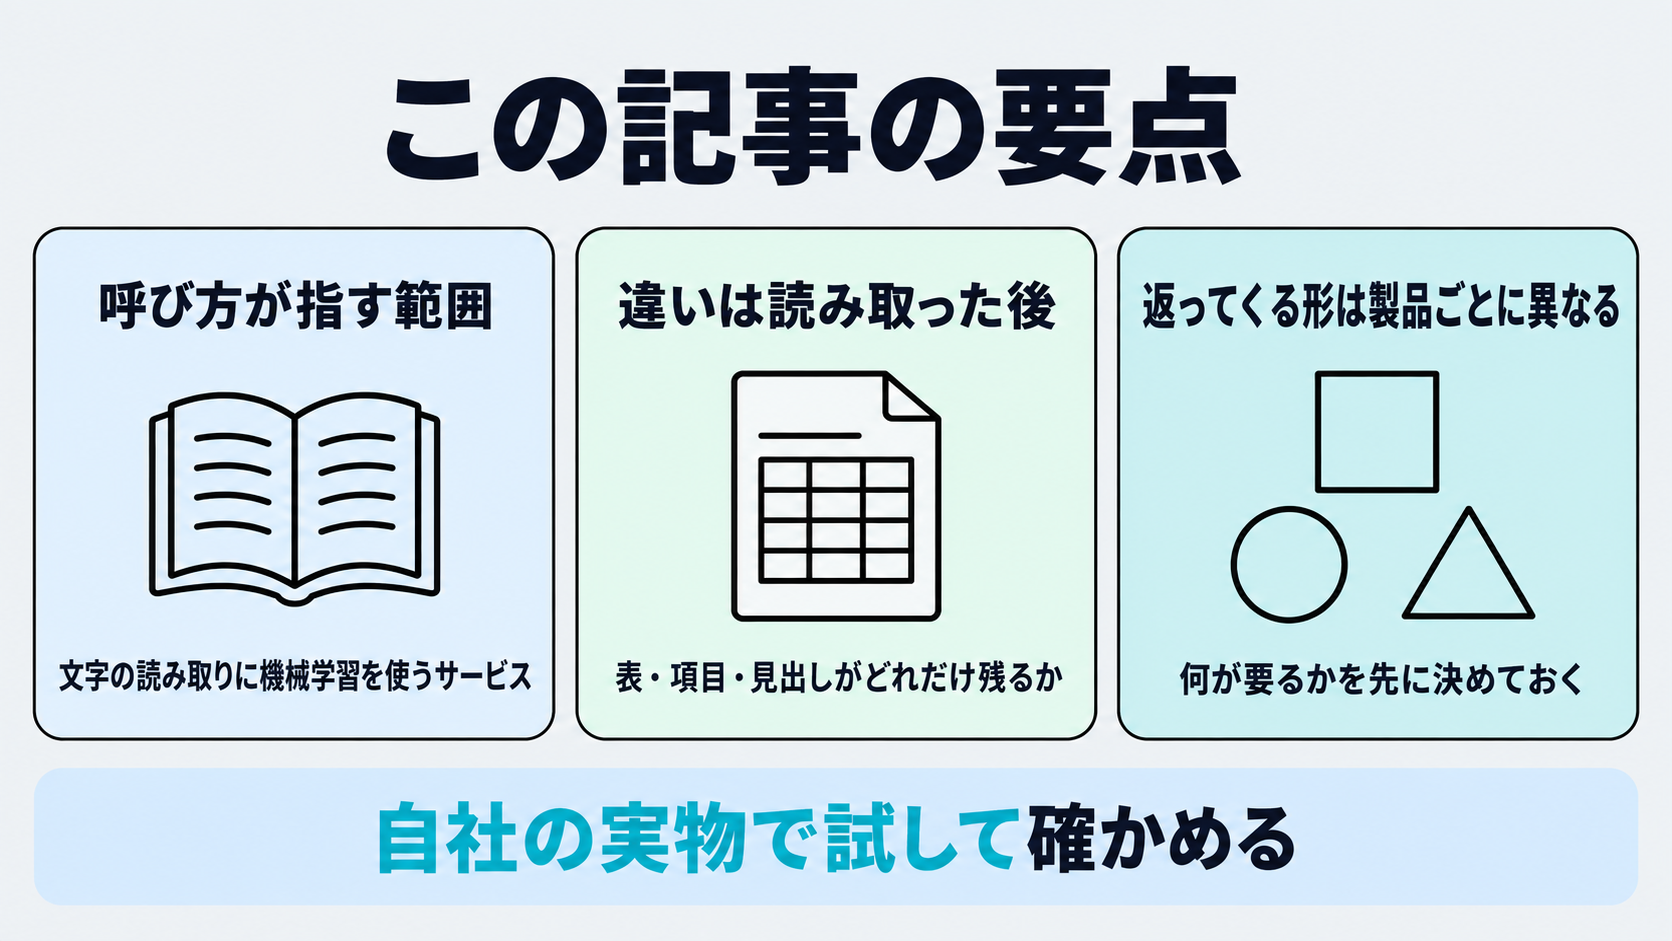
AI OCRは、紙や画像の文字をデータにする工程に機械学習の手法を使うサービスの総称として使われている呼び方です。
本記事で確認した各社の公式ドキュメントはこの呼称を使っておらず、公式な統一定義があるかどうかは確認できませんでした。
従来のOCRとの違いは、読める文字の範囲が広がったことだけではありません。読み取った結果に、表・項目・見出しといった構造がどれだけ残るかという点に重心があります。
返ってくる形は製品によって異なります。構造の単位、選択マーク、項目名と値の組み合わせ、確からしさの値、Markdown出力などは、それぞれの製品の仕様として説明されているものです。
読み取り精度を数値で示すことは本記事ではしていません。公式ドキュメントが挙げているのは、ぼけやかすれといった画像品質の要因であり、自社の実物で試すことが確認の手段になります。
生成AIにつなぐ場合は、OCRの出力の形が後工程の前提になります。検討の順番としては、対象書類を決め、返ってほしい形を決め、確認工程の担当を決めるところからになります。
文書の取り込みやAI活用の進め方についてご相談がある場合はお問い合わせはこちらからご連絡ください。
この記事の出典
- Enterprise Document OCR | Document AI(Google Cloud Documentation、2026-09-17確認)
- Process documents with Gemini layout parser | Document AI(Google Cloud Documentation、2026-09-17確認)
- What is Azure AI Document Intelligence?(Microsoft Learn、2026-09-17確認)
- Document layout analysis(Microsoft Learn、2026-09-17確認)
- What is Amazon Textract?(AWS Documentation、2026-09-17確認)
この記事は役に立ちましたか?
感想は、今後の記事改善に活用します。
関連記事
AIアダプション(AI活用定着)とは?本記事で整理する、社内で使い続けてもらうための考え方
AIアダプション(AI活用定着)を、導入だけで終わらせず社内で使い続けてもらうための考え方として本記事で整理します。AWSの企業向け生成AI導入ガイドは、範囲を絞った開始、学びの記録、知識共有を推奨しています。経済産業省はAI事業者ガイドライン第1.2版とチェックリストを公開しています。本記事では、試す業務、利用ルールの確認先、残った質問の共有を確認項目として提案します。
AI CoEとは?横断的なAI活用を支える組織とAIチャンピオンとの違い
AI CoEは、AI活用を横断的に支える組織や体制を指す呼び方です。本記事では、AWS Prescriptive Guidanceが示す一例を手がかりに、AIチャンピオンとの違いと会社で確認したい点を整理します。
AI導入ロードマップとは?小さく試して展開を判断する順番と最初に決めること
AIツールギャラリーが、AI導入を検討する会社員向けに、最初に決めることから小さな試行、続ける・変える・止めることを含む展開判断までのAI導入ロードマップを整理します。AWSの成熟度モデルはAWS上の資料として区別します。
SOP(標準作業手順書)とは?AI導入で手順を人とAIに渡せる形にする方法
SOP(標準作業手順書)を、AI導入で業務の手順を人とAIへ渡せる形に整える視点から解説します。業務棚卸し、AIワークフロー、承認フローとの違いと、社内で確認する点を整理します。
次のAIツール選びへ
気になるツールを並べて、料金や特徴の違いを確認できます。