ナレッジカットオフとは?AIが古い情報のまま答える理由|カットオフは1つとは限りません
先月に変わったばかりの制度について、社内で使っている生成AIに聞いてみた。そんな場面を思い浮かべてください。
返ってきたのは、迷いのない断定でした。文章は整っていて、根拠らしい説明まで添えられています。
ところが念のため公式サイトを見にいくと、内容が古いままでした。変更前の説明をそのまま答えていたことになります。
気になるのは「知りませんでした」と言われなかったことです。知らないなら、そう言ってほしかったはずです。
調べていくと「ナレッジカットオフ」という言葉に行き当たります。ただ、説明を読んでも引っかかりが残ります。検索機能が付いているのに、なぜ古い答えが返ってきたのでしょうか。
この記事では、ナレッジカットオフが何を指す言葉なのか、なぜ1つの日付では言い切れないのか、そして自分が使っているモデルをどこで確かめられるのかを整理します。
根拠にするのは、OpenAI・Anthropic・Googleの公式ドキュメントとモデルカード、および学術論文です。
提供元の書き方を読み比べてみたら、そもそも「1モデル=1つの日付」で書いていない会社がありました!
この記事の監修者
AIリスキル株式会社 代表取締役
AIツールギャラリーを運営するAIリスキル株式会社の代表取締役。企業・自治体向けの生成AI研修とAI導入支援を手がけています。
実績: 大阪・関西万博 公式プログラム「AI HEROES COLLECTION」司会進行 / 神戸市デジタル人材育成エコシステム構築事業の運営 / MBS「せやねん!」「よんチャンTV」に生成AIの専門家として出演 / Felo日本初コアアンバサダー / Genspark第1期公式アンバサダー / Skywork公式アンバサダー / AKOOL公式パートナー など
ナレッジカットオフとは、何を指す言葉なのか
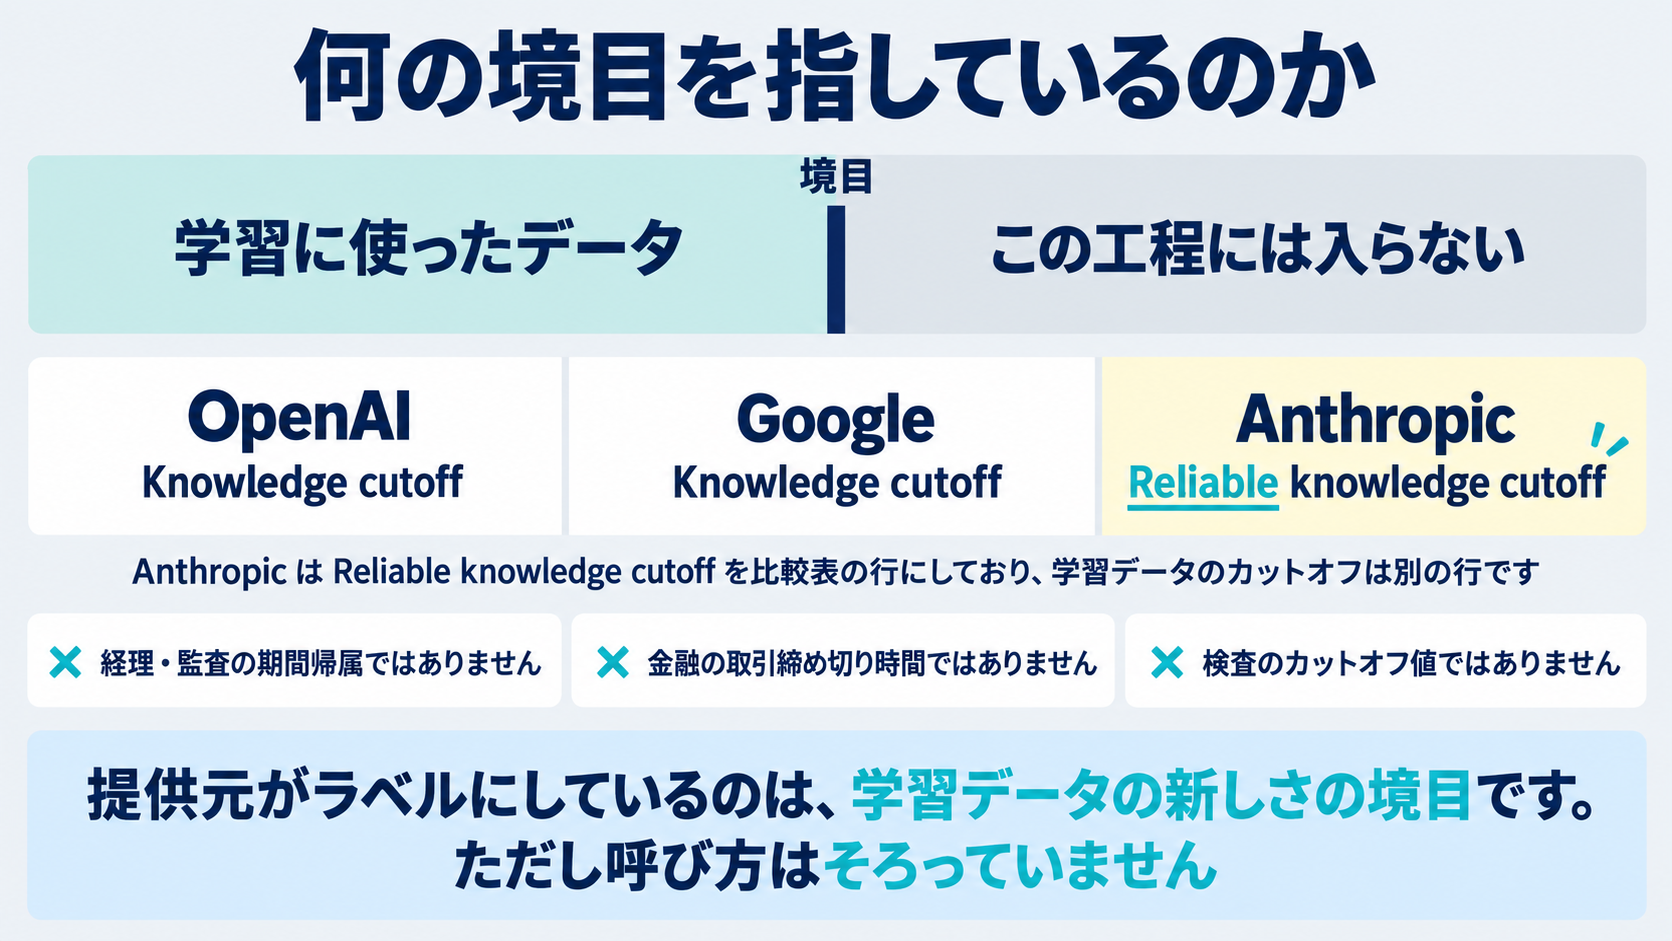
はじめに、まぎらわしい言葉を切り分けておきます。
ここで扱うカットオフは、経理や監査でいう期間帰属のカットオフとも、金融の取引締め切り時間とも、検査のカットオフ値とも別の話です。同じ表記でも分野ごとに指すものが違います。
AIの文脈でのナレッジカットオフは、モデルが学習に使ったデータの新しさの境目を指す言葉として使われています。
なぜ境目ができるのかは、作り方を考えると分かります。
Anthropicは自社のモデルについて、大規模で多様なデータセットで事前学習したうえで、その後に追加の学習を行うと説明しています。
つまり最初に大量の文章を読み込ませる工程があり、そこで使うデータはどこかで集め終える必要があります。集め終えた時点より後の出来事は、その工程には入りません。
この言葉が実際にどう使われているかは、提供元のページを開くといちばん早く分かります。
OpenAIは公式のモデル一覧で、文脈長や最大出力と同じ並びに Knowledge cutoff という項目を置いています。
本記事で確認したページでは、GPT-5.6 Sol について「Feb 16, 2026 knowledge cutoff」と表示されていました。
Googleは Gemini API のモデルページで、Latest update(最終更新)と Knowledge cutoff を別の欄に分けています。
Gemini 2.5 Pro のページでは、最終更新が2025年6月、Knowledge cutoff が2025年1月と表示されていました。
Anthropicは公式ドキュメントのモデル比較表で、Reliable knowledge cutoff(信頼できる知識のカットオフ)という行を置いています。
単なる knowledge cutoff ではなく、reliable という限定語が付いています。
つまり同じ日本語に訳される言葉でも、3社が公表しているものは、粒度も呼び方も同じではありません。
なお、この記事は生成AIの言語モデルを念頭に書いています。
なぜ「1モデル=1つの日付」で言い切れないのか
ここがこの記事のいちばん伝えたいところです。
多くの解説は「このモデルのカットオフは何年何月」という形で書かれています。ところが提供元の記載を読むと、そう単純ではない例が出てきます。
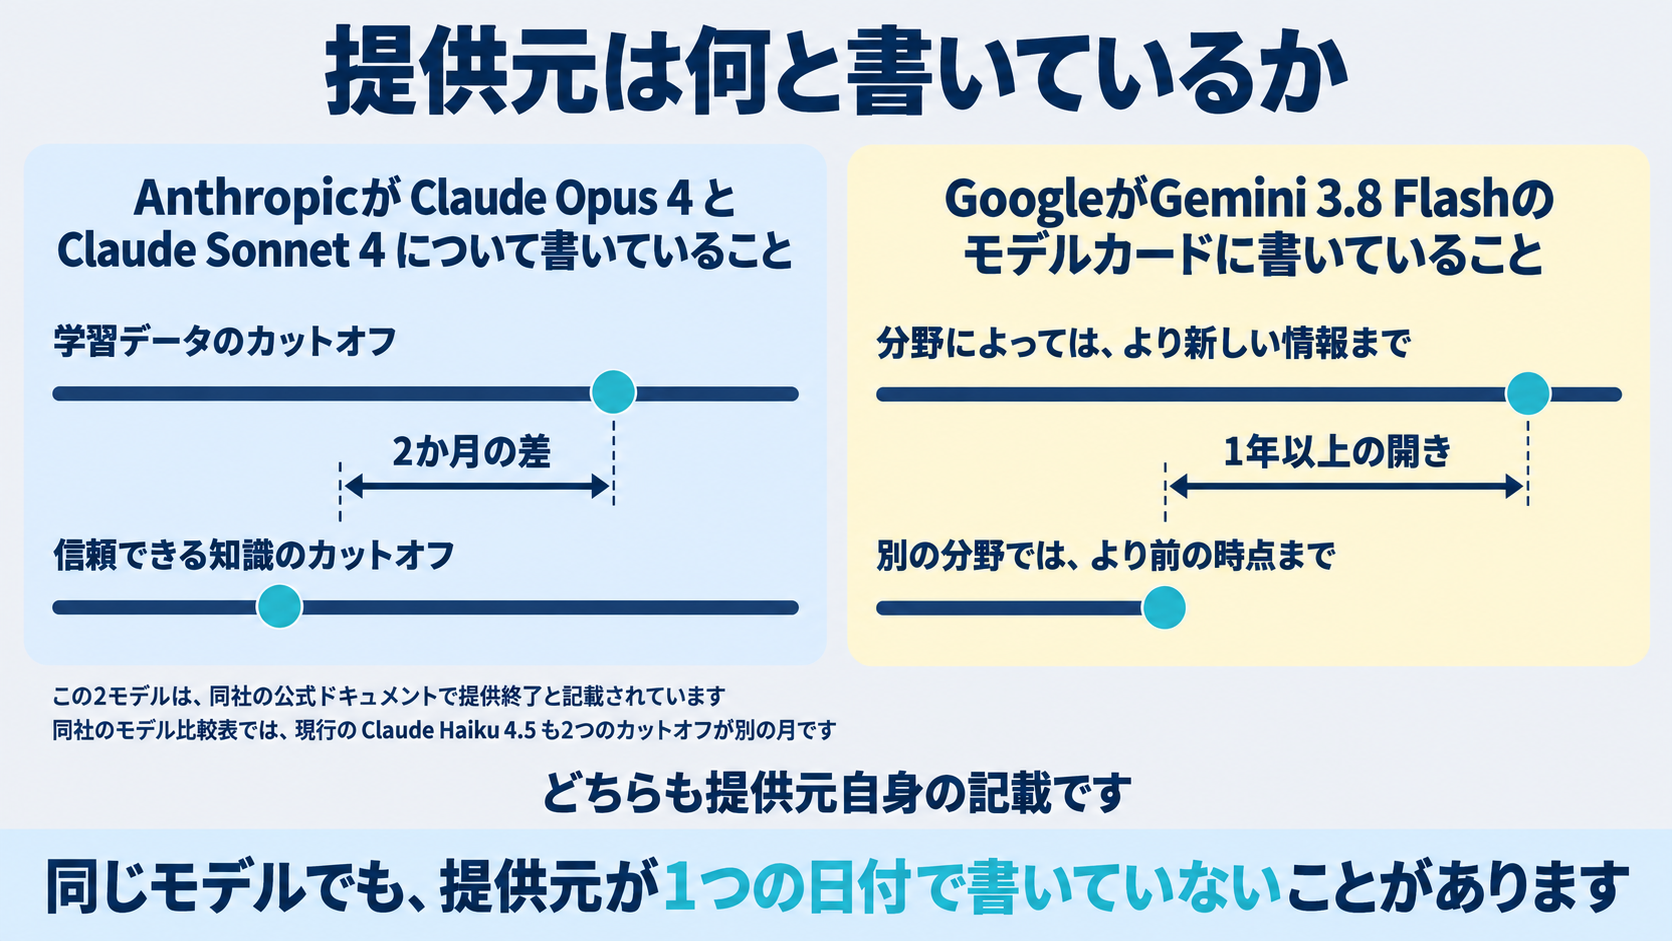
1つめは、同じモデルに2つの日付が公表されている例です。
Anthropicは自社の Transparency Hub で、Claude Opus 4 と Claude Sonnet 4 について次のように書いています。
学習データのカットオフは2025年3月だが、信頼できる知識のカットオフは2025年1月であるという趣旨の記述です。
同社は、後者について「モデルの知識がもっとも充実していて信頼できるのは、その時点までの情報と出来事についてである」と説明しています。
2つの日付には2か月の開きがあります。
なお同社は、この2モデルをすでに提供終了したものとして公式ドキュメントに記載しています。
ただし、これは終わった話ではありません。同社のモデル比較表では、現行の Claude Haiku 4.5 についても2つのカットオフが別の月として並んでいました。
同社の公式ドキュメントも、モデルごとの「reliable-knowledge と training-data のカットオフ」は Transparency Hub を見るように案内しています。つまり2つを別のものとして扱っています。
2つめは、1つの日付では表せないと提供元自身が書いている例です。
Googleは Gemini 3.8 Flash のモデルカードの既知の制約の項で、このモデルのカットオフは2026年3月だとしています。
そのうえで、分野によっては更新された情報が得られる一方、別の分野では知識が2025年1月までに留まる場合があるという趣旨の注記を置いています。
開きは1年以上あります。同じモデルの中で、話題によって知識の新しさが違うということです。
ここから読み取れることは1つです。カットオフの日付は、その日までの全分野が等しく最新である保証ではありません。
言い換えると、日付は線引きというより目安に近い扱いになります。
「検索できるかどうか」とカットオフは、何が違うのか
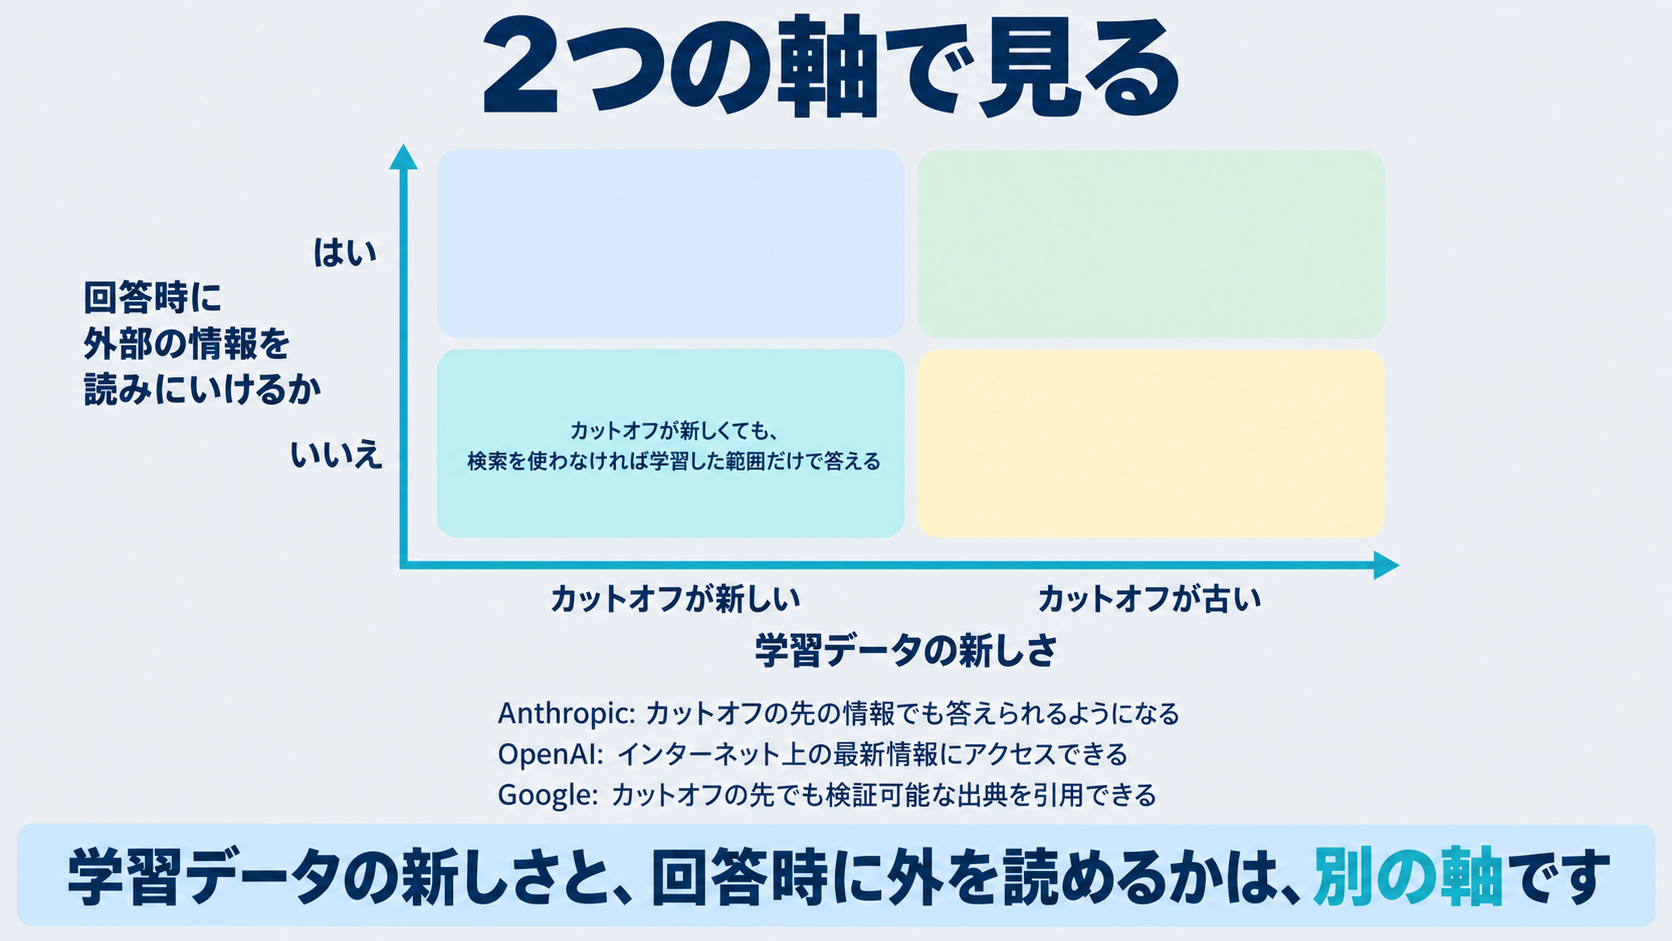
ここは混同されやすいところです。
カットオフは「学習したデータがいつまでか」の話であり、「回答するときに新しい情報を読みにいけるか」は別の軸です。
この点は3社とも公式ドキュメントに書いています。
Anthropicは自社のウェブ検索ツールについて、この機能によってClaudeがリアルタイムのウェブの内容に直接アクセスでき、カットオフの先にある最新の情報でも答えられるようになると説明しています。
OpenAIも、ウェブ検索によってモデルがインターネット上の最新情報にアクセスでき、出典を示した回答ができるとしています。
Googleも、Google検索によるグラウンディングがGeminiをリアルタイムのウェブ内容に接続し、カットオフの先でも検証可能な出典を引用できると書いています。
同社はその効用として、実世界の情報にもとづくことでハルシネーションを減らすことも挙げています。
社内の資料に対して同じことをするのがRAG(検索拡張生成)です。外部の根拠に接続して答えさせる考え方はグラウンディングと呼ばれます。

回答そのものを検索結果から組み立てるサービスはAI検索エンジンとして整理されています。
つまりカットオフが古いことと、最新の情報を扱えないことは、同じではありません。
整理すると、確かめるべきことが2つに分かれます。1つはモデルの学習データの新しさで、もう1つは、いま自分が触っている画面が外部の情報を読みにいく仕組みを持っているかです。
この2つは独立しているので、カットオフが新しいモデルでも、検索を使わなければ学習した範囲の知識だけで答えます。逆に、カットオフが古くても検索が働けば最新の内容を返せます。
読者が「古い答えが返った」と感じたとき、原因はどちらの側にもありえます。次の見出しで、そこを分けて見ていきます。
自分が使っているモデルは、どこで確認できるのか
この記事では、モデル別のカットオフ日の一覧を載せません。
理由は単純で、モデルが増えるたびに古くなるからです。代わりに、確認しにいく場所を書きます。
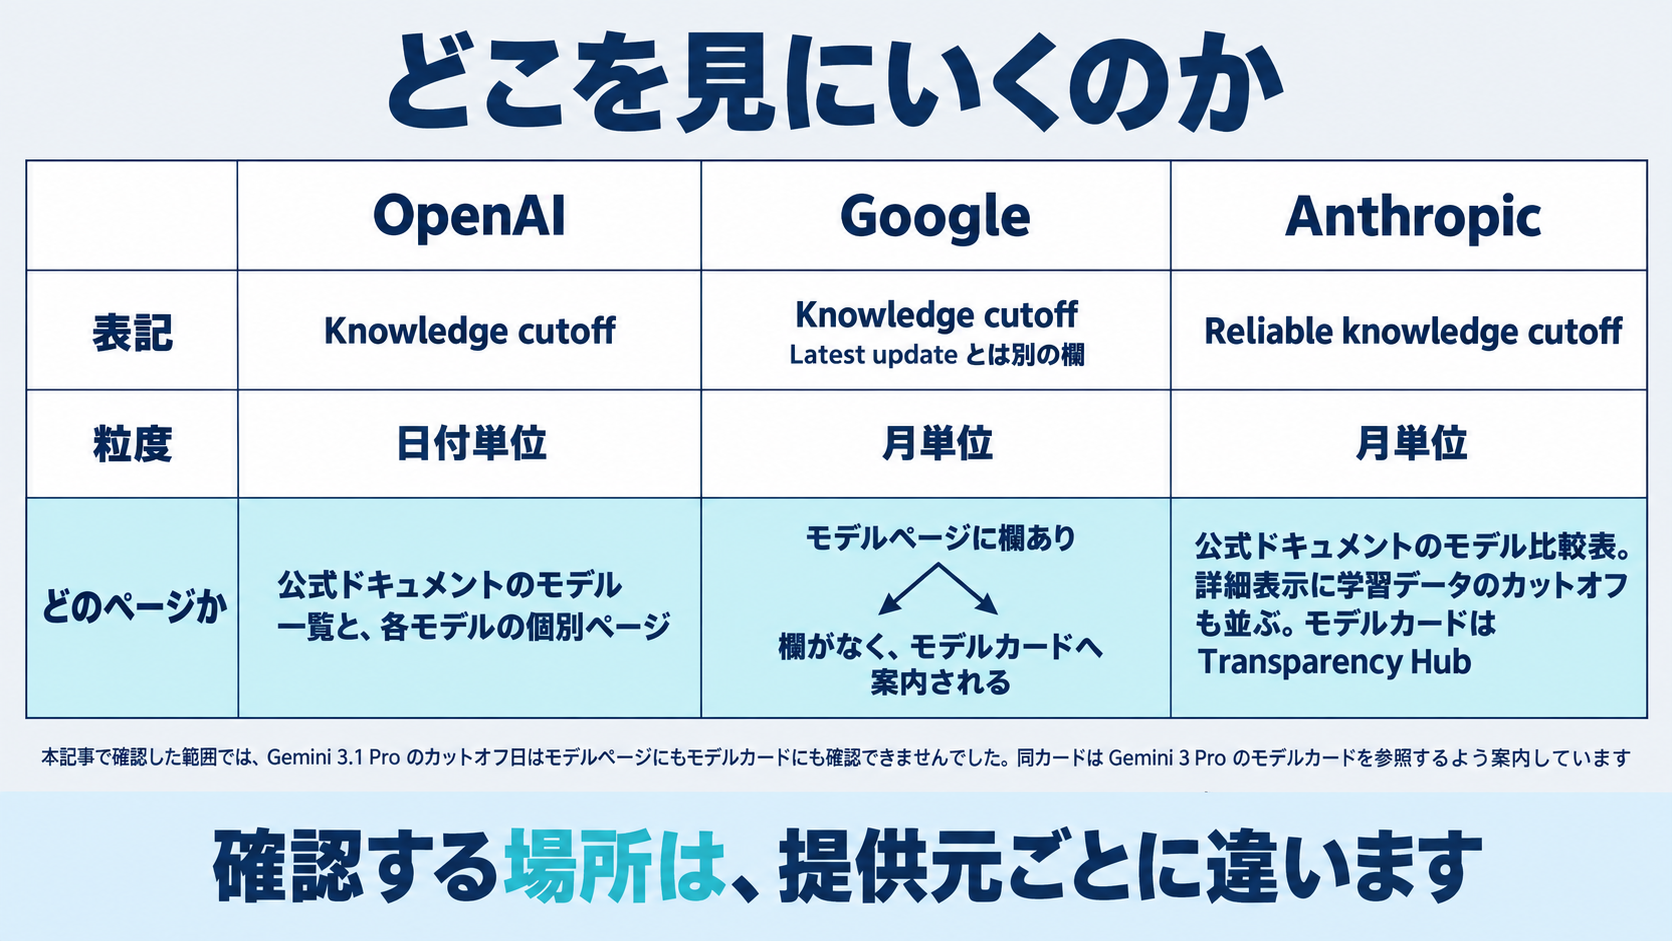
OpenAIの場合は、公式ドキュメントのモデル一覧と各モデルの個別ページに Knowledge cutoff が出ています。表示は日付単位です。
ただし、その日付が何を意味するのかを説明した文は、本記事で確認したページには確認できませんでした。
Googleの場合は、Gemini API のモデルページに Knowledge cutoff の欄があります。表示は月単位です。
ただし世代によって載っていません。
本記事で確認した範囲では、Gemini 2.5 Pro と Gemini 2.5 Flash のページには Knowledge cutoff がありました。
一方、Gemini 3.1 Pro Preview と Gemini 3.5 Flash と Gemini 3.8 Flash のページには確認できず、代わりにモデルカードへのリンクが置かれていました。
そのモデルカードにも必ず載っているとは限りません。
Gemini 3.8 Flash のモデルカードには既知の制約の項に記載がありましたが、Gemini 3.1 Pro のモデルカードには、本記事で確認した範囲ではカットオフに関する記載を確認できませんでした。
同カードは、学習データセットについては Gemini 3 Pro のモデルカードを参照するよう案内しています。本記事はその先までは確認していません。
Anthropicの場合は、公式ドキュメントのモデル比較表に Reliable knowledge cutoff の行があります。
学習データのカットオフも同じ比較表に並んでおり、詳細表示を開くと見られます。モデルカードそのものは、同社が案内している Transparency Hub にあります。
3社を並べると、次のようになります。
| 提供元 | 本記事で確認した表記 | 粒度 | 確認した場所 |
|---|---|---|---|
| OpenAI | Knowledge cutoff | 日付単位 | 公式ドキュメントのモデル一覧と、各モデルの個別ページ |
| Knowledge cutoff(Latest update とは別の欄) | 月単位 | Gemini API のモデルページ。世代によっては欄がなく、モデルカードへ案内される | |
| Anthropic | Reliable knowledge cutoff(学習データのカットオフは別の行) | 月単位 | 公式ドキュメントのモデル比較表。詳細表示に学習データのカットオフも並ぶ。モデルカードは Transparency Hub |
この表は、本記事が2026年9月18日に確認した範囲での書かれ方です。日付そのものは載せていません。
並べて分かるのは、どこに何がどの粒度で書かれているかは、そろっていないということです。
ですから「公式に載っているはず」と考えるより、使うモデルごとに1回だけ確認して、社内で共有しておくほうが現実的です。
なぜ「知らない」ではなく「古いまま答える」のか
冒頭の場面に戻ります。検索機能が付いているのに古い答えが返ってきた、という引っかかりです。
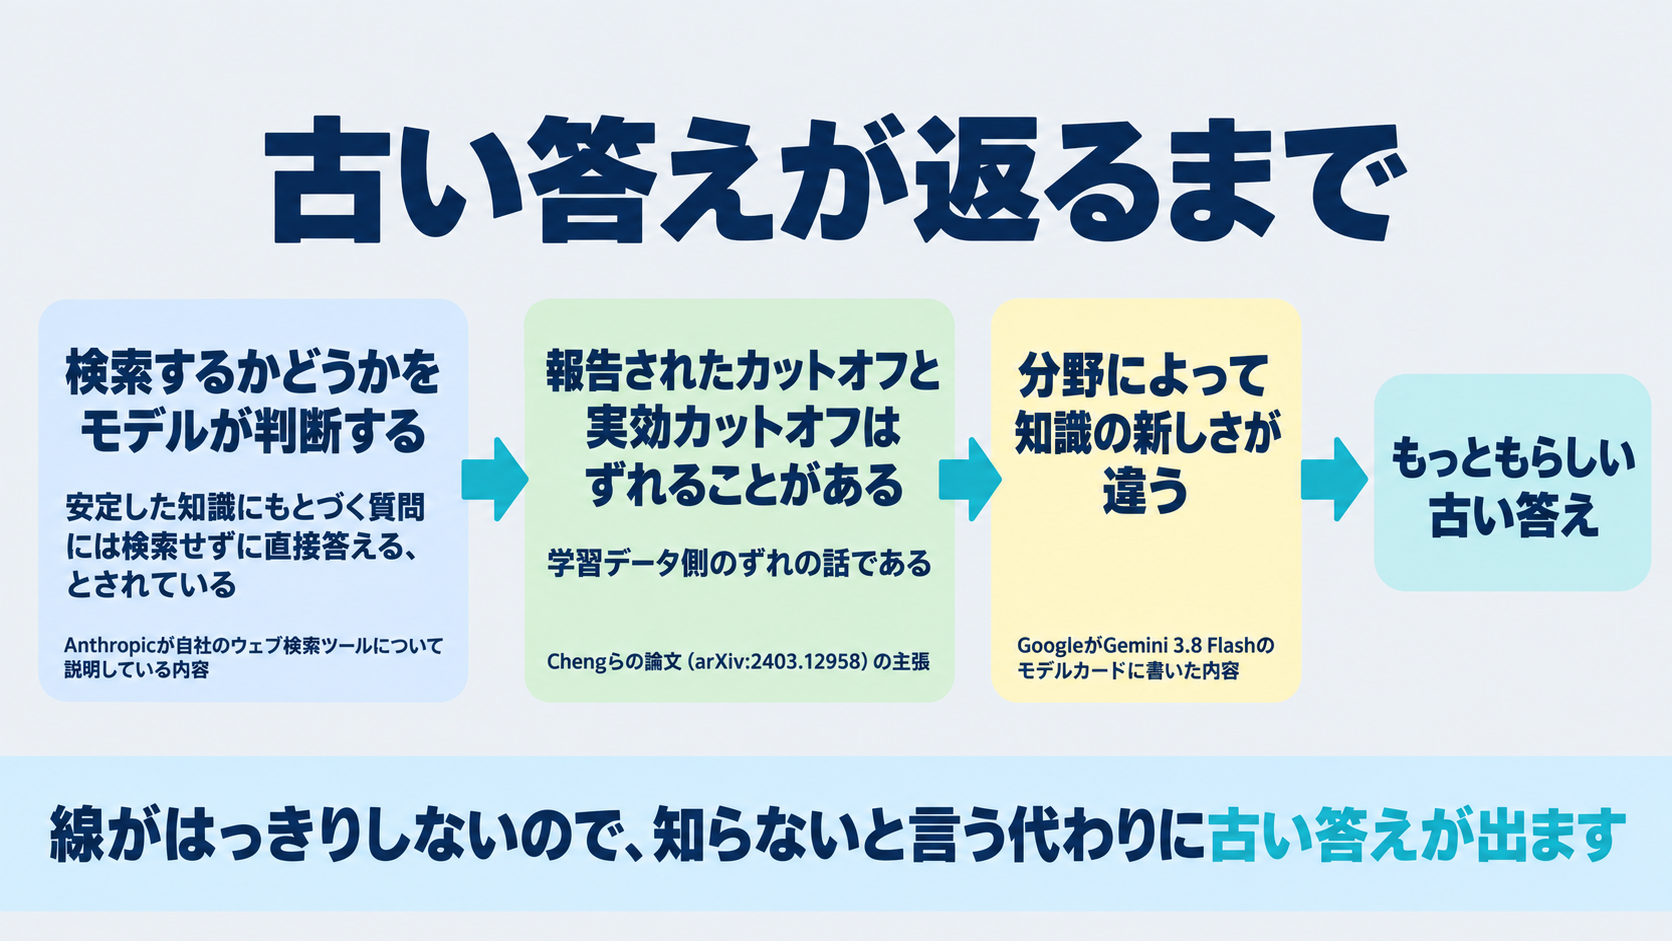
理由として考えられるものを、確認できた一次情報の範囲で3つ挙げます。
1つめは、毎回検索するとは限らないことです。
Anthropicは自社のウェブ検索ツールについて、現在進行形の情報や変わりやすい情報、学習データの外にある情報が必要なときに検索すると説明しています。
一方で、安定した知識にもとづく質問には検索せずに直接答えるとも書いています。
ここに落とし穴があります。制度や料金のように「変わった」ことを読者だけが知っている話題は、モデルの側から見ると安定した知識に見えることがあります。
2つめは、公表されたカットオフと実際の知識の範囲がずれうることです。
Cheng らによる論文「Dated Data: Tracing Knowledge Cutoffs in Large Language Models」があります。
この論文は、提供元が報告したカットオフとは区別される「実効カットオフ」という概念を定義し、両者はしばしば食い違うと報告しています。
著者らは原因として、ウェブ収集データの新しい塊にも相当量の古いデータが混じること、そして重複除去の難しさを挙げています。
同論文は、カットオフは見かけほど単純ではないと結論づけています。この論文が扱っているのは学習データ側のずれであり、モデルに日付を尋ねたときの答えの正しさではありません。
3つめは、分野によって新しさが違うことです。これは前の見出しで見たGoogleの注記のとおりです。
3つに共通しているのは、モデルの側に「この日付から先は知らない」という明確な線がないことです。線がないので、知らないと申告する代わりに、手持ちの知識で答えを組み立てます。
その結果が、もっともらしい古い答えになります。事実でない内容を自信をもって答える現象はハルシネーションとして整理されていますが、古い情報をそのまま答えるのは、作り話とは別の経路です。
だからこそ、プロンプトの側で「いつ時点の情報か」を明示的に求める意味があります。

仕事で使うとき、何を決めておけばよいのか
ここまでを踏まえると、業務で決めておくとよいことが見えてきます。
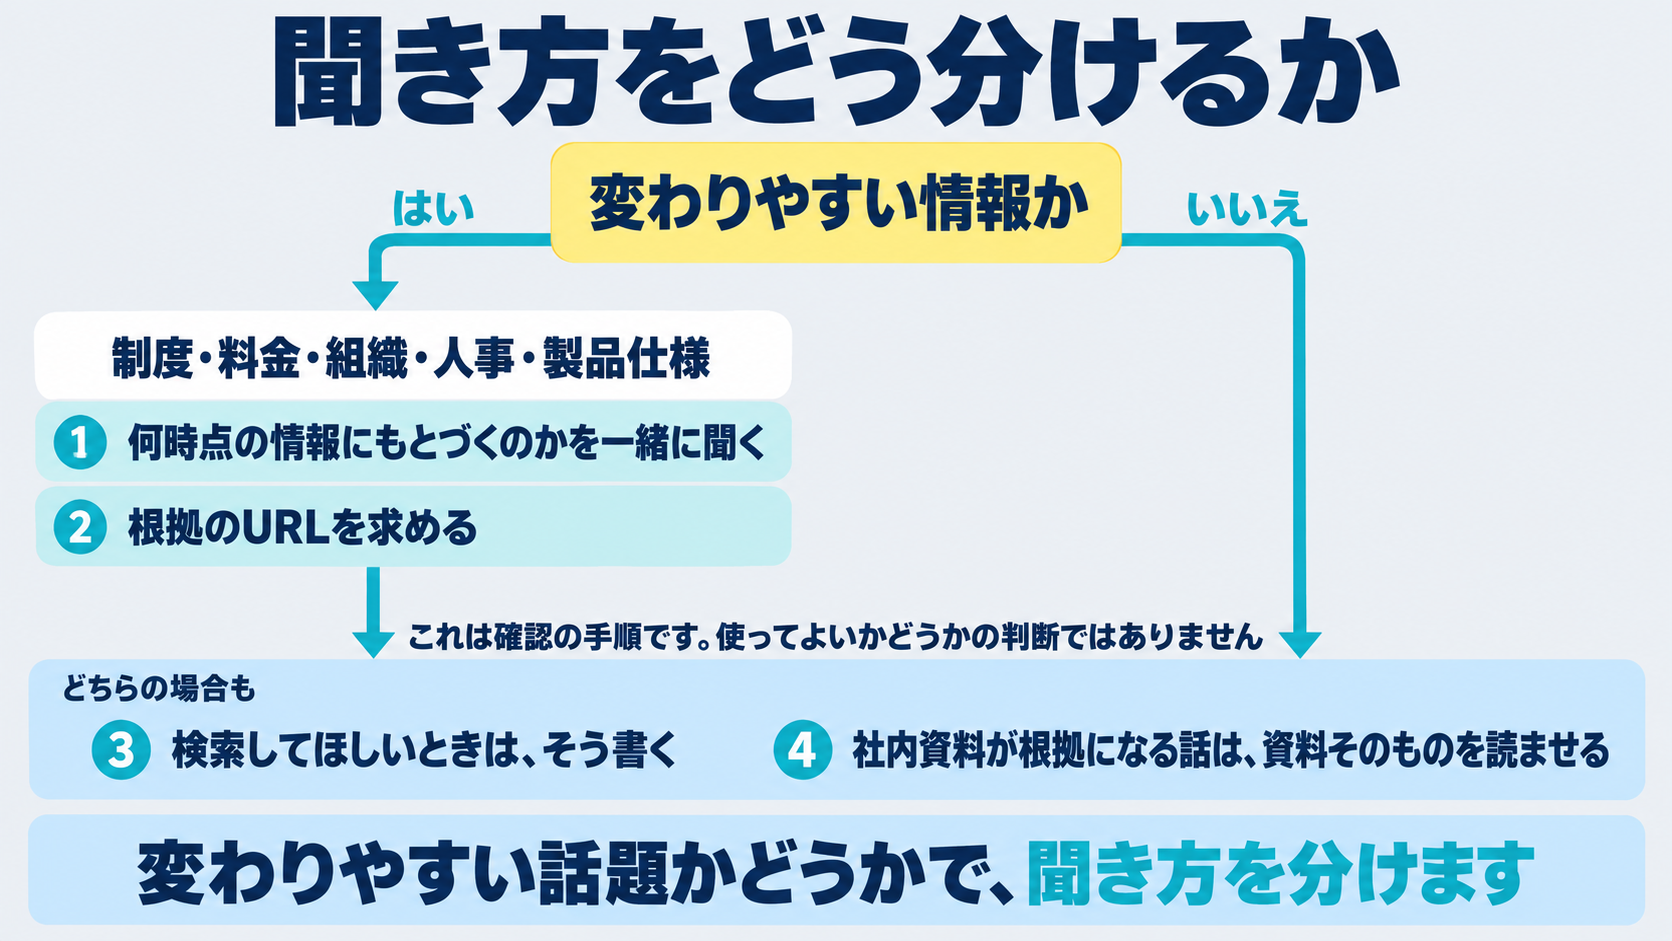
変わりやすい情報かどうかで、聞き方を分けます。制度・料金・組織・人事・製品仕様は変わりやすい側です。
変わりやすい側を尋ねるときは、回答が何時点の情報にもとづくのかを一緒に聞きます。答えの根拠となるURLを求めておくと、確認先がそのまま手に入ります。
検索をしてほしいときは、そう書きます。前の見出しのとおり、検索するかどうかはモデルの判断に委ねられている場合があります。
社内の資料が根拠になる話は、資料そのものを読ませます。ただし一度に読ませられる量には上限があり、これはコンテキストウィンドウと呼ばれる制約です。

学習側を調整するファインチューニングという手段もありますが、これは読ませて答えさせる方法とは別の道具です。目的が違うので、置き換えとして考えないほうが安全です。

そして、確認が要る話題かどうかを判断するのは人間の側という前提を、チームで共有しておくことになります。
自社の業務に合わせてどう組み立てるか迷う場合は、ご相談いただければ具体的な進め方を一緒に検討します。
結局、何を覚えて帰ればよいのか
最後に4つだけ整理します。
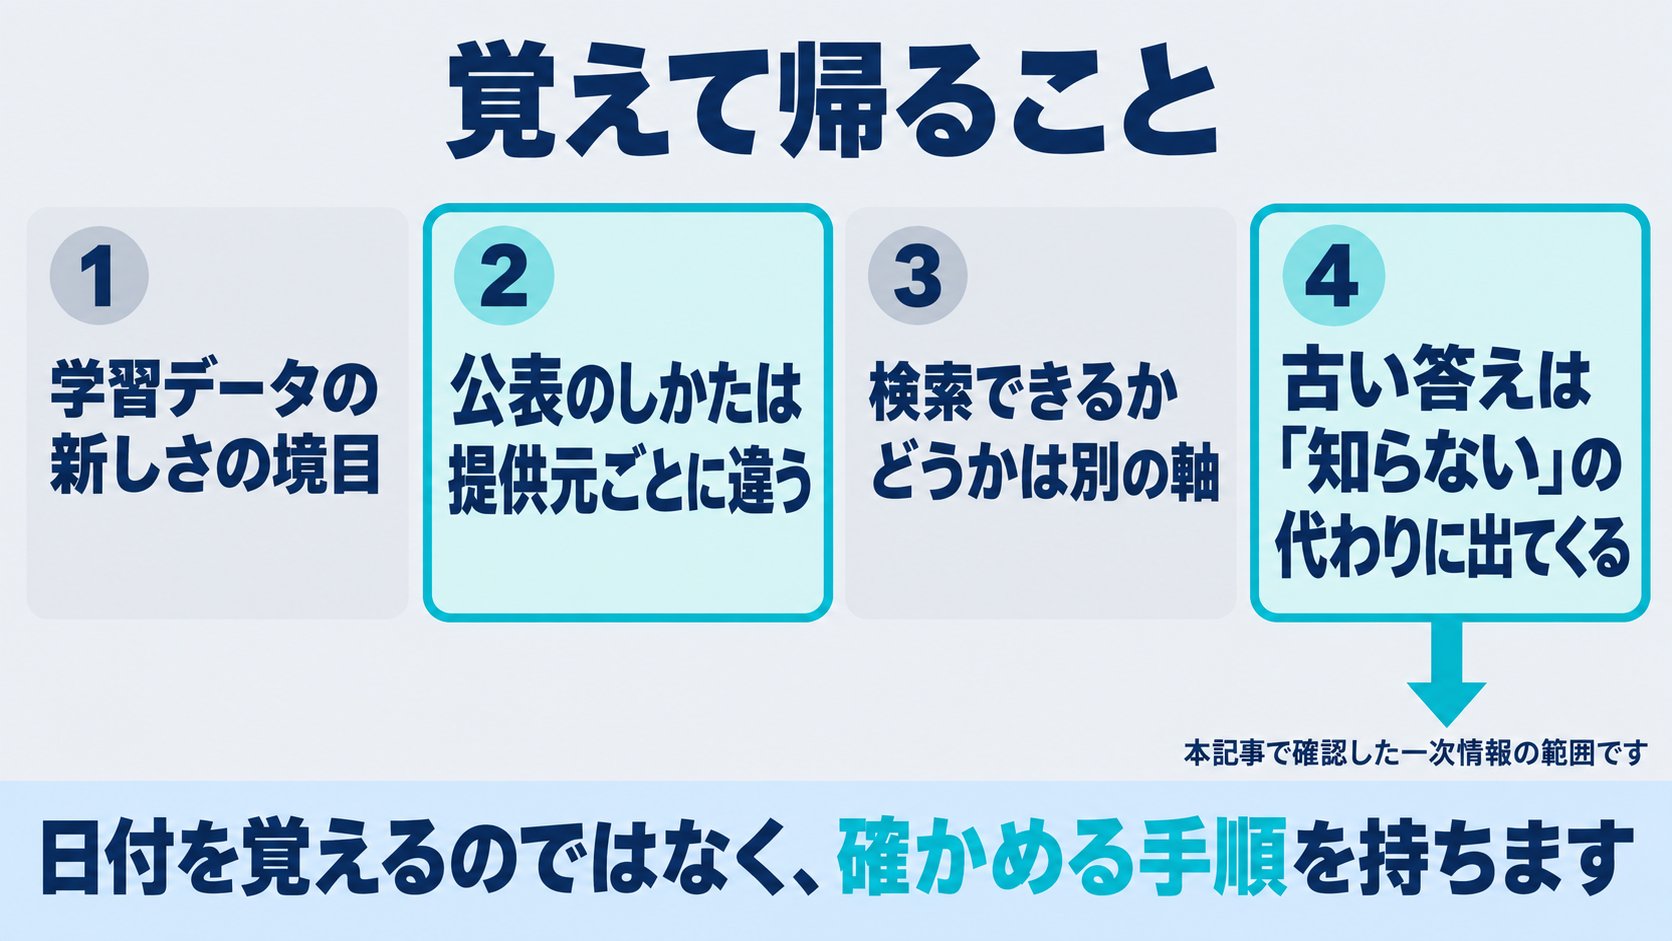
ナレッジカットオフは、モデルが学習に使ったデータの新しさの境目を指す言葉として使われています。経理や検査のカットオフとは別の言葉です。
公表のしかたは提供元によって違います。日付単位のところもあれば月単位のところもあり、同じモデルについて2つの日付を公表している例も、分野によって違うと注記している例もありました。
カットオフと「最新情報を扱えるか」は別の軸です。ウェブ検索やRAGを使えばカットオフの先も扱えると、3社とも公式ドキュメントに書いています。
それでも古い答えが返ることがあります。モデルの側に明確な線がないため、知らないと申告する代わりに手持ちの知識で答えが組み立てられるからです。
だから、日付を暗記するのではなく、確かめる手順を持っておくほうが長く使えます。
出典
本記事で確認した一次情報は次のとおりです。いずれも2026年9月18日に本文を確認しました。
- Anthropic「Models overview」
- Anthropic「Model deprecations」
- Anthropic「Transparency Hub」
- Anthropic「Web search tool」
- OpenAI「Models」
- OpenAI「GPT-5.6 Sol」
- OpenAI「Web search」
- Google「Gemini API: Gemini 2.5 Pro」
- Google「Gemini API: Gemini 3.8 Flash」
- Google DeepMind「Gemini 3.8 Flash model card」
- Google DeepMind「Gemini 3.1 Pro model card」
- Google「Grounding with Google Search」
- Jeffrey Cheng ほか「Dated Data: Tracing Knowledge Cutoffs in Large Language Models」(arXiv:2403.12958)
この記事は役に立ちましたか?
感想は、今後の記事改善に活用します。
関連記事
プロンプトキャッシュとは?生成AIの入力を使い回して料金を下げる仕組み|効く条件と効かない場面
プロンプトキャッシュは、生成AIに毎回送る同じ前置きの計算結果を再利用して、入力の料金を下げる仕組みです。Windowsのコマンドプロンプトのキャッシュ削除とは別の言葉です。割引率も最小トークン数も保持時間も提供元とモデルで違うので、OpenAI・Anthropic・Google・AWSの公式ドキュメントから条件ごと整理しました。
A2Aプロトコル(Agent2Agent)とは?MCPとの違いは「つなぐ相手がツールかエージェントか」|v1.0はいつ出たか
A2Aプロトコル(Agent2Agent)は、別々のベンダーが作ったAIエージェント同士をつなぐためのオープン標準です。決済分野でいうA2A(口座間の直接送金)とは別の言葉です。MCPとの関係、仕様がv1.0になった時期、試す前の確認点を、A2AとMCPの公式ドキュメントおよび公式ブログから整理しました。
知識蒸留とは?大きいモデルの答えで小さいモデルを訓練する仕組み|量子化との違いと「禁止」と検索される理由
知識蒸留は、大きいモデルに答えを出させ、その答えで小さいモデルを訓練する手法です。お酒や化学の蒸留とは別の話です。量子化や枝刈りとの違いと、OpenAI・Google・Anthropic・Metaの契約・規約・ライセンスに実際に書かれている文言を、それぞれが誰に向けた文書かも添えて、原論文と各社の公式ドキュメントから整理しました。
llms.txtとは?AI向けの案内ファイルの提案|標準規格ではなく、Google検索は「使用しない」と明記
llms.txtは、AIエージェント向けにサイトの要約とリンクをMarkdownで置こうという提案です。原文が自らを「提案」と呼んでおり、標準規格ではありません。robots.txtとも目的が違います。現行版(v2)の原文と、Google検索セントラルの記述を確認日つきで整理しました。
次のAIツール選びへ
気になるツールを並べて、料金や特徴の違いを確認できます。