知識蒸留とは?大きいモデルの答えで小さいモデルを訓練する仕組み|量子化との違いと「禁止」と検索される理由
生成AIの利用料が、思っていたより早く積み上がってきた。そう感じて、もっと安いモデルに切り替えられないかを調べはじめた方もいるのではないでしょうか。
調べていくと、モデルの一覧に「蒸留モデル」という表示が出てきます。
小さいのに賢い、という触れ込みです。ただ、なぜ小さいのに賢いのかの説明は、たいてい一行で終わっています。
そして検索窓に「蒸留」と打つと、候補に「禁止」や「違法」という語が並びます。切り替えの検討をしているだけなのに、急に落ち着かない気持ちになります。
この記事では、知識蒸留が何をする操作なのか、量子化や枝刈りと何が違うのか、そして各社の利用規約に実際にどういう文言が書かれているのかを、原論文と各社の公式ドキュメントから整理します。
規約やライセンスは4社で書き方が違いました。「禁止」の一言ではまとめられません!
この記事の監修者
AIリスキル株式会社 代表取締役
AIツールギャラリーを運営するAIリスキル株式会社の代表取締役。企業・自治体向けの生成AI研修とAI導入支援を手がけています。
実績: 大阪・関西万博 公式プログラム「AI HEROES COLLECTION」司会進行 / 神戸市デジタル人材育成エコシステム構築事業の運営 / MBS「せやねん!」「よんチャンTV」に生成AIの専門家として出演 / Felo日本初コアアンバサダー / Genspark第1期公式アンバサダー / Skywork公式アンバサダー / AKOOL公式パートナー など
知識蒸留とは何をすることなのか
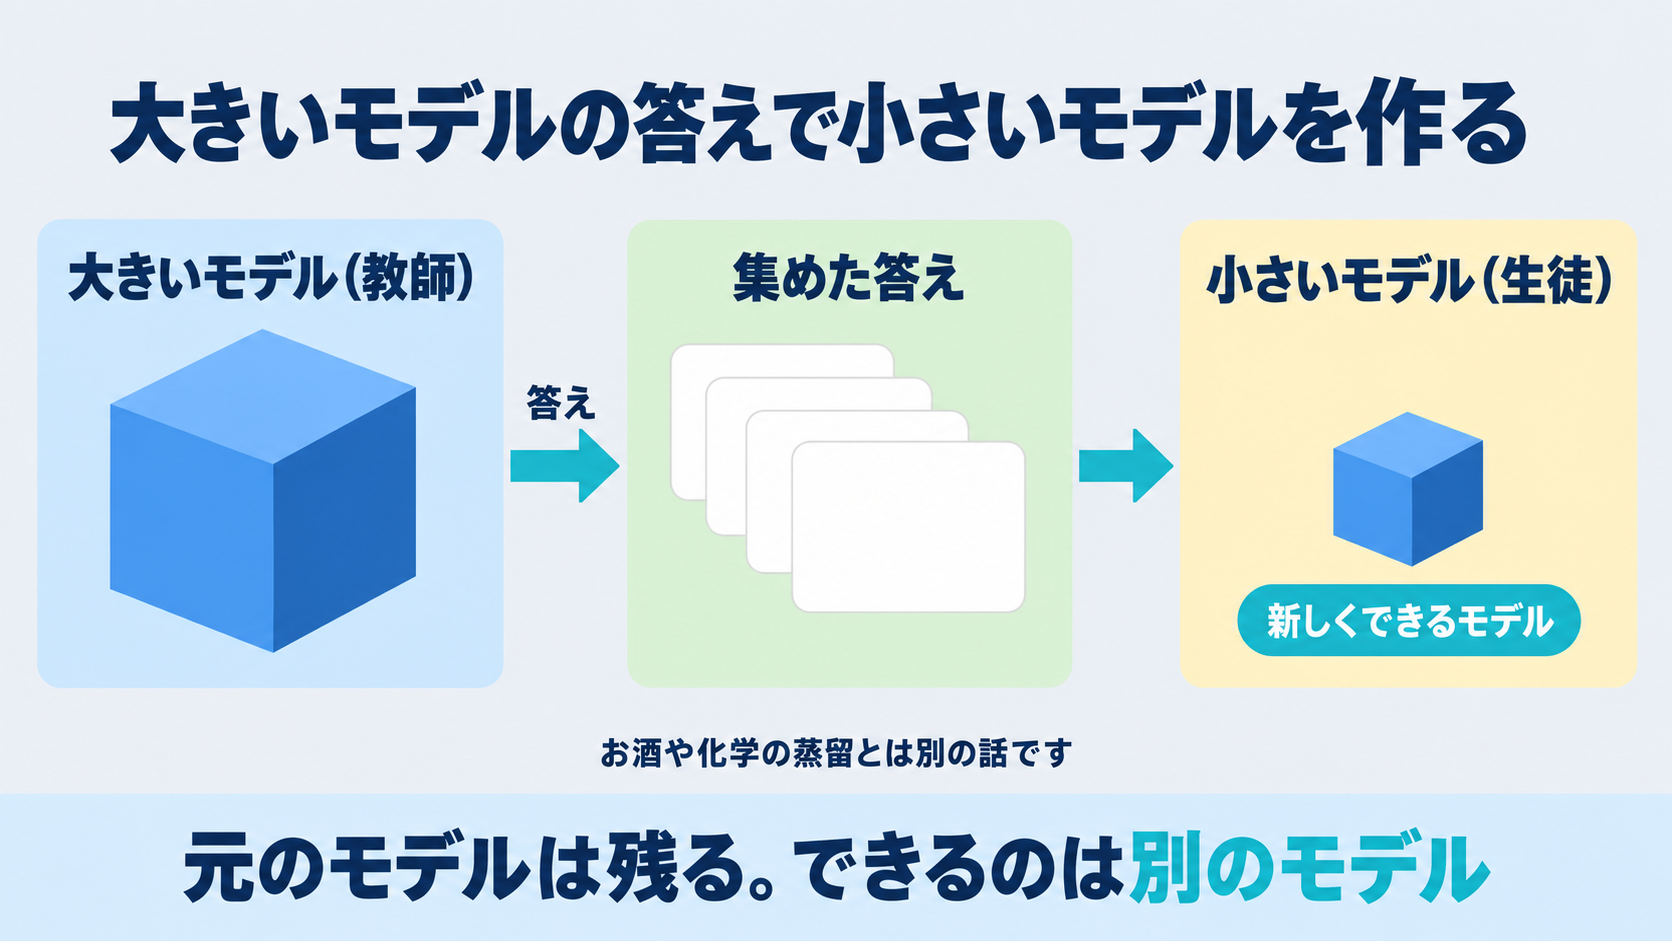
はじめに、まぎらわしい言葉を切り分けておきます。
ここで扱う蒸留は、お酒づくりや化学の蒸留とは別の話です。液体を熱して成分を分ける操作とは関係がありません。
言葉の出どころは、2015年に公開されたHinton、Vinyals、Deanの3氏による論文です。
この論文は、大きく扱いにくいモデルを訓練したあとで、別の種類の訓練を使って、その知識を配備に向いた小さいモデルへ移すと書いています。そしてその別の種類の訓練を、自分たちは「蒸留」と呼ぶと述べています。
つまり蒸留という呼び名は、この論文が与えたものです。
ただし、この論文が最初の発見者を名乗っているわけではありません。同論文は、アンサンブルの知識を単一のモデルへ圧縮できることを示したのはCaruanaらであり、自分たちはそれを別の圧縮手法で発展させたと明記しています。
では、いま使われている大規模言語モデルの文脈では、どう説明されているのでしょうか。
Amazon Bedrockの公式ドキュメントは、モデル蒸留をより大きく賢いモデル(教師と呼ばれる)から、より小さく速くコスト効率のよいモデル(生徒と呼ばれる)へ知識を移す処理と定義しています。
ここで注目したい点があります。同ドキュメントは続けて、生徒モデルの性能が「特定のユースケースについて」向上すると書いています。
全体的に賢くなる、とは書かれていません。この限定は、この記事の最後まで効いてきます。
なお蒸留は、基盤モデルのように広い用途に使える大きいモデルから、用途を絞った小さいモデルを作る、という向きで語られます。
なぜ正解だけでなく、教師の間違え方まで写すのか
小さいモデルを訓練するなら、正解を教えればよさそうに見えます。原論文は、そこに別の見方を置きました。
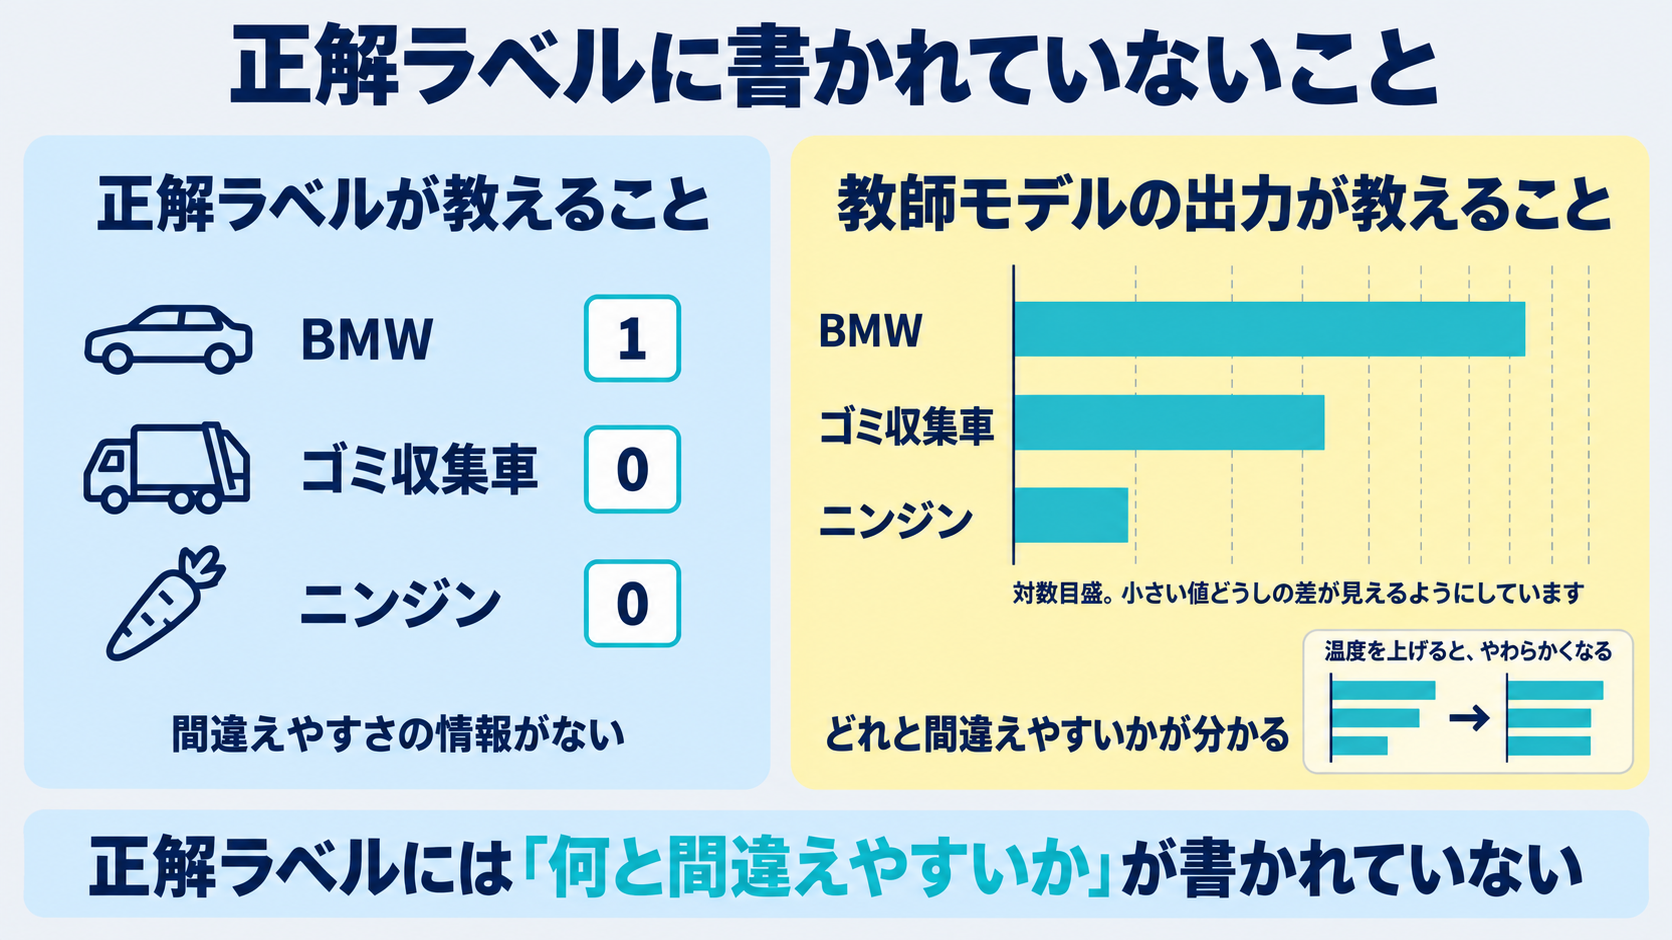
訓練されたモデルは、不正解の選択肢にも確率を割り振っています。その確率はどれも小さいのですが、小さいなりに大きさの差があります。
論文はこの差に意味があると書いています。不正解どうしの相対的な確率が、大きいモデルがどう一般化する傾向にあるかを多く教えてくれるという説明です。
そして具体例として、BMWの画像が挙げられています。
論文が書いているのは、BMWがゴミ収集車と間違われる確率はごくわずかでも、その間違いはニンジンと間違えるよりは何倍も起こりやすい、という趣旨の説明です。
「BMWはゴミ収集車には少しだけ似ているが、ニンジンには似ていない」という知識が、正解ラベルには含まれていません。教師モデルの出力には含まれています。
そこで論文は、この小さな差を見えやすくする工夫を導入しました。
出力を確率に変えるときに使う温度という値です。論文は、この値は通常は1に設定されるもので、大きくすると分布がやわらかくなると説明しています。
やわらかい分布を教師の答えとして使い、生徒を訓練します。論文は、訓練のあいだは同じ高い温度を使い、訓練が終わったあとは温度1で使うと書いています。
実装の具体が公開されている例も見ておきます。
Hugging Faceの公式ガイドは、教師と生徒の出力をそれぞれ温度で割り、KLダイバージェンスという尺度で両者のずれを測る手順を示しています。同ガイドの例では、温度に5、蒸留側の重みに0.5を使っています。
ただしこれは、そのガイドが例として選んだ値です。どんな場合にも使う標準値としては書かれていません。
効果の実例も、同じガイドが公表しています。豆の葉の画像を分類する課題で、蒸留したMobileNetがテストセットで72%、同じ条件でゼロから訓練した同じMobileNetは63%でした。
これは画像分類での一例です。大規模言語モデルでこの差がどうなるかは、本記事で確認した範囲では公表された比較数値を見つけられませんでした。
量子化や枝刈りとは、何が違うのか
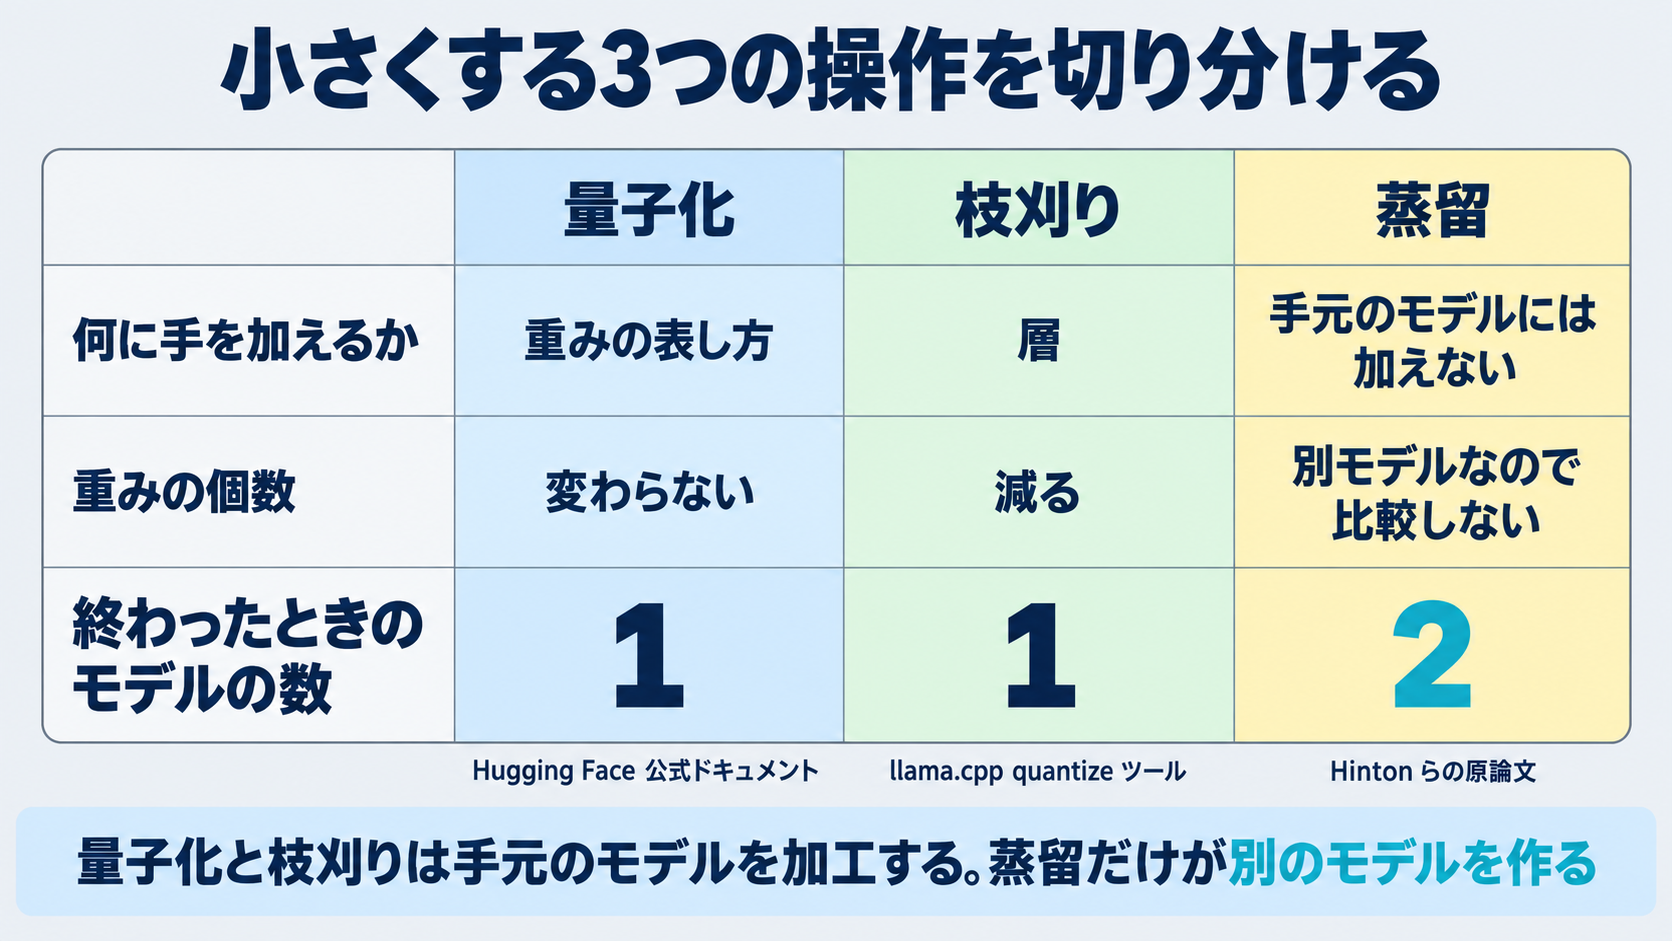
モデルを軽くする話として、蒸留・量子化・枝刈りはまとめて語られがちです。この3つは別の操作です。
量子化は、重みの持ち方を変えます。Hugging Faceの公式ドキュメントは、量子化を重みをより低い精度で保存することで、モデルの読み込みと使用に必要なメモリを下げるものと説明しています。
重みの個数は変わりません。詳しくはLLMの量子化で扱っています。
枝刈りは、取り除きます。llama.cppのquantizeツールには、リストで指定した層を取り除くというオプションが、量子化とは別に用意されています。
同ツールの使用例には、量子化をせずに層だけを取り除く書き方も載っています。同じツールの中で独立した操作として扱われていることが、両者が別物だと示しています。
蒸留は、別のモデルを訓練します。原論文が書いているのは、大きいモデルの知識を小さいモデルへ移すための訓練です。
ここが3つのうちで最も性質が違う点です。量子化と枝刈りは、いま手元にあるモデルを加工します。
蒸留は、手元のモデルを加工しません。新しいモデルを作ります。
もう一つ、混同されやすい組み合わせに触れておきます。
蒸留して作ったモデルと、小規模言語モデル(SLM)は、重なることも重ならないこともあります。SLMははじめから小さく作られたモデルという意味であり、その小ささをどう実現したかまでは指していません。
「小さい」という結果と、「蒸留で作った」という来歴は、別の情報です。配布ページの表示を読むときは、この2つを分けて見ることになります。
ファインチューニングとは、どういう関係なのか
「蒸留とファインチューニング、どちらを選ぶべきか」という形の問いをよく見かけます。
公式ドキュメントの書き方を見ると、そもそも並んだ選択肢として書かれていません。
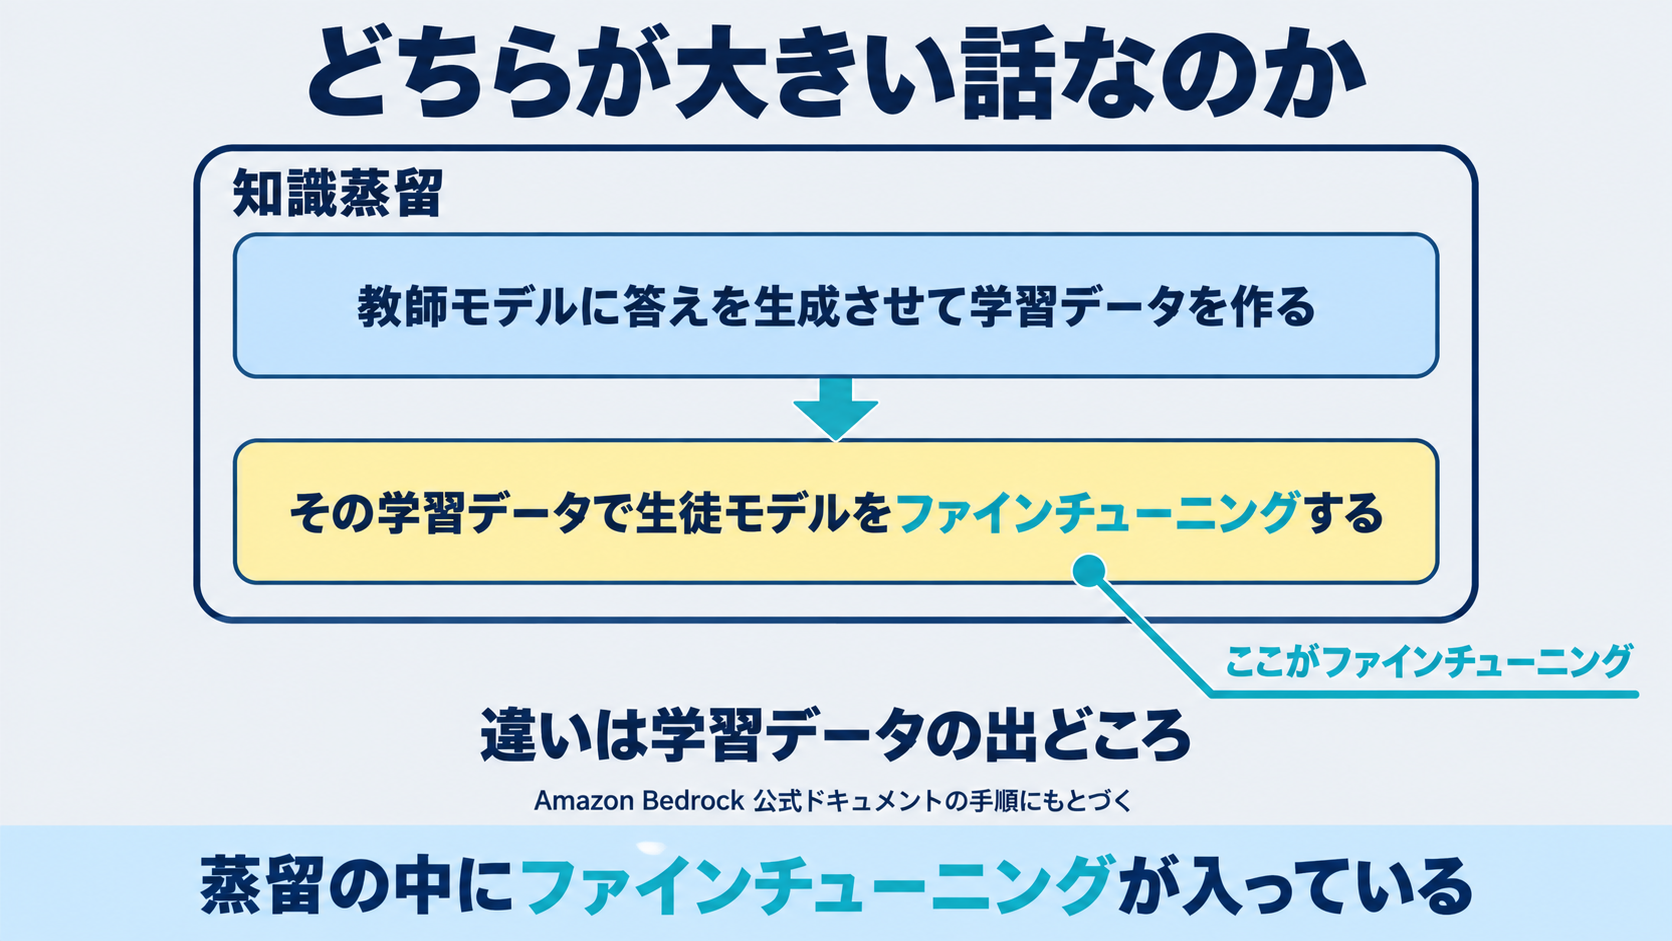
Amazon Bedrockの公式ドキュメントは、同社のモデル蒸留について、教師モデルから多様で質の高い応答(合成データ)を生成し、生徒モデルをファインチューニングすると説明しています。
つまり蒸留の手順の中に、ファインチューニングが入っています。
ファインチューニングは、用意した学習データでモデルの重みを更新する手続きです。蒸留はそこに、学習データを人が用意するのではなく、大きいモデルに作らせるという段取りを足したものになります。

言い換えると、違いは学習データの出どころです。
自社で書いた正解例を使えば、ふつうのファインチューニングです。大きいモデルに答えさせたものを使えば、公式ドキュメントが蒸留と呼んでいる形になります。
実際のサービスでは、どう提供されているのか
自分で訓練コードを書く必要があるように見えますが、そうとは限りません。主要なサービスが手順として提供しています。
Amazon Bedrockの場合です。
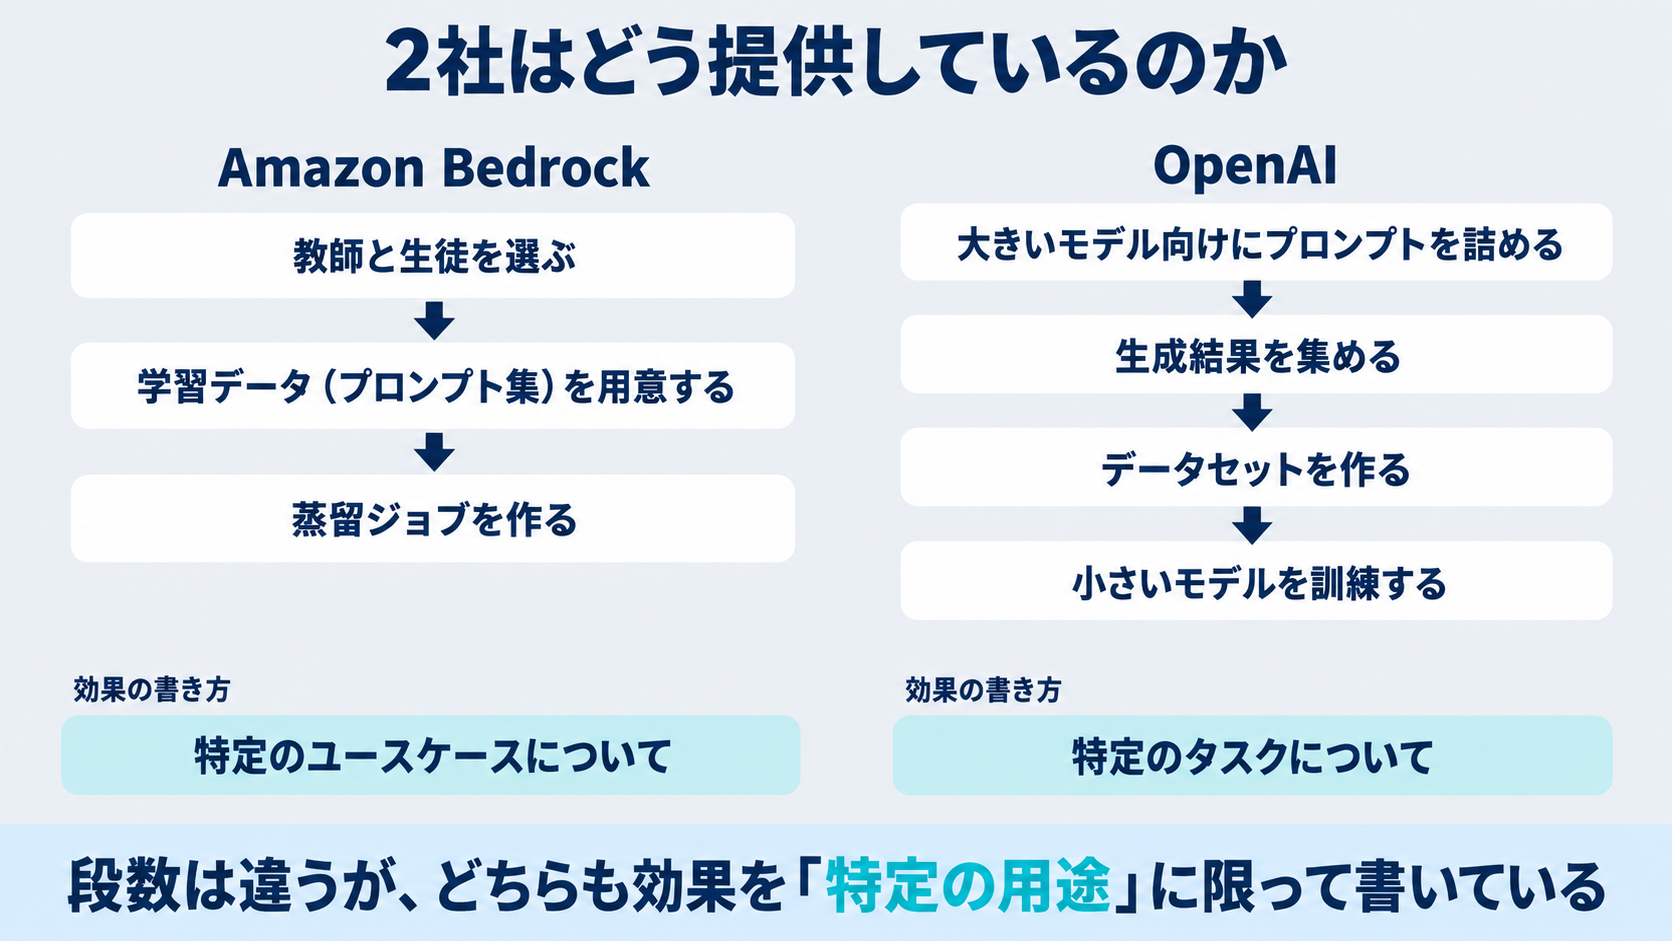
公式ドキュメントは、教師モデルと生徒モデルを選ぶ、学習データを用意する、蒸留ジョブを作るという3段で説明しています。
用意する学習データはプロンプトの集まりであり、同社のサービスがそのプロンプトで教師モデルに回答を生成させ、その回答で生徒モデルを訓練します。
もう一つの選択肢として、本番の呼び出し履歴(invocation logs)を学習データに使う方法も書かれています。すでに動かしているものがあれば、そこから始められるという設計です。
注記もあります。同ドキュメントは、データ合成の技術を使う場合は教師モデルへの推論呼び出しぶんの料金が追加でかかること、合成によって学習データが最大で15,000件のプロンプトと応答の組まで増えうることを書いています。
OpenAIの場合です。
同社のAPIドキュメントには、より大きいモデルから蒸留するという見出しの節があります。
書かれている流れは、大きいモデル向けにプロンプトを詰める、生成結果を集める、集めた結果からデータセットを作る、小さいモデルをそのデータセットで訓練するの4段です。
同ドキュメントには、Responses APIは応答を既定で30日間保存するという注記も添えられています。集める作業の前提になる条件です。
ここで、両社に共通する書き方に注目してください。
Bedrockは特定のユースケースについて性能が上がると書き、OpenAIは特定のタスクについて大きく高価なモデルと同じように振る舞わせられると書いています。
どちらも、用途を限定した言い方をしています。トークンあたりの単価が下がっても、当てはまる範囲は自社で確かめる必要がある、という構図です。

なお、生徒側に重みを配布しているモデルを選べば、訓練後のモデルを自社の環境に置く選び方もできます。配布条件の読み方はオープンウェイトモデルで扱っています。

「禁止」と一緒に検索されているのは、何が書かれているからなのか
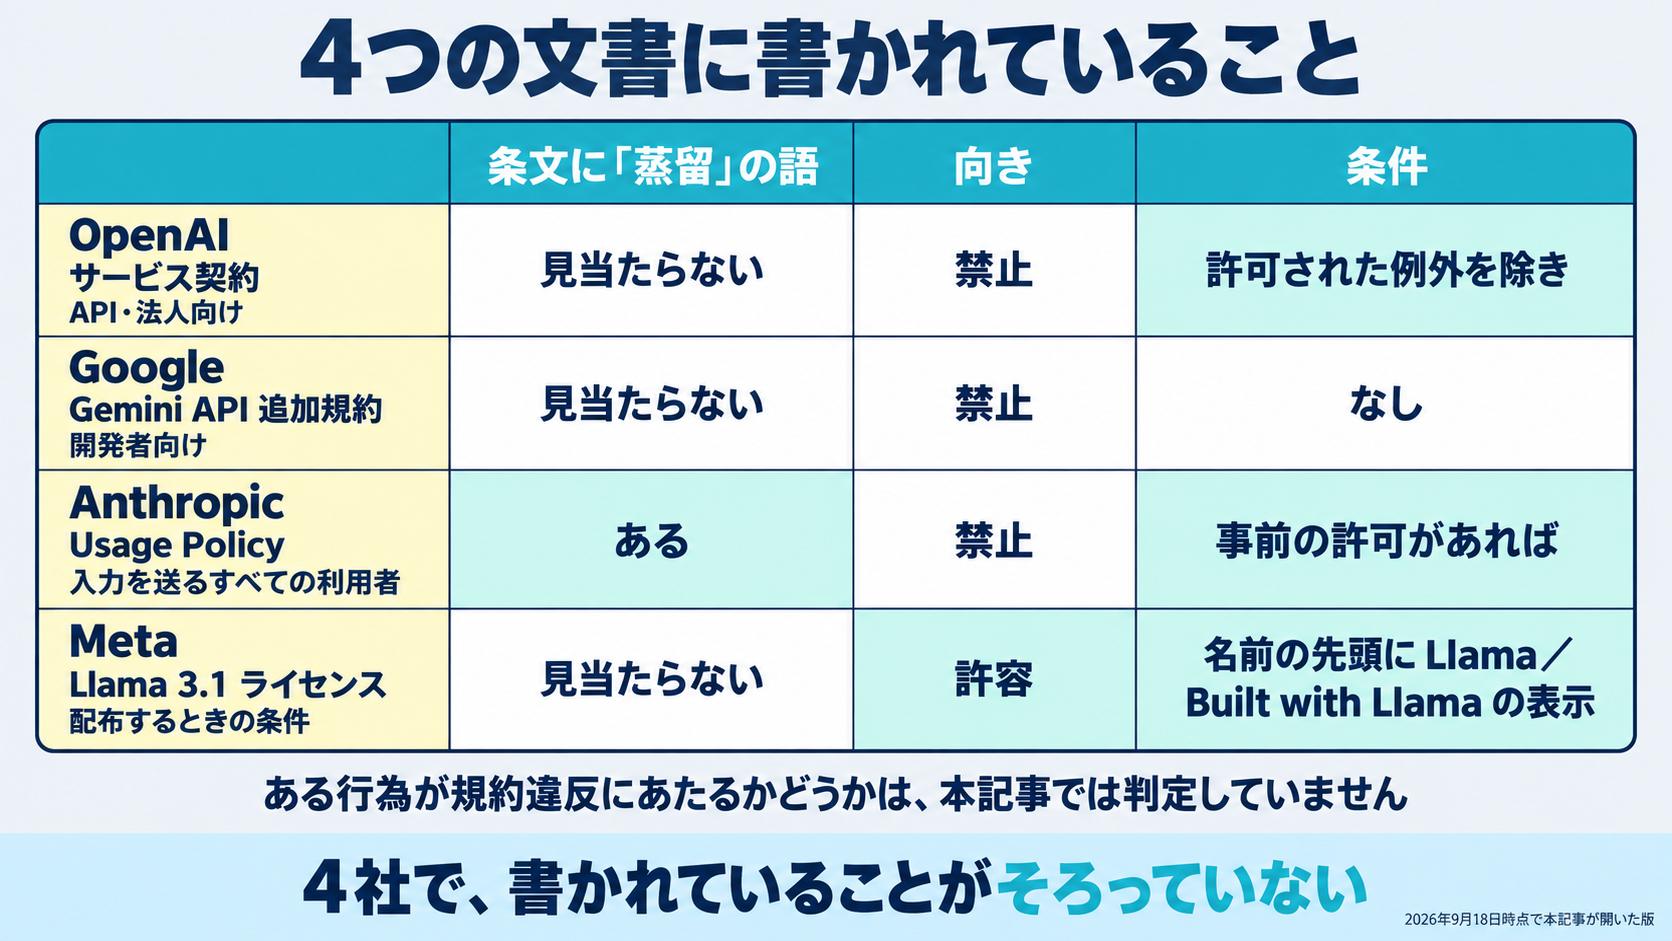
ここからは、検索候補に並ぶ「禁止」という語の背景を見ます。
はじめにお断りします。本記事は、ある行為が規約違反にあたるかどうかを判定しません。各社の文書に何が書かれているかを、確認した版のまま記します。
判断が必要な場合は、自社の契約内容にもとづいて確認することになります。
本記事が2026年9月18日に開いた4つの文書は、次のようになっていました。
| 提供元(文書/誰に向けたものか) | 条文に「蒸留」の語 | 書かれている制限や条件 |
|---|---|---|
| OpenAI(サービス契約/API・法人向け) | 見当たらない | 許可された例外を除き、アウトプットを使って競合するAIモデルを開発することを禁止 |
| Google(Gemini API 追加規約/開発者向け) | 見当たらない | サービスと競合するモデルの開発を禁止。構成要素の抽出・複製の試みも禁止 |
| Anthropic(Usage Policy/入力を送るすべての利用者) | ある | 事前の許可なく、入出力をAIモデルの訓練に使うことを禁止 |
| Meta(Llama 3.1 ライセンス/配布するときの条件) | 見当たらない | 出力で別モデルを訓練することを条件付きで許容。名前の先頭に条件あり |
表の左端に、それぞれの文書が誰に向けたものかを添えました。この4つは、対象がそろっていません。
OpenAIとGoogleのものは業務・開発の利用に向けた文書です。Anthropicのものは同社に入力を送れる利用者すべてに、Metaのものは作ったモデルを配布・提供する場合に向いています。
一つずつ、書かれている文言に触れます。
OpenAIのサービス契約です。本記事が開いた版には、効力発生日として2026年1月1日と記載されていました。
この文書は冒頭で、APIや法人向けサービスの利用にのみ適用され、消費者または個人が使うOpenAIのサービスには適用されないと適用範囲を書いています。前の節で見たAPIの手順をたどる読者が結ぶのは、こちらの契約です。
制限事項の並びに、許可された例外を除き、アウトプットを使ってOpenAIの製品およびサービスと競合する人工知能モデルを開発することという項目があります。
その許可された例外も、同じ文書の定義の節に書かれています。挙げられているのは2つです。
一つは、分類や整理を主な目的とするモデルを開発する場合です。ただし第三者に配布せず、商用提供もしない場合に限られます。
もう一つは、OpenAIのファインチューニングなどのサービスの一部として提供されるモデルを、ファインチューニングまたはカスタマイズする場合です。
同じ並びには、リバースエンジニアリングを行うこと、本サービスを通じて許可されている場合を除きデータを抽出することという項目もあります。リバースエンジニアリングの定義には、モデル抽出または窃取攻撃という語が含まれています。
「蒸留」という語は、本記事が確認した版の本文には見当たりませんでした。書かれているのは、いま挙げた項目です。
なおOpenAIは、消費者・個人向けの利用規約を別に公開しています。本記事が条文を引いたのは、API・法人向けのサービス契約のほうです。
Googleの Gemini API 追加利用規約です。
サービスと競合するモデルを開発するためにサービスを使ってはならないと書かれています。
続けて、サービスの構成要素、たとえばパラメータの重みを含む基礎となるデータやモデルについて、リバースエンジニアリング・抽出・複製を試みてはならないとあります。
ここでも、「蒸留」という語は見当たりませんでした。
AnthropicのUsage Policyです。本記事が開いた版には、2025年9月15日発効と記載されていました。
プラットフォームの濫用を禁じる節に、Anthropicの事前の許可なく、入力と出力をAIモデルの訓練に使うことという項目があります。そしてその例として、「モデルスクレイピング」または「モデル蒸留」という語が挙げられています。
本記事が確認した4社のうち、条文に蒸留という語を書いているのはここだけでした。同時に、事前の許可なくという条件が付いた書き方になっています。
MetaのLlama 3.1 ライセンスです。
前の3社とは、書かれていることの向きが違います。
同ライセンスは、Llama Materialsやその出力・結果を使ってAIモデルを作成・訓練・ファインチューニング、あるいは改善し、それを配布または提供する場合について定めています。
その場合は、そのAIモデルの名前の先頭に「Llama」を含めなければならないと書かれています。
配布にあたっては、「Built with Llama」を関連するウェブサイトや製品ドキュメントなどに目立つように表示すること、および所定の帰属表示を「Notice」ファイルに保持することも求められています。
つまり禁止ではなく、条件を満たせば行える形で書かれています。
ここまでを並べて見ると、4社で書かれていることがそろっていません。禁じている対象も、条件の付き方も違います。「蒸留は禁止」という一文でまとめると、4つのうち少なくとも1つとは食い違います。
確認できなかったことも書いておきます。
各社の文書は、消費者向け・API向け・法人向けで別に用意されている場合があります。本記事が条文を引いたのは表に挙げた4つの版だけであり、すべての契約類型を確認したわけではありません。
どの文書が自社に当てはまるかは、結んでいる契約の種類で変わります。上の表は、4社を同じ条件で比べたものではありません。
また Gemini API の規約ページには、本文中の日付とページ下部の更新日という2種類の表記があり、どちらが規約の効力に関わる日付なのかを本記事では判断していません。
自社で検討するとき、何から確かめるのか
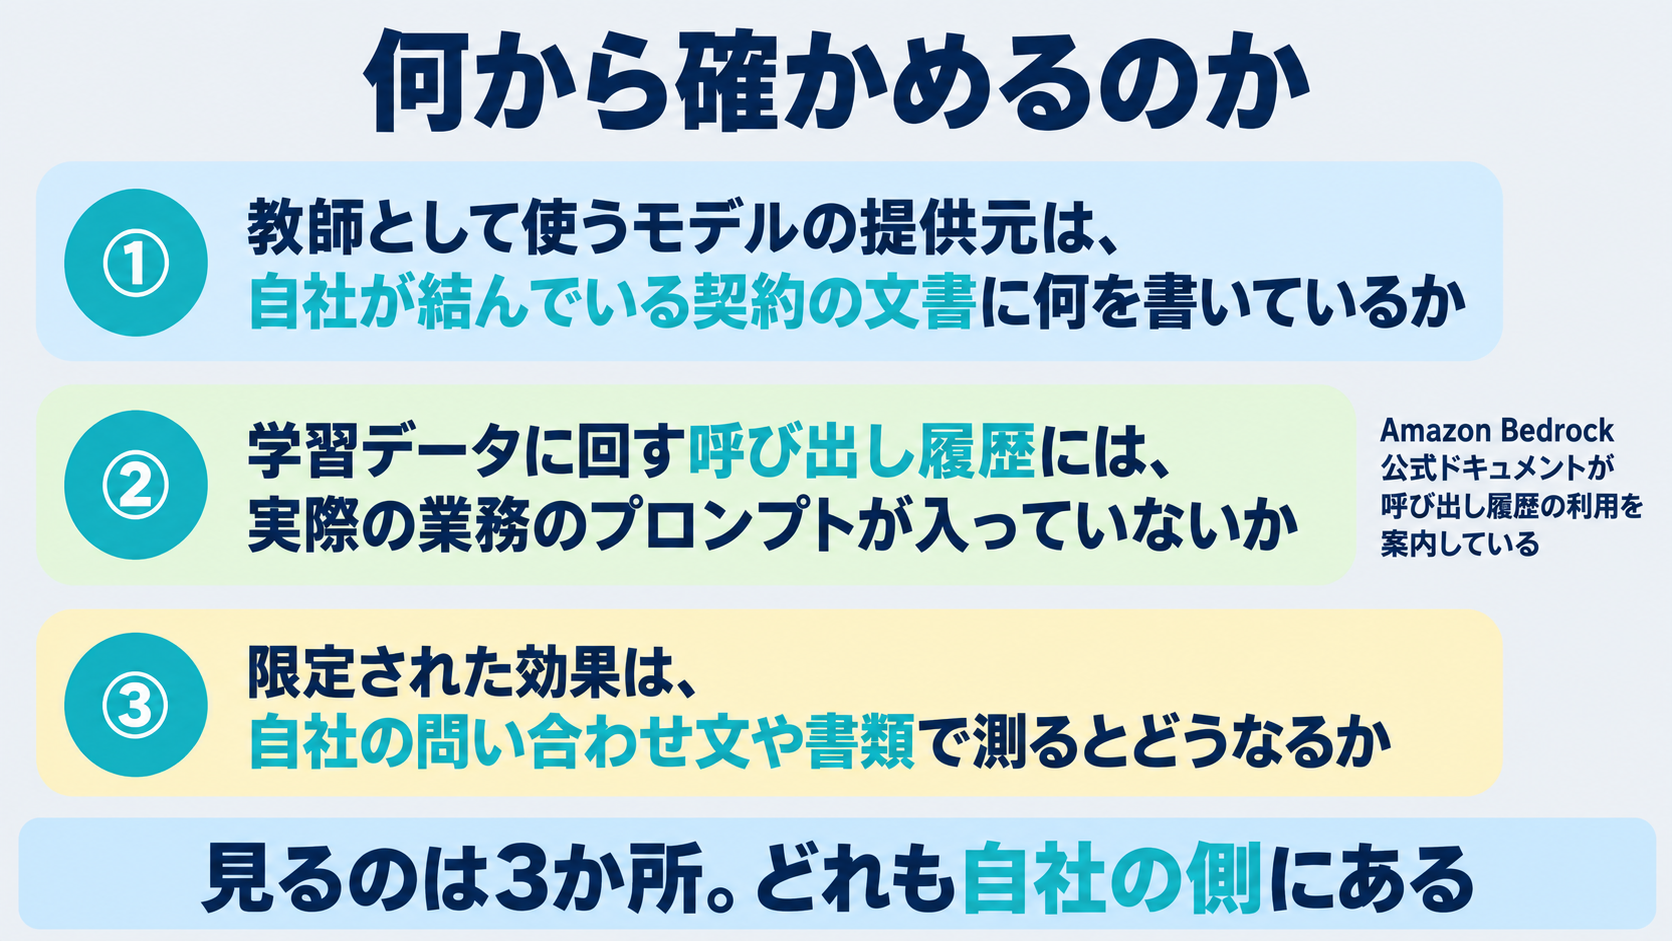
ここまでを踏まえて、検討の順番を整理します。本記事はどれが可能かを判定するものではありません。見る先を挙げます。
一つ目は、教師として使うモデルの提供元が、どの文書に何を書いているかです。
前の節で見たとおり、書かれていることは4社で違いました。自社が使うモデルの、自社が結んでいる契約の文書に何があるかを見ることになります。必要に応じて、提供元への確認や社内の法務確認も選択肢に入ります。
二つ目は、学習データに何が含まれるかです。
Amazon Bedrockの公式ドキュメントは、本番の呼び出し履歴を学習データに使う選択肢を案内しています。手間は減りますが、その履歴には実際の業務で投げたプロンプトが入っています。
同ドキュメントは、できあがった蒸留モデルには自分だけがアクセスでき、自社のデータが公開用の他のモデルの訓練に使われることはないと書いています。それでも、どの履歴を学習に回すかは自社の取り扱い基準に沿って決めることになります。
三つ目は、限定された用途を自社で測ることです。
BedrockもOpenAIも、効果を特定の用途・特定のタスクに限って書いていました。自社の問い合わせ文や書類で試した結果が、自社にとっての答えになります。
なお、そもそも外に出さずに動かしたいという動機が先にある場合は、蒸留の前にローカルLLMの条件から確認する順番もあります。

よくある質問
知識蒸留は何と読みますか
ちしきじょうりゅうと読みます。英語では knowledge distillation です。
転移学習との違いは何ですか
本記事で確認した一次情報の範囲では、両者を正面から対比して定義した記述を見つけられませんでした。確認できたことだけを書きます。
蒸留について原論文と各社のドキュメントが書いているのは、大きいモデルの出力を教師の答えとして使い、別のモデルを訓練するという手順です。出力を使う点が、蒸留の説明に共通して現れる特徴でした。
蒸留したモデルは、元の大きいモデルより性能が落ちますか
大規模言語モデルでの比較数値は、本記事で確認した範囲では公表されたものを見つけられませんでした。
確認できたのは、Hugging Faceの公式ガイドが公表している豆の葉の画像分類での例です。蒸留したMobileNetがテストセットで72%、同じ条件でゼロから訓練した同じMobileNetは63%でした。
これは小さいモデルどうしの比較であり、教師モデルとの比較ではありません。
加えて、AmazonとOpenAIの公式ドキュメントはどちらも、効果を特定の用途についてと限定して書いていました。
自分で訓練コードを書く必要がありますか
Amazon BedrockとOpenAIは、いずれも手順としての提供を公式ドキュメントで案内しています。どちらの手順にも、訓練コードを書く段は出てきませんでした。
ただし作業の内容は2社で違います。Bedrockは3段、OpenAIは4段で、OpenAIの側には生成結果を集めてデータセットを作る段が入っています。
蒸留に追加の費用はかかりますか
Amazon Bedrockの公式ドキュメントは、同社のデータ合成技術が使われる場合、教師モデルへの推論呼び出しぶんが、教師モデルのオンデマンド料金で追加請求されると注記しています。金額は本記事では扱いません。
本記事で確認した一次情報
すべて2026年9月18日に開いて内容を確認しました。
- Distilling the Knowledge in a Neural Network(Hinton, Vinyals, Dean / arXiv, 2015-03-09)
- Customize a model with distillation in Amazon Bedrock(AWS 公式ドキュメント)
- Supervised fine-tuning(OpenAI API ドキュメント)
- OpenAI サービス契約(OpenAI / API・法人向け・効力発生日 2026-01-01 と記載)
- Terms of Use(OpenAI / 消費者・個人向け・効力発生日 2026-01-01 と記載)
- Gemini API Additional Terms of Service(Google)
- Usage Policy(Anthropic / 2025-09-15 発効と記載)
- Llama 3.1 Community License Agreement(Meta)
- Knowledge distillation for computer vision(Hugging Face Transformers ドキュメント)
- Quantization Overview(Hugging Face Transformers ドキュメント)
- llama.cpp quantize ツール README(ggml-org)
まとめ
知識蒸留は、大きいモデルに答えを出させ、その答えで小さいモデルを訓練する手法です。元のモデルを加工する量子化や枝刈りとは、そこが違います。
公式ドキュメントが約束しているのは、特定の用途についての性能でした。全体的に賢くなるとは書かれていません。
そして各社の文書は、誰に向けたものかも、禁じている対象も、条件の付き方もそろっていませんでした。自社が使うモデルの文書を、自社の契約に即して読むところから始まります。
どのモデルから検討を始めればよいか迷う場合は、用途と条件を伺ったうえで整理のお手伝いができます。お問い合わせはこちら。
この記事は役に立ちましたか?
感想は、今後の記事改善に活用します。
関連記事
プロンプトキャッシュとは?生成AIの入力を使い回して料金を下げる仕組み|効く条件と効かない場面
プロンプトキャッシュは、生成AIに毎回送る同じ前置きの計算結果を再利用して、入力の料金を下げる仕組みです。Windowsのコマンドプロンプトのキャッシュ削除とは別の言葉です。割引率も最小トークン数も保持時間も提供元とモデルで違うので、OpenAI・Anthropic・Google・AWSの公式ドキュメントから条件ごと整理しました。
ナレッジカットオフとは?AIが古い情報のまま答える理由|カットオフは1つとは限りません
ナレッジカットオフは、AIが学習に使ったデータの新しさの境目を指す言葉です。経理や検査のカットオフとは別の言葉です。同じモデルについて2つの日付を公表している例や、分野によって知識の新しさが違うと注記している例を、AnthropicとGoogleの公式ドキュメントとモデルカードから帰属つきで整理しました。
A2Aプロトコル(Agent2Agent)とは?MCPとの違いは「つなぐ相手がツールかエージェントか」|v1.0はいつ出たか
A2Aプロトコル(Agent2Agent)は、別々のベンダーが作ったAIエージェント同士をつなぐためのオープン標準です。決済分野でいうA2A(口座間の直接送金)とは別の言葉です。MCPとの関係、仕様がv1.0になった時期、試す前の確認点を、A2AとMCPの公式ドキュメントおよび公式ブログから整理しました。
llms.txtとは?AI向けの案内ファイルの提案|標準規格ではなく、Google検索は「使用しない」と明記
llms.txtは、AIエージェント向けにサイトの要約とリンクをMarkdownで置こうという提案です。原文が自らを「提案」と呼んでおり、標準規格ではありません。robots.txtとも目的が違います。現行版(v2)の原文と、Google検索セントラルの記述を確認日つきで整理しました。
次のAIツール選びへ
気になるツールを並べて、料金や特徴の違いを確認できます。