LLMの量子化とは?モデルを軽くすると何を引き換えにするのか|4bit・GGUF表記の読み方
社内の資料を外に出さずに生成AIを試したい。そう考えて、自社のサーバや手元のPCでモデルを動かす方法を調べはじめた方も多いのではないでしょうか。
ところが配布されているモデルの一覧を開くと、同じモデル名のファイルがずらりと並びます。
Q4_K_M、Q8_0、int4、GGUF、GPTQ、AWQ。どれも同じモデルのはずなのに、ファイルサイズだけが数倍違います。
説明を探すと「軽くしても性能はほとんど変わりません」と書かれています。ただ、それなら全員がいちばん小さいものを選べばよいはずで、選択肢が並んでいる理由が分かりません。
この記事では、LLMの量子化が何をする操作なのか、軽くすることで何を引き換えにしているのか、そしてファイル名の表記をどう読めばよいのかを、llama.cppとHugging Faceの公式ドキュメント、および各手法の原論文から整理します。
調べてみると、どれも条件つきで、無条件に「落ちません」と書いたものはありませんでした。そこが分かれ目です!
この記事の監修者
AIリスキル株式会社 代表取締役
AIツールギャラリーを運営するAIリスキル株式会社の代表取締役。企業・自治体向けの生成AI研修とAI導入支援を手がけています。
実績: 大阪・関西万博 公式プログラム「AI HEROES COLLECTION」司会進行 / 神戸市デジタル人材育成エコシステム構築事業の運営 / MBS「せやねん!」「よんチャンTV」に生成AIの専門家として出演 / Felo日本初コアアンバサダー / Genspark第1期公式アンバサダー / Skywork公式アンバサダー / AKOOL公式パートナー など
LLMの量子化とは何をすることなのか
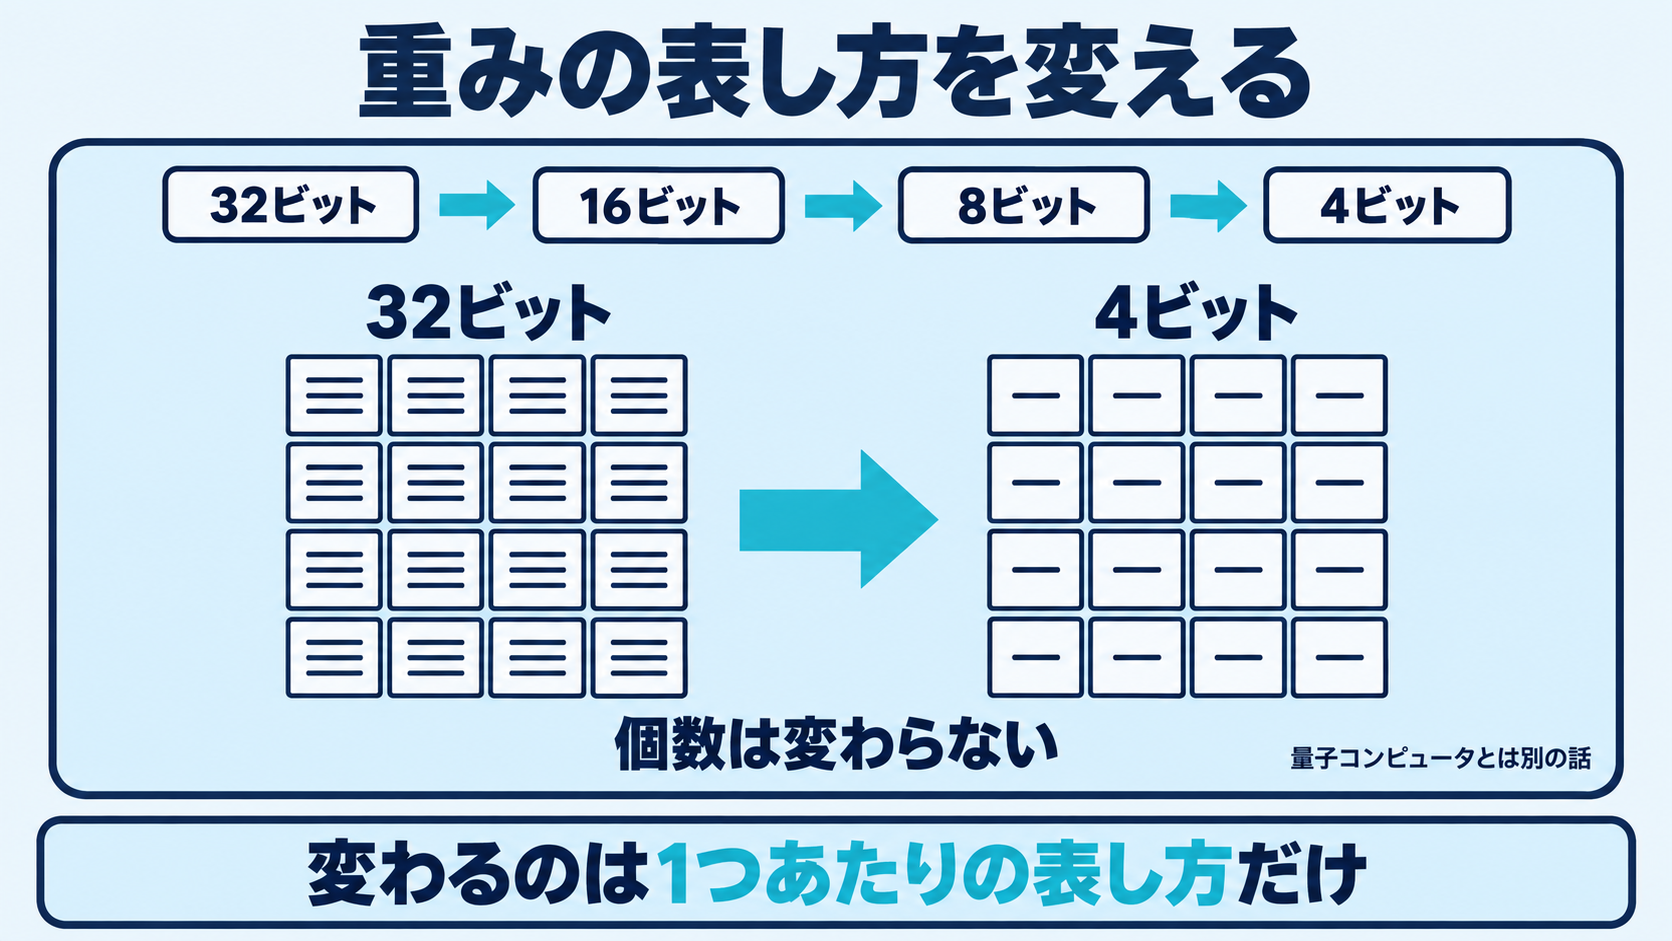
はじめに、まぎらわしい言葉を切り分けておきます。
ここで扱う量子化は、量子コンピュータとは関係がありません。信号処理や物理で使われる同じ表記とも別の話です。
Hugging Faceの公式ドキュメントは、量子化を次のように説明しています。重みをより低い精度で保存することによって、モデルの読み込みと使用に必要なメモリ量を下げ、同時に可能な限り精度を保とうとするものです。
この一文には注目すべき点があります。「精度を保つ」ではなく「可能な限り保とうとする」と書かれています。
モデルの中身は、膨大な数の重みと呼ばれる数値です。
同ドキュメントは、この数値が通常は32ビットの浮動小数点で保存され、モデルが大きくなるにつれて16ビットも使われるようになったと説明しています。手法によっては8ビットや4ビットの整数まで落とせるとも書かれています。
つまり量子化とは、数値そのものを減らすのではなく、1つの数値を表すのに使う桁数を減らす操作です。
重みの個数は変わりません。変わるのは1つあたりの表し方だけです。
この操作が意味を持つのは、オープンウェイトモデルのように重みが手に入る場合です。重みを受け取れるからこそ、手元で表し方を変えられます。

そして表し方を変える動機は、ほぼ一つに集約されます。ローカルLLMとして自分の環境で動かしたいのに、そのままでは載らないという事情です。

軽くすると、何がどれだけ変わるのか
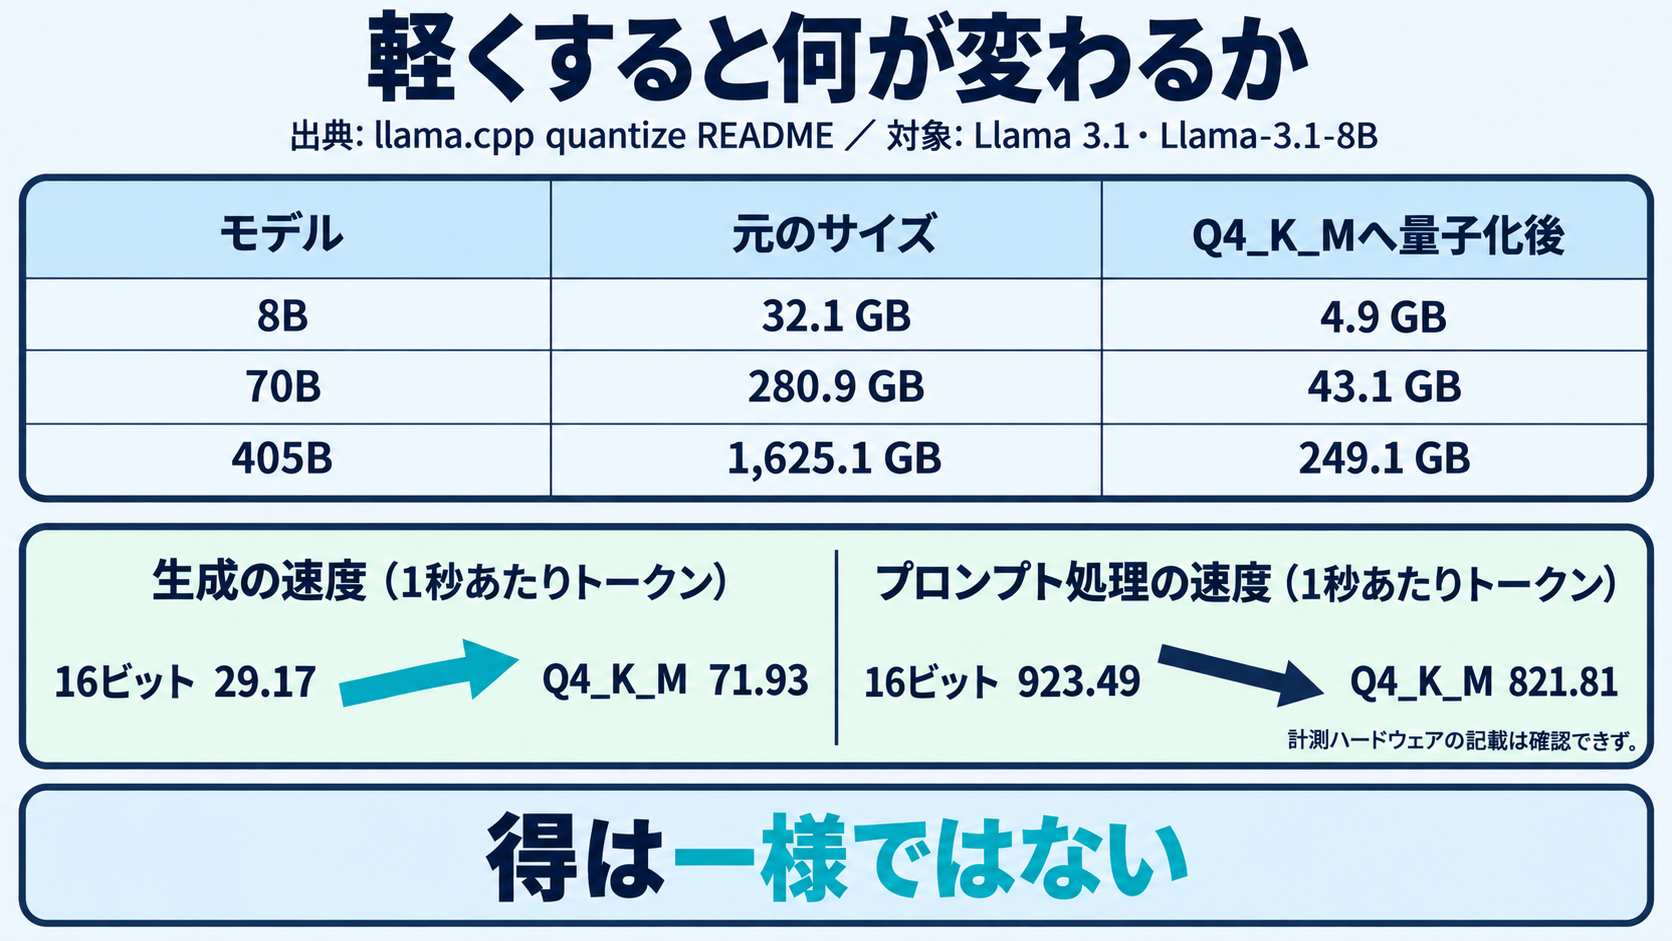
ここからは、llama.cppの公式リポジトリが公表している数値を見ます。以下はすべて、そのドキュメントに載っているLlama 3.1についての記載です。
同リポジトリのquantizeツールの説明には、必要な容量の表が置かれています。
| モデル | 元のサイズ | Q4_K_Mへ量子化後 |
|---|---|---|
| 8B | 32.1 GB | 4.9 GB |
| 70B | 280.9 GB | 43.1 GB |
| 405B | 1,625.1 GB | 249.1 GB |
同ドキュメントは、モデルが現状すべてメモリに読み込まれるため、メモリとディスクの要件は同じになると注記しています。
8Bのモデルが32.1 GBから4.9 GBになるのであれば、載らなかったものが載る可能性は出てきます。ここが量子化のいちばん分かりやすい効果です。
速度についても、同じドキュメントがLlama-3.1-8Bでの実測値を公表しています。表に記載された計測条件は、プロンプト512トークン・生成128トークンです。
文章を生成する速度は、16ビットのときが1秒あたり29.17トークン、Q4_K_Mでは71.93トークンと記載されています。トークンは文章を細かく区切った単位です。

ところが、入力したプロンプトを読み込む処理の速度は逆です。同じ表で、16ビットが1秒あたり923.49トークン、Q4_K_Mは821.81トークンとなっています。
つまり速くなる部分と、そうでない部分があります。この値はプロンプト512トークンでの計測なので、より長い資料を読ませたときにどうなるかは、この表からは分かりません。
ひとつ正直に書いておきます。この速度を計測したハードウェアの記載は、本記事で確認したページには確認できませんでした。絶対値ではなく、同じ条件での相対関係として読んでください。
「4bit」は本当に1つあたり4ビットなのか
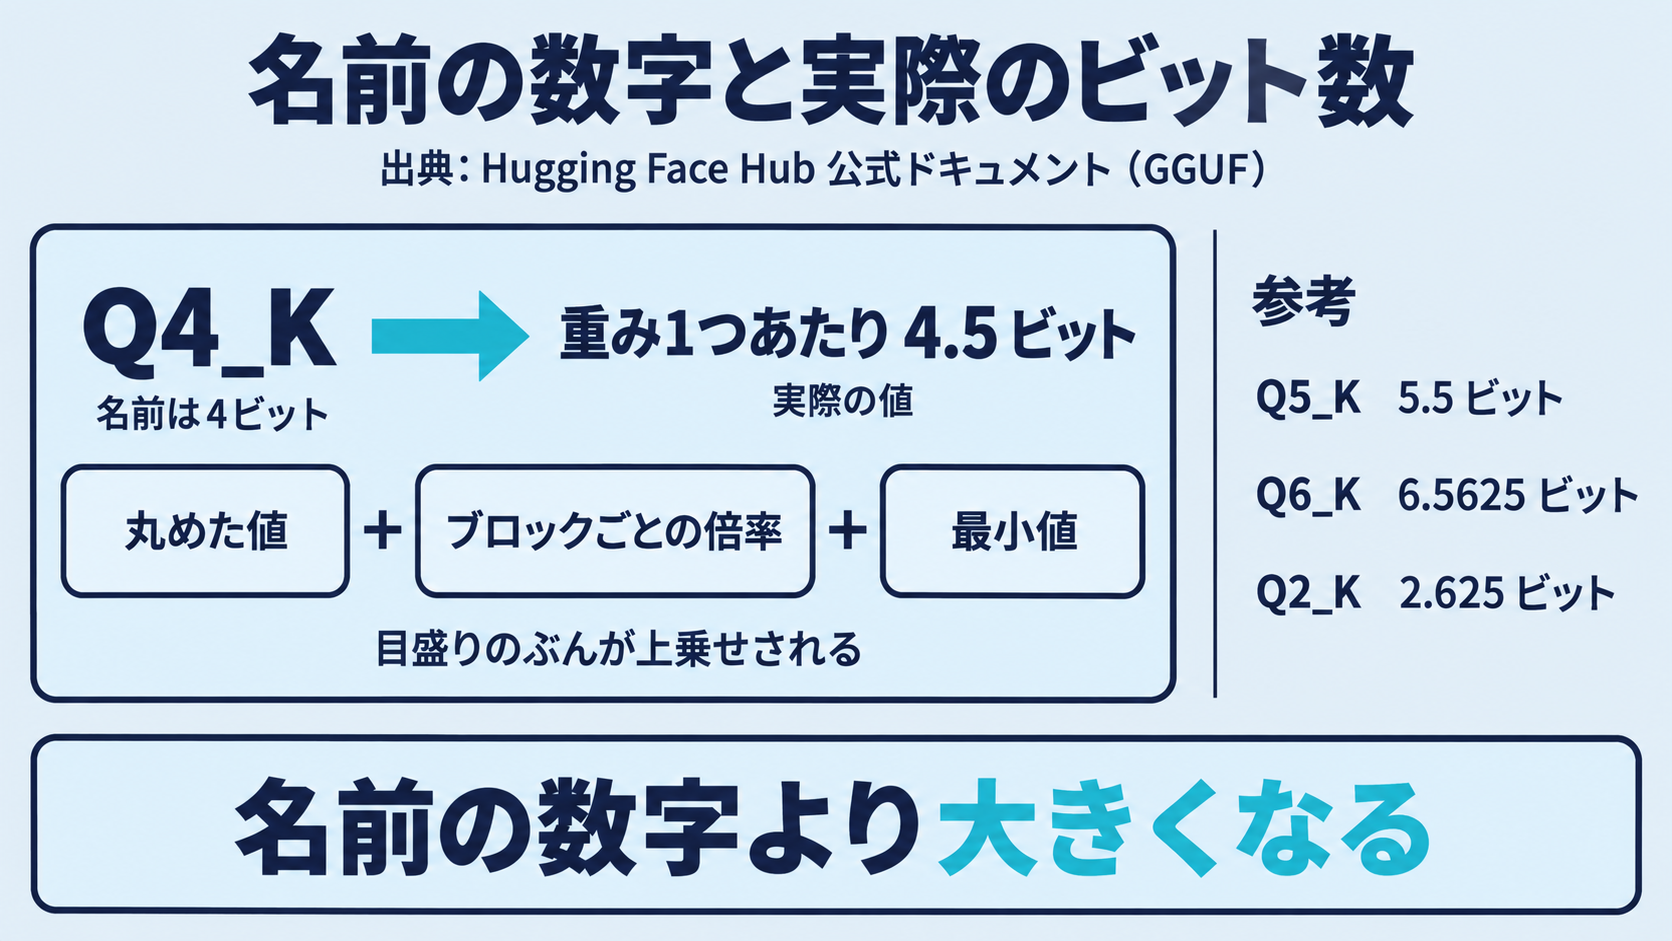
ここは見落とされやすいところです。
Hugging Face Hubの公式ドキュメントには、GGUFの量子化タイプの一覧があります。そこには主要なタイプについて、重み1つあたりのビット数が明記されています。
同ドキュメントによれば、Q4_Kは4ビット量子化と説明されていますが、結果として重み1つあたり4.5ビットになります。
Q5_Kは5.5ビット、Q6_Kは6.5625ビット、Q2_Kは2.625ビットです。いずれも名前の数字より大きくなっています。
理由も同ドキュメントに書かれています。丸めた値だけでなく、ブロックごとの倍率と最小値を別に保持しているためです。
元の数値に戻すための目盛りを一緒に持ち歩いている、と考えると分かりやすくなります。その目盛りのぶんが上乗せされます。
llama.cppの実測表でも同じことが確認できます。同表では、Q4_K_Mは重み1つあたり4.8944ビット、Q8_0は8.5008ビットと記載されています。
さらに、名前の末尾がSやMやLで分かれているものがあります。同表の数値を見ると、Q4_K_Sが4.6672ビット、Q4_K_Mが4.8944ビットと、Sより Mのほうが大きい数値です。
ただし、この末尾の文字が何を意味するかを明文で定義した記述は、本記事で確認したページには確認できませんでした。表の数値からそう読める、というところまでが確かなことです。
ここから言えるのは一つです。ファイル名のビット数は目安であって、実際の容量を決める値ではありません。見積もるときは、名前ではなく公表されているファイルサイズを見ることになります。
GGUF・GPTQ・AWQは、それぞれ何が違うのか
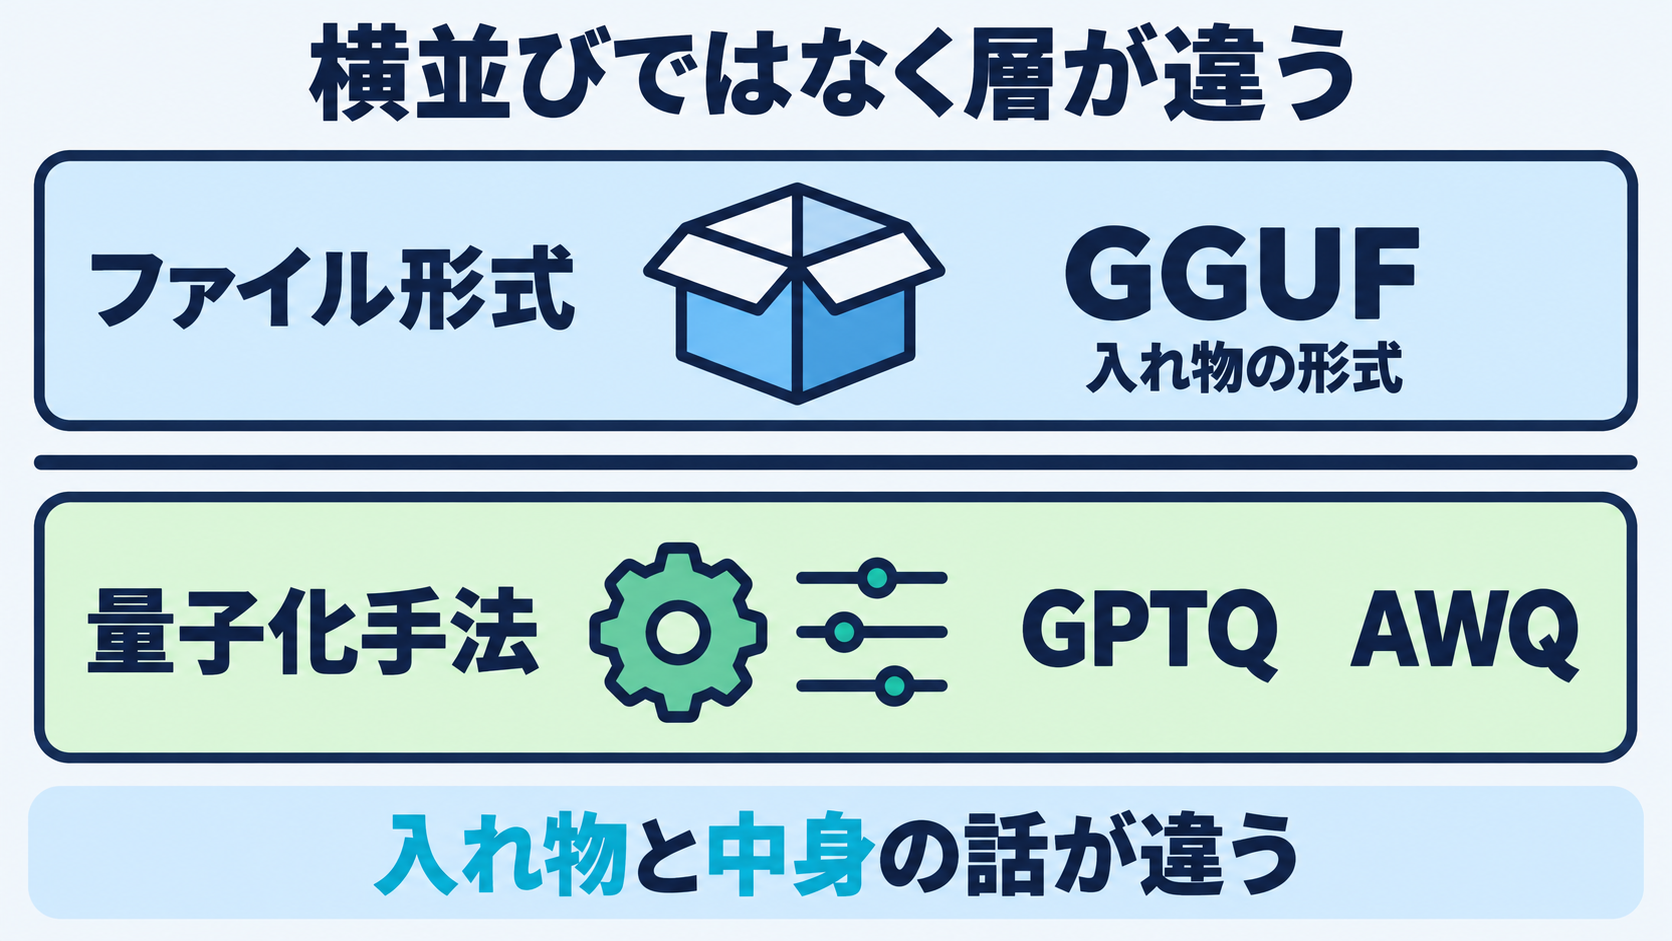
この3つは横並びで紹介されることがありますが、層が違います。
まずGGUFです。Hugging Face Hubの公式ドキュメントは、GGUFをモデルの読み込みと保存を速くすることに最適化されたバイナリ形式だと説明しています。llama.cppの開発者によって作られた形式です。
同ドキュメントは、テンソルだけを持つ形式とは異なり、GGUFはテンソルと標準化されたメタデータの両方を符号化すると説明しています。
つまりGGUFは手法ではなく、入れ物の形式です。中にどの量子化タイプが入っているかは、Q4_K_Mのような名前のほうが表しています。
次にGPTQです。原論文は、これを近似的な二次情報にもとづく、一度きりの重み量子化手法だと説明しています。
Hugging Faceの実装ガイドによれば、GPTQは重み行列の各行を独立に量子化し、誤差が最小になる重みを探す手法です。同ガイドは、int4で保存し、推論時にその場でfp16へ戻すと説明しています。
4ビットで保存はしていても、4ビットのまま計算しているわけではありません。
そしてAWQです。原論文は、LLMの中のすべての重みが等しく重要なわけではないという発見を中核に置いています。
同論文は、重要な上位1%の重みを守るだけで量子化の誤差を大きく減らせるとし、どれが重要かは重みそのものではなく活性の分布を見て判断すべきだと述べています。
同論文はさらに、AWQが逆伝播や再構成に依存しないため、キャリブレーション用のデータに過適合することなく、異なる領域や様式へ一般化すると主張しています。
この一文は裏返しても読めます。キャリブレーションを使う手法では、そのデータへの偏りが論点になりうるということです。
実際、Hugging Faceの実装ガイドはGPTQの設定にキャリブレーション用のデータセットを渡すよう求めており、論文と同じデータセットを使うことを強く推奨すると書いています。
なお、Hugging Faceの量子化手法の一覧表を見ると、対応するビット幅も対応ハードウェアも手法ごとに異なります。同表ではAWQが4ビット、GPTQの実装が2/3/4/8ビットと記載され、GGUFの行は1から8ビットを指す表記です。
「4ビットならどれでも同じ」ではない、というのが、この表から読み取れることです。
精度は、どれくらい落ちるのか
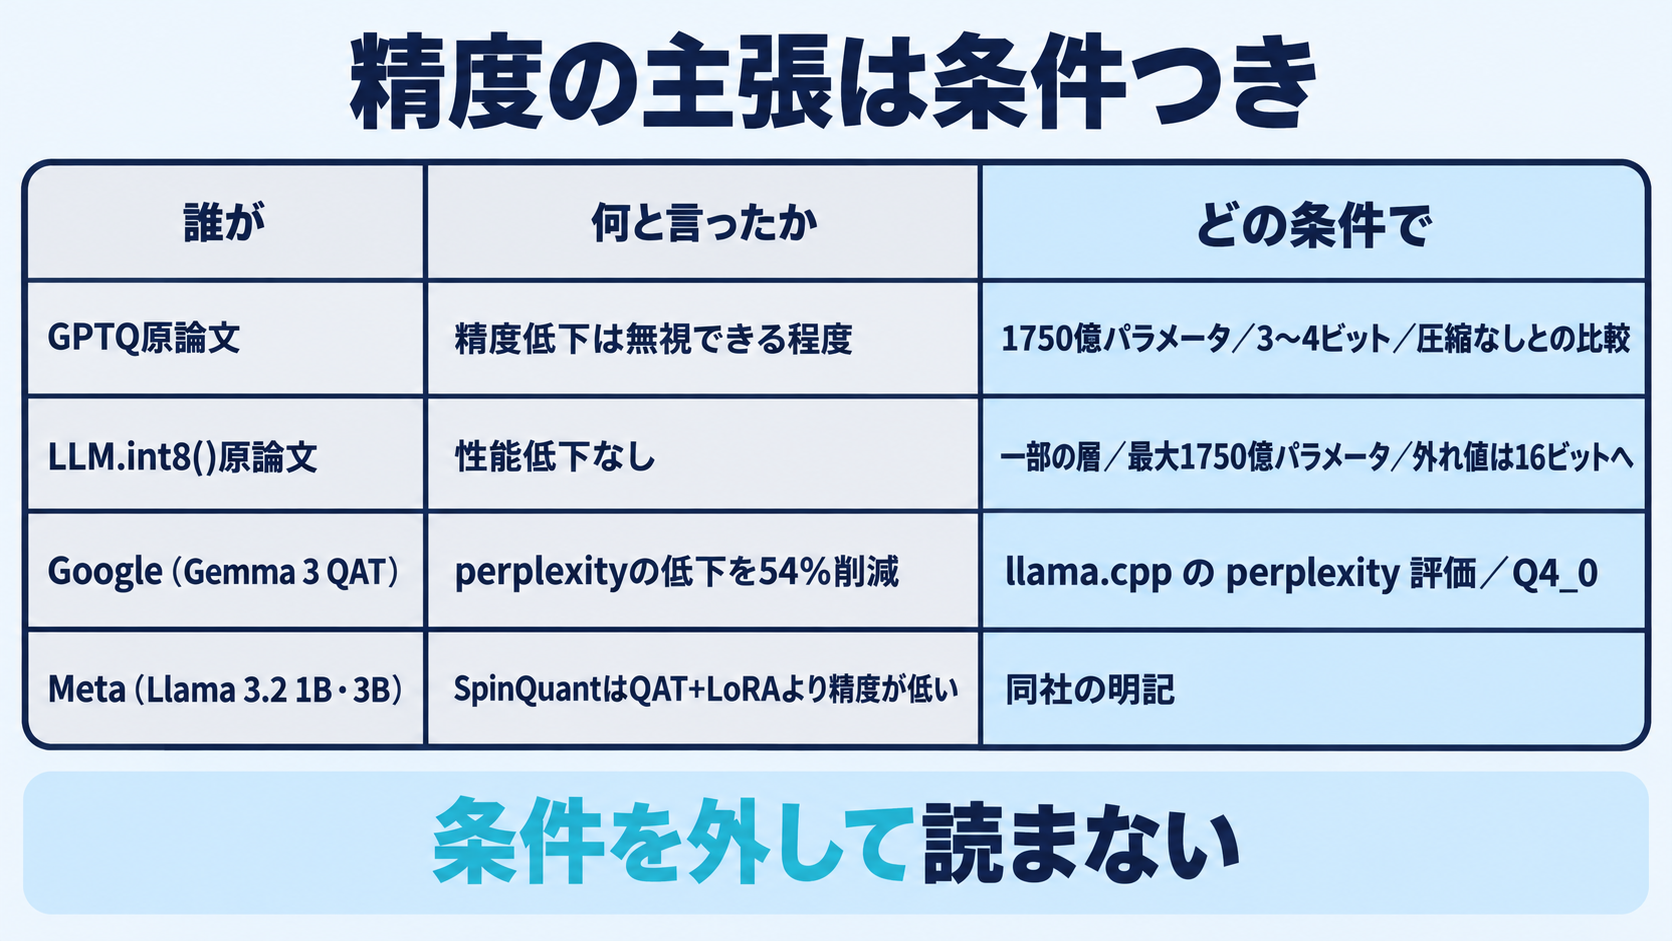
いちばん知りたいところですが、ここで一つの答えを出すことはできません。
理由は単純で、一次情報がどれも条件つきでしか書いていないからです。以下、条件を落とさずに並べます。
GPTQの原論文は、1750億パラメータのGPTモデルを重み1つあたり3ビットから4ビットに落とした場合に、圧縮していない元のモデルと比べて精度低下は無視できる程度であると述べています。
同論文は続けて、2ビットや三値まで落とす極端な領域についても触れていますが、そこでの表現は妥当な精度を提供できるにとどまります。同じ強さの主張はしていません。
LLM.int8()の原論文は、8ビットについて性能低下なしという強い主張をしています。ただし条件が細かく書かれています。
対象はトランスフォーマーの一部の層であり、最大1750億パラメータまでで実験的に示したもので、さらに外れ値の次元だけは16ビットの計算に逃がしています。同論文は、8ビットで掛けているのは99.9%を超える値だと明記しています。
Googleは、Gemma 3の量子化学習版について、llama.cppのperplexity評価を用いてQ4_0まで量子化した場合に、perplexityの低下を54%削減したと公表しています。
この書き方が要点を示しています。低下が無くなったとは書かれていません。低下があることを前提に、その幅を減らしたという報告です。
Metaは、Llama 3.2の1Bと3Bの量子化版について、2つの手法を用意したと説明しています。精度を優先するQAT+LoRAと、可搬性を優先するSpinQuantです。
同社はSpinQuantのほうがQAT+LoRAより精度が低いと明記しています。提供元自身が、同じモデルの2つの量子化版に精度差があると書いているわけです。
同社が公表している高速化やサイズ削減の数値もありますが、計測はQualcommとMediaTekのSoCを積んだAndroid端末上で行われ、8Kまでの短い文脈を優先した想定だと書かれています。手元のサーバでの値ではありません。
ここまでを踏まえると、精度がどれだけ落ちるかは、手法・モデル・ビット幅・評価方法のすべてに依存します。
llama.cppの公式ドキュメント自身も、量子化がいくらかの精度低下をもたらしうるとし、その低下は通常perplexityやKLダイバージェンスで測られると説明しています。
なお、同ドキュメントが公表している実測表には、精度や品質の列は含まれていません。載っているのはビット数、容量、速度の3種類です。容量と速度の得は表になり、失うものは別に測る必要がある、という構図です。
長く考えてから答える推論モデルのように生成量が多い使い方では、劣化の影響が現れる場面も変わります。公表されている数値はその評価での話なので、自社の使い方での影響は自社で測ることになります。

量子化は、蒸留や枝刈りと何が違うのか
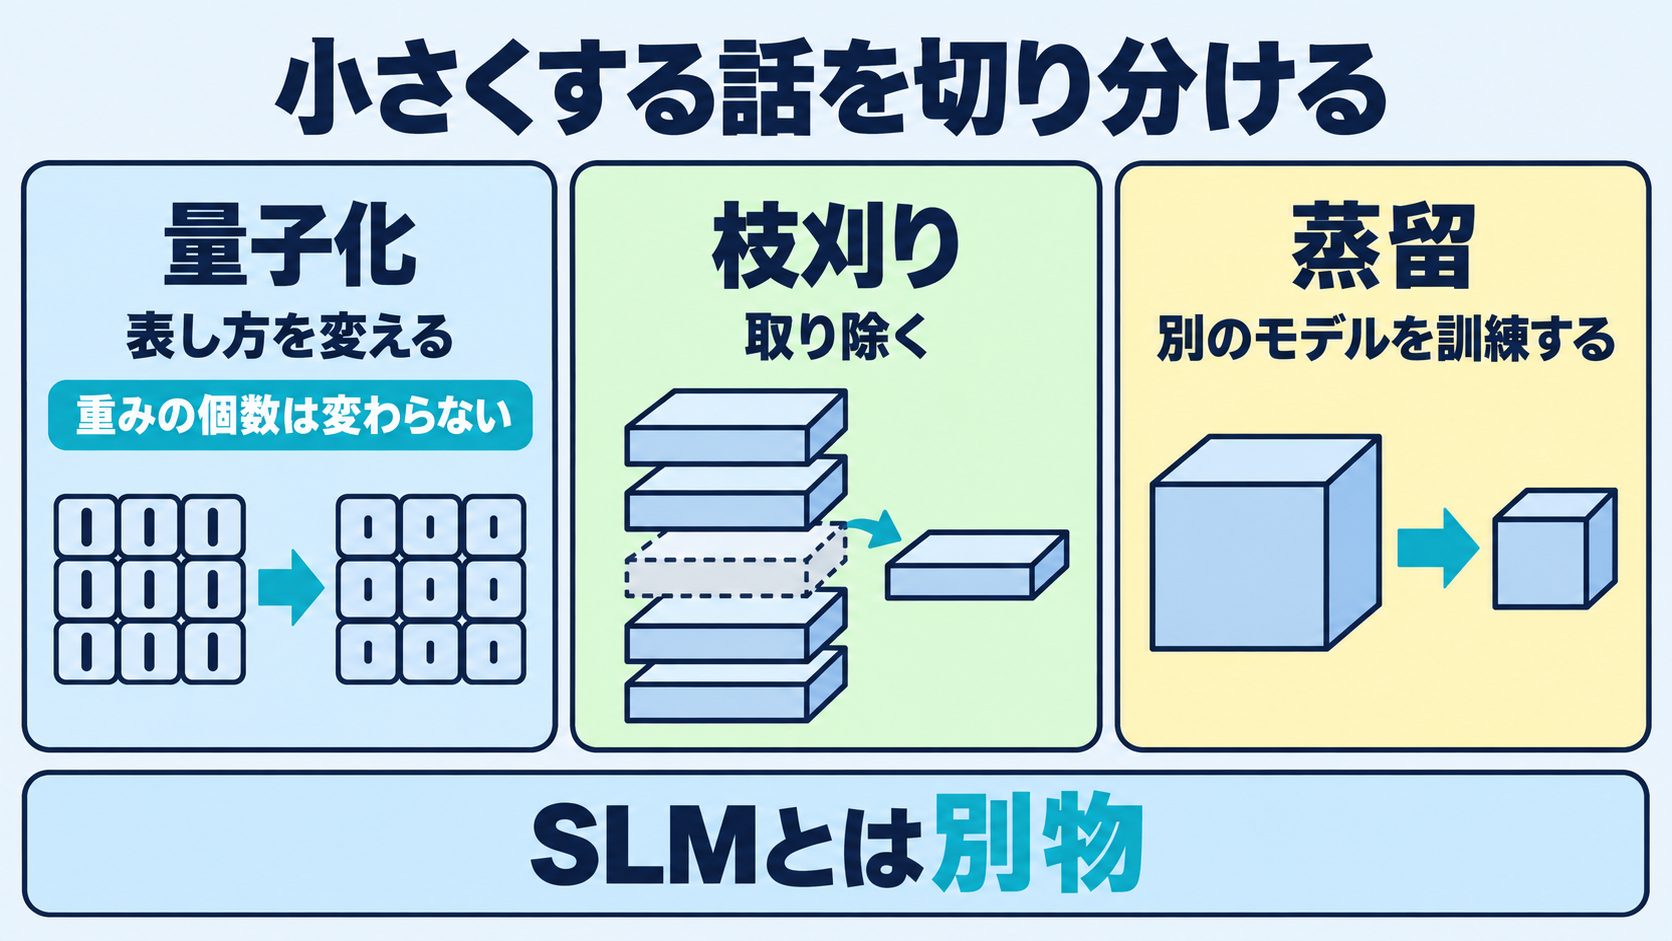
モデルを小さくする話としてまとめて語られがちですが、この3つは別の操作です。
量子化は、重みの持ち方を変えます。Hugging Faceの定義どおり、より低い精度で保存する操作です。重みの個数は変わりません。
枝刈りは、取り除きます。llama.cppのquantizeツールには、指定した層を取り除くオプションが量子化とは別に用意されています。同じツールの中で別の操作として扱われていることが、両者が違うものだと示しています。
蒸留は、別のモデルを訓練します。原論文は、複数のモデルをまとめたアンサンブルの知識を、配備しやすい単一のモデルへ圧縮する考え方をCaruanaらの成果とし、別の手法で発展させたと書いています。元のモデルを変形するのではなく、新しいモデルを作ります。
ここで、もう一つ混同されやすい組み合わせに触れておきます。
小規模言語モデル(SLM)と、量子化したモデルは別物です。SLMははじめから小さく作られたモデルであり、量子化は大きいモデルの表し方を変えたものです。
大きいモデルの4ビット版と、はじめから小さいモデルは、同じサイズでも中身が違います。
ファインチューニングとも層が違います。ファインチューニングは何を答えるかを変える手続きで、量子化はどう保存するかを変える操作です。

自社で試すとき、何から確かめるのか
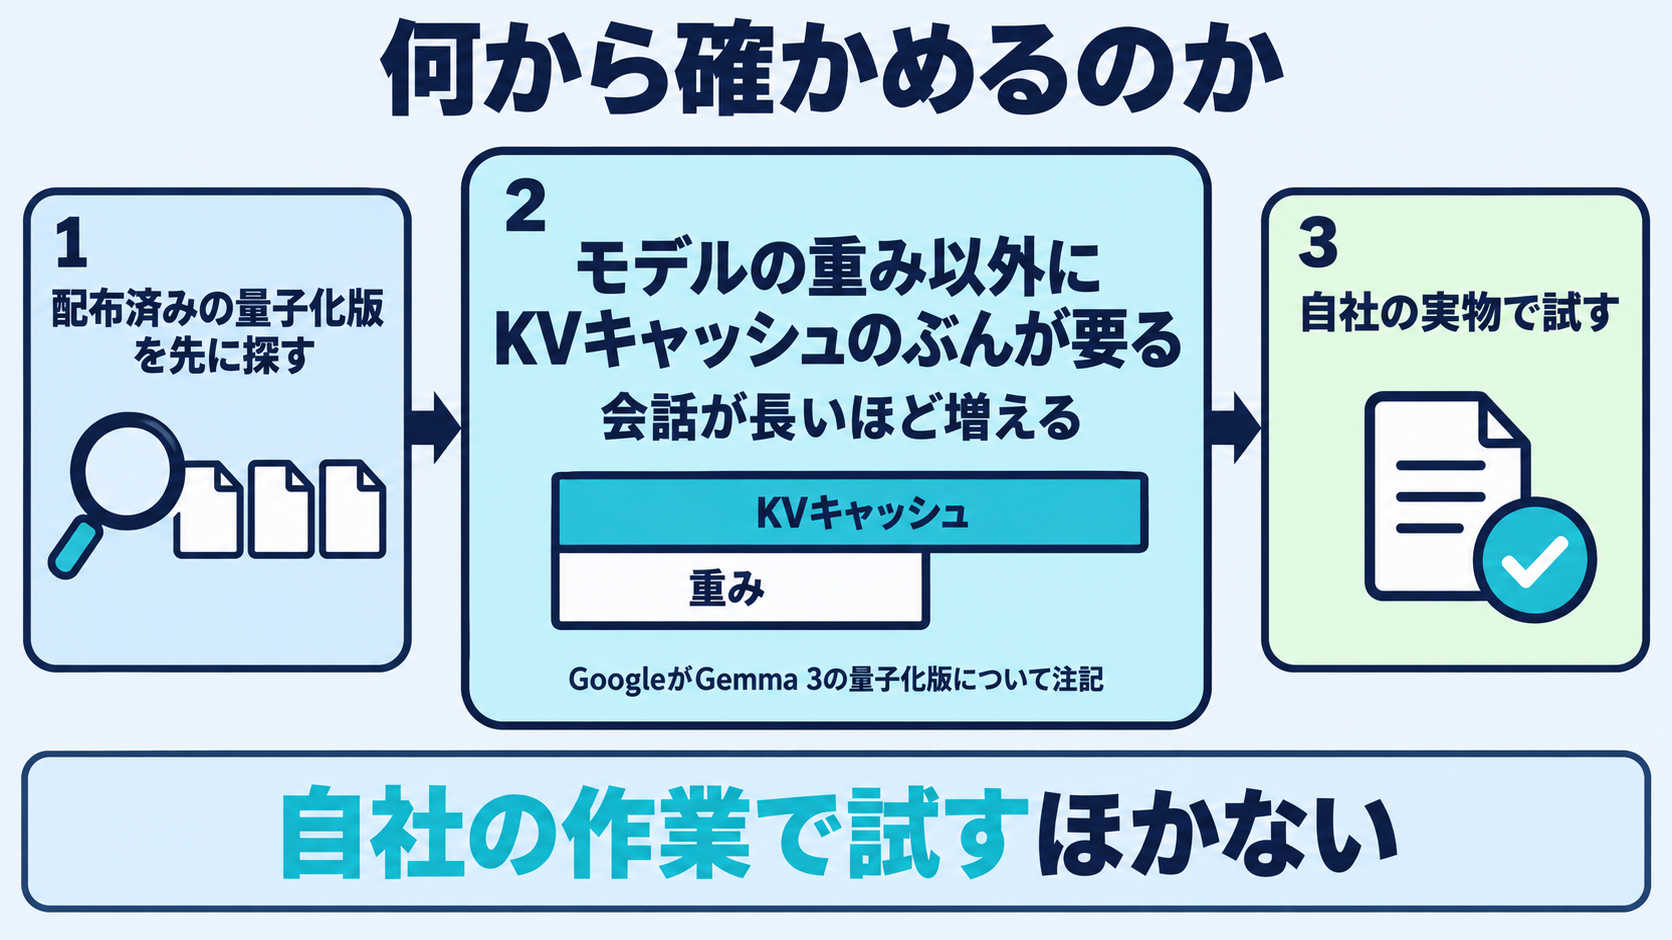
ここまで読むと、自分で量子化する作業が必要に見えるかもしれません。そうとは限りません。
一つ目は、誰がいつ量子化するのかという点です。
Hugging Faceの実装ガイドは、GPTQでの量子化に1750億パラメータのモデルではNVIDIA A100で約4時間かかるとした上で、量子化する前に、量子化済みの版がすでに公開されていないか確認するとよいと書いています。
公式ドキュメントが、まず配布されているものを探すよう勧めているわけです。冒頭で見たファイル名の羅列は、その配布物です。
二つ目は、モデルのサイズが収まれば動く、とは限らない点です。
GoogleはGemma 3の量子化版について、必要なVRAMを公表しています。ただし同社はその数値がモデルの重みを読み込むぶんだけを表しており、実行にはKVキャッシュのための追加のVRAMが必要で、その量は文脈の長さによって変わると注記しています。
会話や資料が長くなるほど、余分に要ります。ファイルサイズだけを見て機材を決めると、ここで足りなくなります。
三つ目は、自社の実際の作業で試すことです。
ここまで見たとおり、公表されている精度の主張はすべて条件つきでした。自社の書類や問い合わせ文で試した結果が、その環境での答えになります。
そもそもローカルで動かす動機が機密情報を外へ出さないことにある場合、どの資料を対象にするかは自社の取り扱い基準に沿って判断することになります。本記事はその可否を判断するものではありません。
よくある質問
量子化は量子コンピュータと関係がありますか
関係ありません。
ここで扱った量子化は、モデルの重みを表す数値の桁数を減らす操作です。名前が似ているだけで、量子コンピュータとは別の話になります。
結局どのファイルを選べばよいですか
本記事では特定のファイルを推奨しません。条件を揃えた比較を一次情報で確認できていないためです。
代わりに、見るべき順番であれば書けます。実際のファイルサイズを見て、自分の機材に載るかを確かめること。次に、KVキャッシュのぶんに余裕があるかを見ること。最後に、自社の作業で試して比べることです。
名前についたビット数だけで決めないという点が、本記事でいちばんお伝えしたいところです。
量子化すれば安く済みますか
費用の話は本記事では扱っていません。
確認できた範囲で言えるのは、必要な容量が下がることと、文章を生成する速度が上がる場合があることです。それが自社の費用にどう効くかは、使い方と機材によって変わります。
まとめ
LLMの量子化は、重みを低い精度で保存することで、読み込みと実行に必要なメモリを下げる操作です。量子コンピュータとは関係がありません。
得られるものははっきりしています。llama.cppの公式ドキュメントによれば、Llama 3.1の8Bは32.1 GBから4.9 GBになります。文章を生成する速度も、同ドキュメントの実測では上がっています。
ただしプロンプトを読み込む速度は、最も高い精度の形式のほうが速いと記載されています。得は一様ではありません。
名前のビット数は、実際のビット数ではありません。Hugging Faceの公式ドキュメントによれば、Q4_Kは重み1つあたり4.5ビットになります。
そして精度への影響を、本記事は一つの数値で示していません。GPTQの原論文もLLM.int8()の原論文もGoogleもMetaも、モデル名とビット幅と評価方法を添えた条件つきの記述として公表しているためです。
「ほとんど落ちない」と読める説明に出会ったときは、それがどの条件での話なのかを確かめてください。これが本記事のいちばんの結論です。
自社でのAI活用の進め方についてご相談がある場合はお問い合わせはこちらからご連絡ください。
この記事の出典
- Quantization | Transformers(Hugging Face Documentation、2026-09-17確認)
- GGUF | Hugging Face Hub(Hugging Face Documentation、2026-09-17確認)
- llama.cpp quantize ツール README(ggml-org / llama.cpp、2026-09-17確認)
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers(arXiv、2026-09-17確認)
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration(arXiv、2026-09-17確認)
- LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale(arXiv、2026-09-17確認)
- GPTQ | Transformers(Hugging Face Documentation、2026-09-17確認)
- Gemma 3 QAT Models: Bringing state-of-the-Art AI to consumer GPUs(Google Developers Blog、2026-09-17確認)
- Introducing quantized Llama models with increased speed and a reduced memory footprint(Meta AI Blog、2026-09-17確認)
- Distilling the Knowledge in a Neural Network(arXiv、2026-09-17確認)
この記事は役に立ちましたか?
感想は、今後の記事改善に活用します。
関連記事
プロンプトキャッシュとは?生成AIの入力を使い回して料金を下げる仕組み|効く条件と効かない場面
プロンプトキャッシュは、生成AIに毎回送る同じ前置きの計算結果を再利用して、入力の料金を下げる仕組みです。Windowsのコマンドプロンプトのキャッシュ削除とは別の言葉です。割引率も最小トークン数も保持時間も提供元とモデルで違うので、OpenAI・Anthropic・Google・AWSの公式ドキュメントから条件ごと整理しました。
ナレッジカットオフとは?AIが古い情報のまま答える理由|カットオフは1つとは限りません
ナレッジカットオフは、AIが学習に使ったデータの新しさの境目を指す言葉です。経理や検査のカットオフとは別の言葉です。同じモデルについて2つの日付を公表している例や、分野によって知識の新しさが違うと注記している例を、AnthropicとGoogleの公式ドキュメントとモデルカードから帰属つきで整理しました。
A2Aプロトコル(Agent2Agent)とは?MCPとの違いは「つなぐ相手がツールかエージェントか」|v1.0はいつ出たか
A2Aプロトコル(Agent2Agent)は、別々のベンダーが作ったAIエージェント同士をつなぐためのオープン標準です。決済分野でいうA2A(口座間の直接送金)とは別の言葉です。MCPとの関係、仕様がv1.0になった時期、試す前の確認点を、A2AとMCPの公式ドキュメントおよび公式ブログから整理しました。
知識蒸留とは?大きいモデルの答えで小さいモデルを訓練する仕組み|量子化との違いと「禁止」と検索される理由
知識蒸留は、大きいモデルに答えを出させ、その答えで小さいモデルを訓練する手法です。お酒や化学の蒸留とは別の話です。量子化や枝刈りとの違いと、OpenAI・Google・Anthropic・Metaの契約・規約・ライセンスに実際に書かれている文言を、それぞれが誰に向けた文書かも添えて、原論文と各社の公式ドキュメントから整理しました。
次のAIツール選びへ
気になるツールを並べて、料金や特徴の違いを確認できます。