AIで作れるのに成果が似てしまう理由|Taste(審美眼)を評価軸に分解して鍛える方法
AIに企画案を10本出してもらったところ、10本ともそれなりに整っていました。そんな場面が増えています。
事実の誤りはなく、構成も破綻していません。それでも、どれを選ぶかの段になると手が止まります。
選んだ1本が、競合が出しているものとよく似ていることに、後から気づくこともあります。
この記事では、AIで量産できるようになった時代に成果が似通う理由と、実務で評価軸を組み立てる手順を、研究の記述をもとに整理します。
「センスを磨こう」という気分の話ではなく、次の1案件で使える評価軸の作り方までお持ち帰りいただけます!
この記事の監修者
AIリスキル株式会社 代表取締役
AIツールギャラリーを運営するAIリスキル株式会社の代表取締役。企業・自治体向けの生成AI研修とAI導入支援を手がけています。
実績: 大阪・関西万博 公式プログラム「AI HEROES COLLECTION」司会進行 / 神戸市デジタル人材育成エコシステム構築事業の運営 / MBS「せやねん!」「よんチャンTV」に生成AIの専門家として出演 / Felo日本初コアアンバサダー / Genspark第1期公式アンバサダー / Skywork公式アンバサダー / AKOOL公式パートナー など
その結果として「最近どれも似てきた気がする」という感覚が生まれますが、これは担当者の気のせいとは言い切れません。
人とAIの共同制作で成果が均質化するかを扱ったメタ分析が、2026年に Behaviour & Information Technology 誌へ掲載されています。
de Rooij 氏と Biskjaer 氏によるこの分析は、複数の研究を統合したうえで、均質化の効果を小さいながら統計的に有意なものとして報告しています。
注意点を先に書きます。掲載誌本体のページは今回アクセスできず、著者所属大学の公式研究ポータルと、著者自身が公開しているプレプリントの要旨で内容を確認しました。
そのため本記事では効果量の具体的な数値を出さず、効果の向きと有意性だけを扱います。
この分析で目を引くのは、個人と集団で向きが食い違う点です。
同分析の整理では、生成AIを使うことで個人の創造的な成果は向上しうる一方、利用者どうしのあいだでは成果の多様性が下がります。
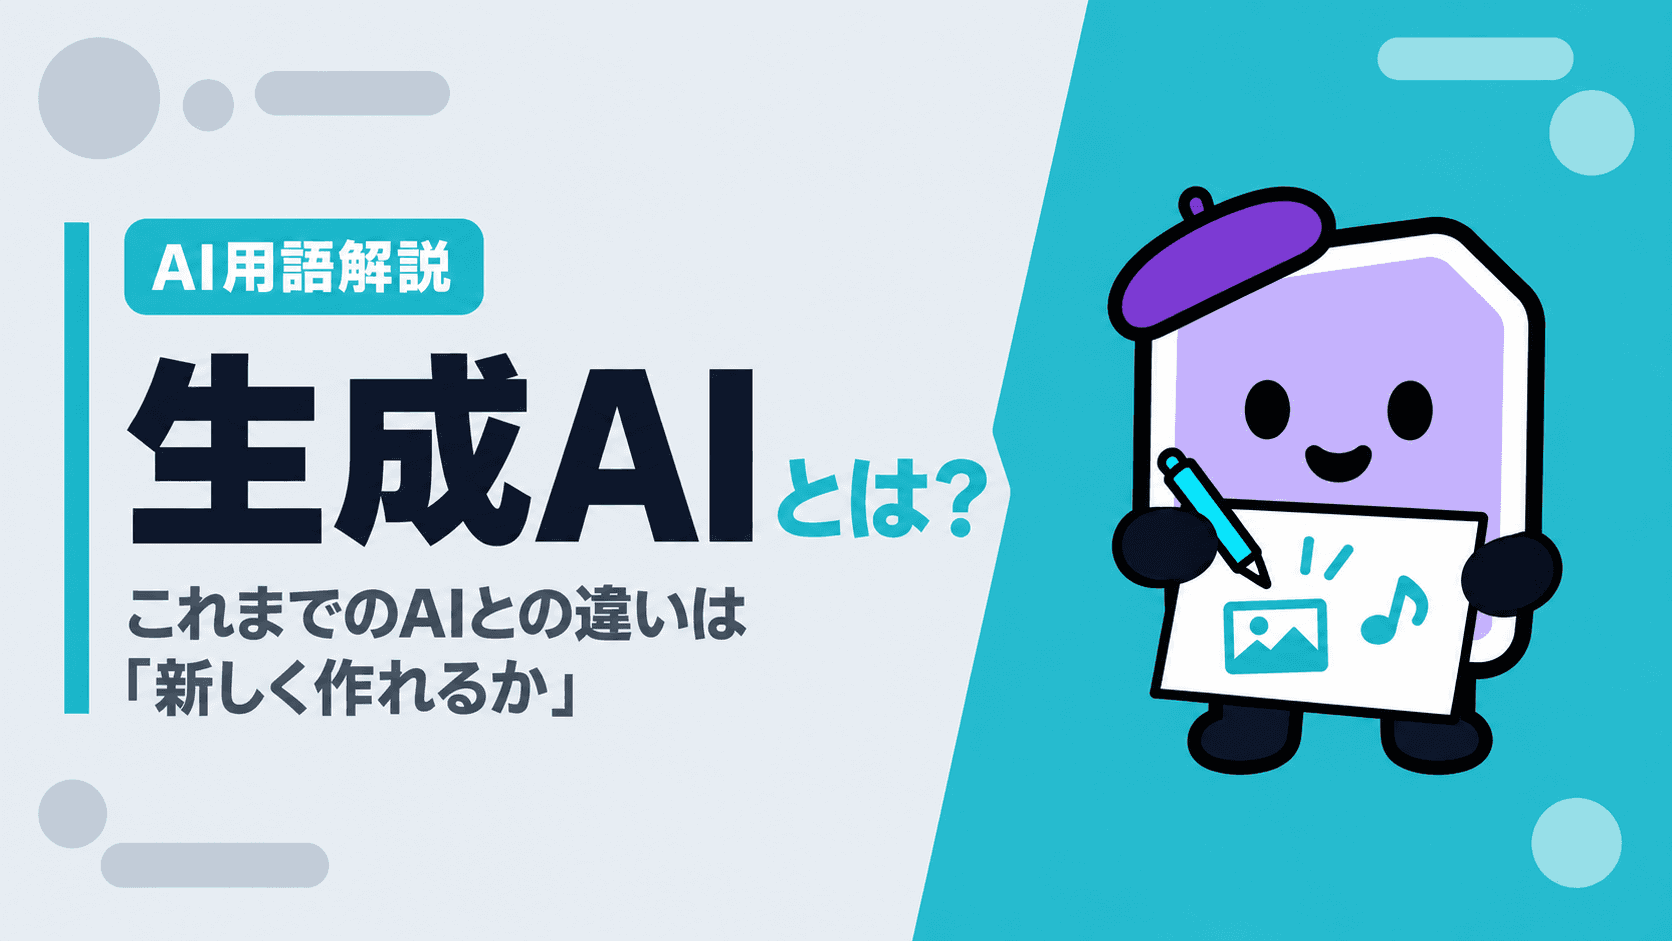
一人ひとりは上手くなっているのに、世の中に出てくるものは似ていきます。この2つが同時に起きているということです。
さらに、効果の強さは課題の種類によって変わります。
同分析の調整変数の検討では、意味的に制約されたアイデア出しの課題で効果が強く、制約の少ない発散的思考の課題では弱くなります。
業務の企画や制作は、題材も目的も先に決まっていることがほとんどです。つまり制約が強い側、均質化が当たりやすい側に入ります。
差がつく場所が「作る」から「選ぶ・直す」へ移っている、と言い換えることもできます。
Taste は精神論ではなく、評価軸の構造である
実務で使う Taste という言葉に、一つに定まった定義があるわけではありません。
本記事では、目的設定・選択・編集・評価基準・文脈判断のまとまりとして扱います。定義を確定させるためではなく、実務で動かせる形に分解するための置き方です。
手がかりになるのが、2026年6月に公開された The Human Creativity Benchmark という評価基準の研究です。
この研究は13カ国28名の職業クリエイターから約15,000件の専門家判断を集め、5つの領域と3つの工程にまたがって作品を評価しています。
同研究がまず指摘するのは、作品の側ではなく評価の枠組みの側の問題です。
原文では、現代のAI評価の枠組みは評価者の不一致を解消すべきノイズとして扱うが、創造的な領域における専門家の不一致は Taste の本物の差であって測定誤差ではない、と述べられています。
ここが視点の転換点になります。意見が割れることは、評価に失敗した証拠ではなく、Taste が働いている証拠だという読み方です。
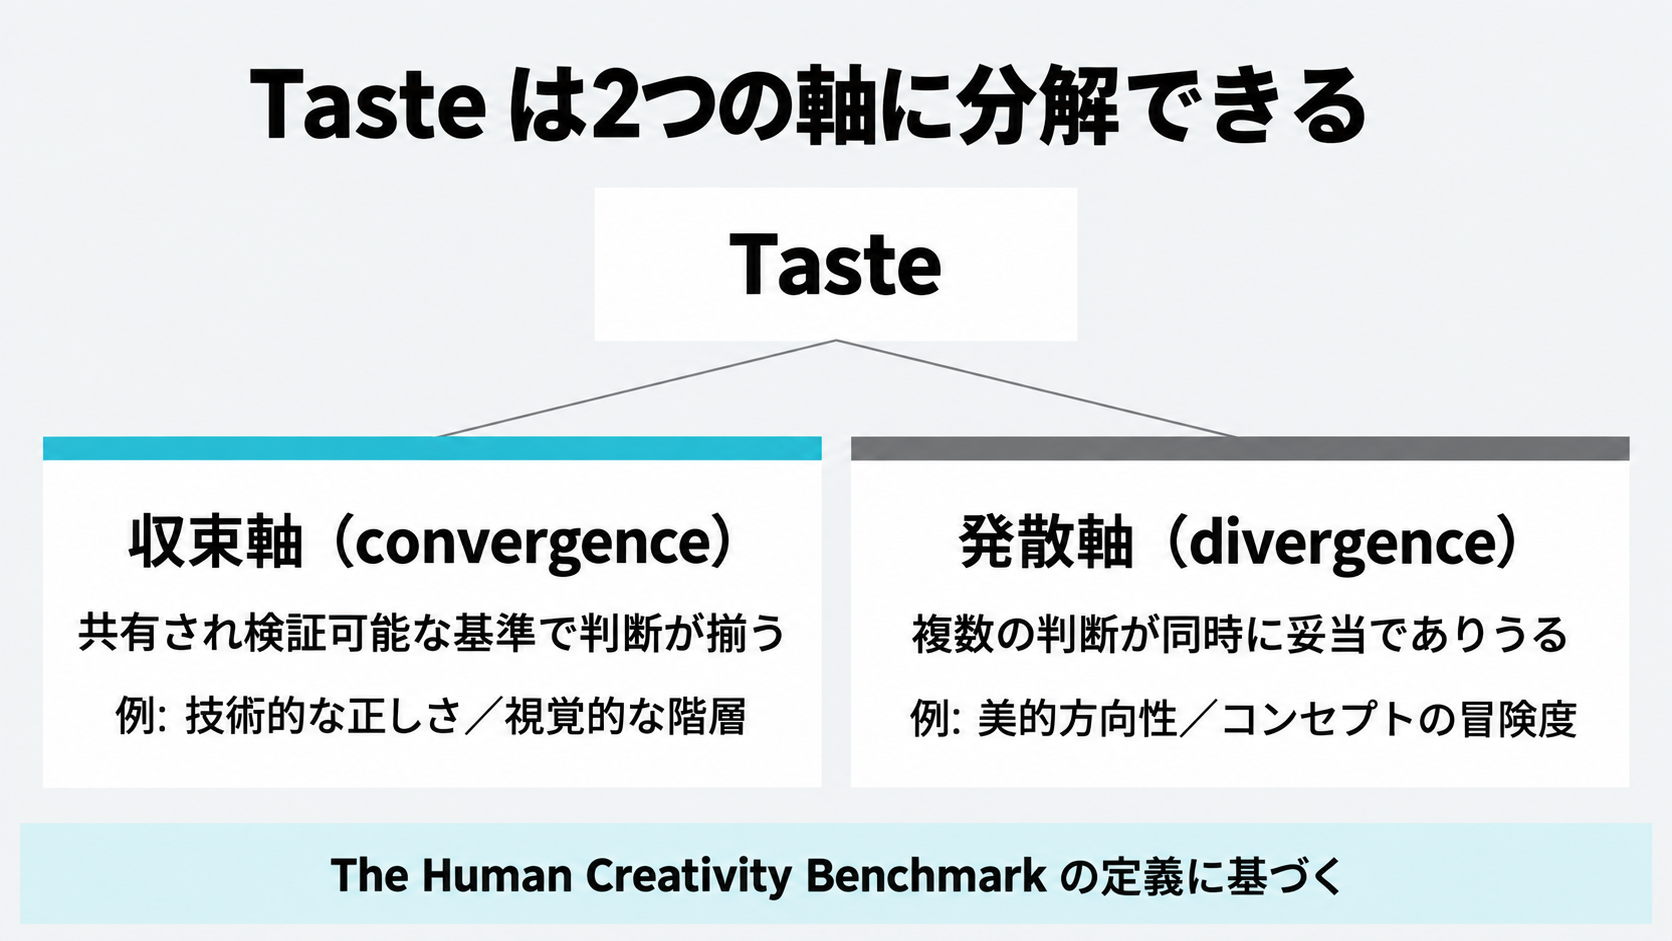
そのうえで同研究は、評価の次元を2つに分けています。
収束(convergence)は、共有され検証可能な基準のもとで評価者の判断が揃う次元です。
発散(divergence)は、複数の創造的判断が同時に妥当でありうる次元です。
同研究が収束する側の例として挙げているのは、技術的な正しさと視覚的な階層です。
発散する側の例として挙げているのは、美的方向性とコンセプトの冒険度です。
この線引きが入ると、「センスは暗黙知だから言語化できない」という前提が崩れます。
言語化しにくいのは発散軸の一部であって、収束軸はチェックリストに書き出せます。Taste の全部が暗黙知なのではありません。
AIに Taste はあるか
事実として正しいかどうかを確かめる力は、AIリテラシーの領域です。

出典が実在するか、数字が合っているか、ハルシネーションが混ざっていないかを確認する話は、そちらに譲ります。
この記事が扱うのは、その先です。事実としてはどれも正しい複数の案が並んだとき、どれを選ぶのかという場面を扱います。
リテラシーが「使ってよいか、信じてよいか」を判断する力だとすれば、Taste は「どれを選ぶか、どう直すか」を判断する力にあたります。
人の手元に残るという側
Anthropic が2026年に公開した Agentic Coding Trends Report が参考になります。
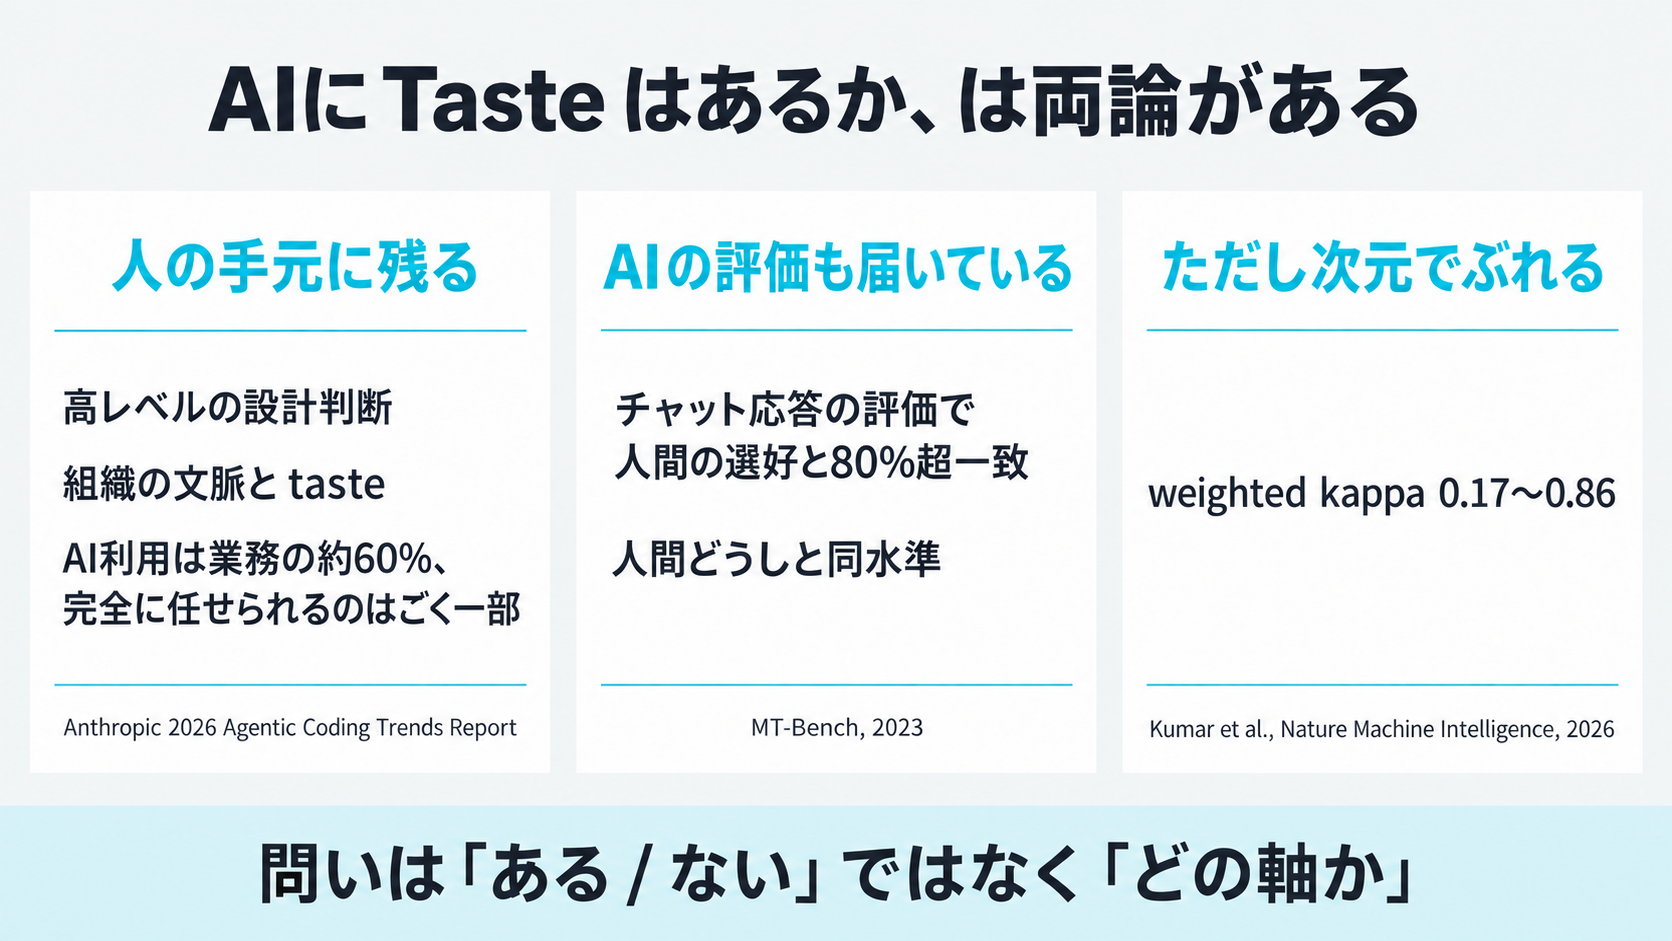
同報告書は、エンジニアが検証しやすい・定義が明確・反復的なタスクにAIを使う一方で、高レベルの設計判断と、組織の文脈や taste を要するものは自分の手元に残している、と記述しています。
数字の並び方が示唆的です。同報告書によれば、エンジニアは業務のおよそ60%でAIを使い、相当の生産性向上も報告しています。
それでも、完全に任せられる(fully delegate)タスクはごく一部にとどまる、と同報告書は記述しています。
概念的に難しい、あるいは設計に依存するタスクほど、自分で抱えるか、AIと協働して進める傾向があるとも書かれています。
AIの評価能力が伸びているという側
反対側にも実測値があります。
2023年の MT-Bench の研究では、強いLLMを評価者として使った場合、人間の選好との一致が80%を超え、これは人間どうしの一致率と同水準だと報告されています。
ただし評価の対象は、オープンな質問に対するチャットアシスタントの応答です。美的判断を評価した結果ではありません。
同研究自身も限界を明記しています。位置による偏り、冗長な回答を好む偏り、自分の出力を高く評価する傾向、そして推論能力の限界です。
このうち位置や冗長さによる偏りは、AIバイアスとして整理されている現象と地続きです。
一致率は次元によって大きくぶれる
共感的コミュニケーションの評価を扱った研究が、2026年に Nature Machine Intelligence で公表されています。
Kumar ほかによるこの研究では、専門家とLLMの一致が21の下位要素にわたり weighted kappa で0.17から0.86まで開いています。
同じ研究では専門家どうしの一致も0.11から0.84まで開いており、LLMのばらつきは専門家のばらつきとよく似た形だと述べられています。
この0.17から0.86を引用した別の2026年の研究は、LLM評価者が人間評価を完全に置き換えることを否定し、慎重に設計された人間評価の一部を補助する位置づけだとしています。
さらに、規範的な判断を含む領域、たとえば安全性評価やメンタルヘルス評価では、専門家の評価が依然として標準だと述べています。
作る側も万能ではありません。先の Human Creativity Benchmark は、すべての工程にわたって一様に優れたモデルは存在しない、と結論しています。
問いを「ある / ない」から「どの軸か」へ
ここまでを並べると、問いの立て方のほうが変わります。
収束軸では、AIはすでに十分に使えるところまで来ています。発散軸と組織の文脈は、現時点の報告を読む限り、人が決めるしかない領域です。
「AIに Taste があるか」を是非で争うより、「どの軸をAIに渡し、どの軸を自分で決めるか」に置き換えるほうが、実務では動かせます。
実務でTasteを鍛える6つの方法
先に線を引いておきます。
収束と発散への仕分け、複数案の対比較、工程が進むと評価者の重視する観点が入れ替わるという知見は、Human Creativity Benchmark に根拠があります。
一方で、以下の運用手順そのものは当サイトによる実務への翻訳です。研究がこの手順を検証したわけではありません。
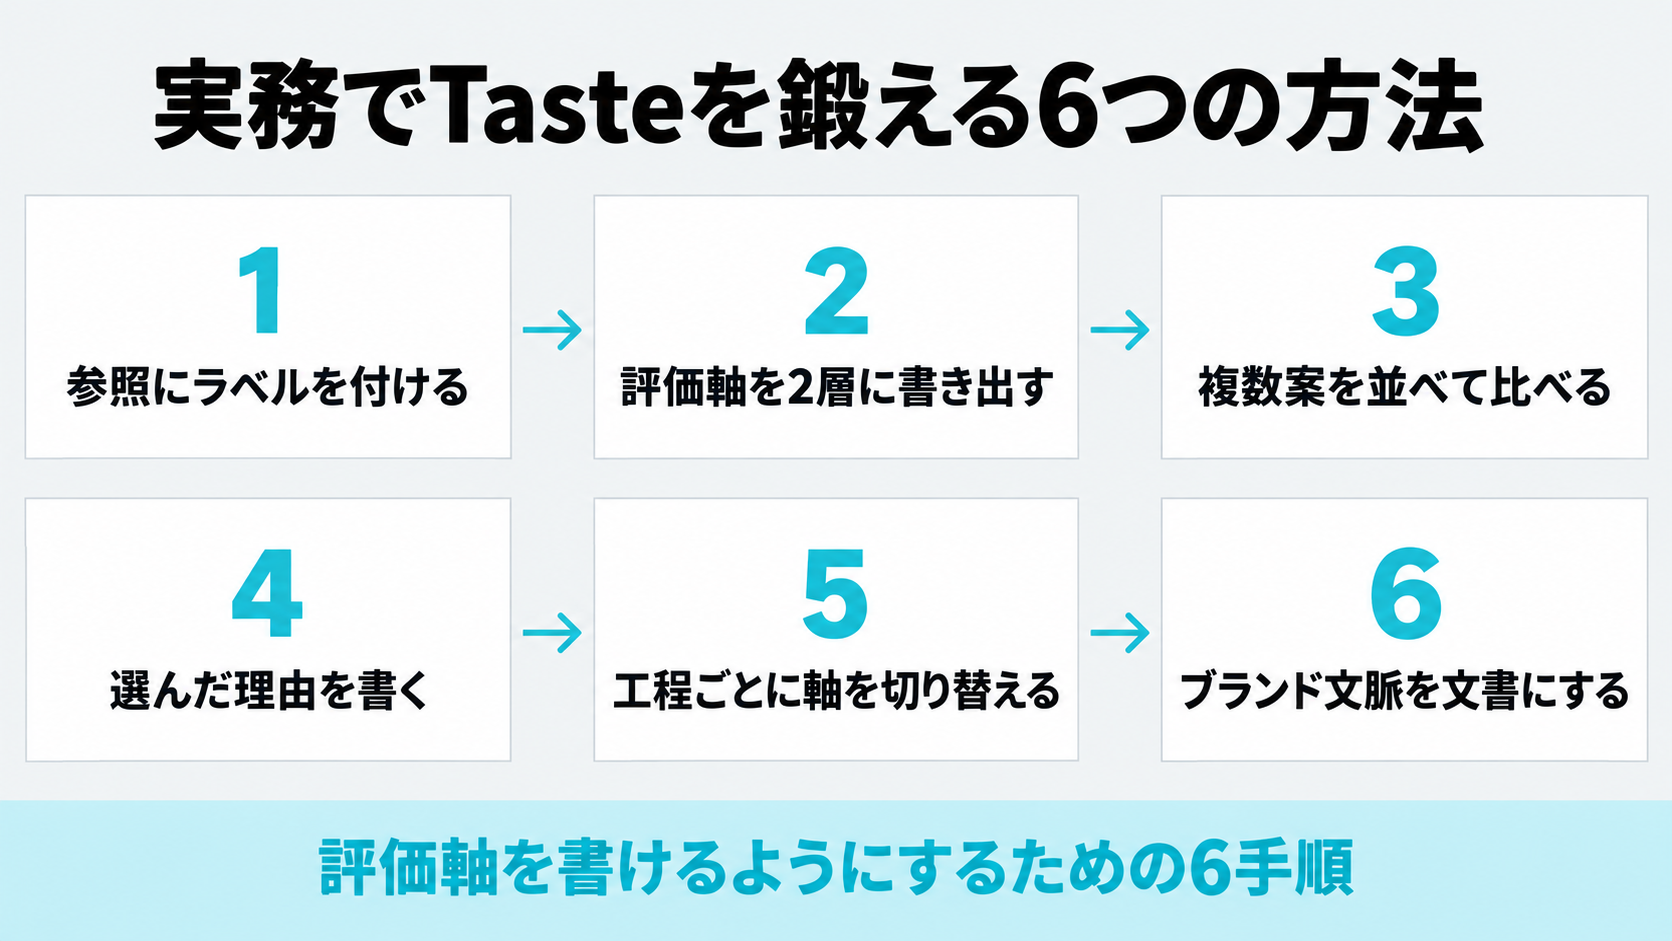
1. 参照を集めるときに、収束か発散かのラベルを付ける
良い事例を保存するときに、一言のラベルを添えます。
保存先に「誰が見ても正しい部分」と「好みが割れて当然の部分」の2欄を作り、その事例のどこがどちらに当たるかを1行ずつ書きます。
余白の取り方で情報の階層が読み取れる、は収束側です。ここまで硬い言葉遣いを選ぶ、は発散側です。
つまずき方は、事例を集めるだけで満足してしまう形です。ラベルのない参照フォルダは、量が増えても判断の材料にはなりません。
2. 評価軸を2層に分けて書き出す
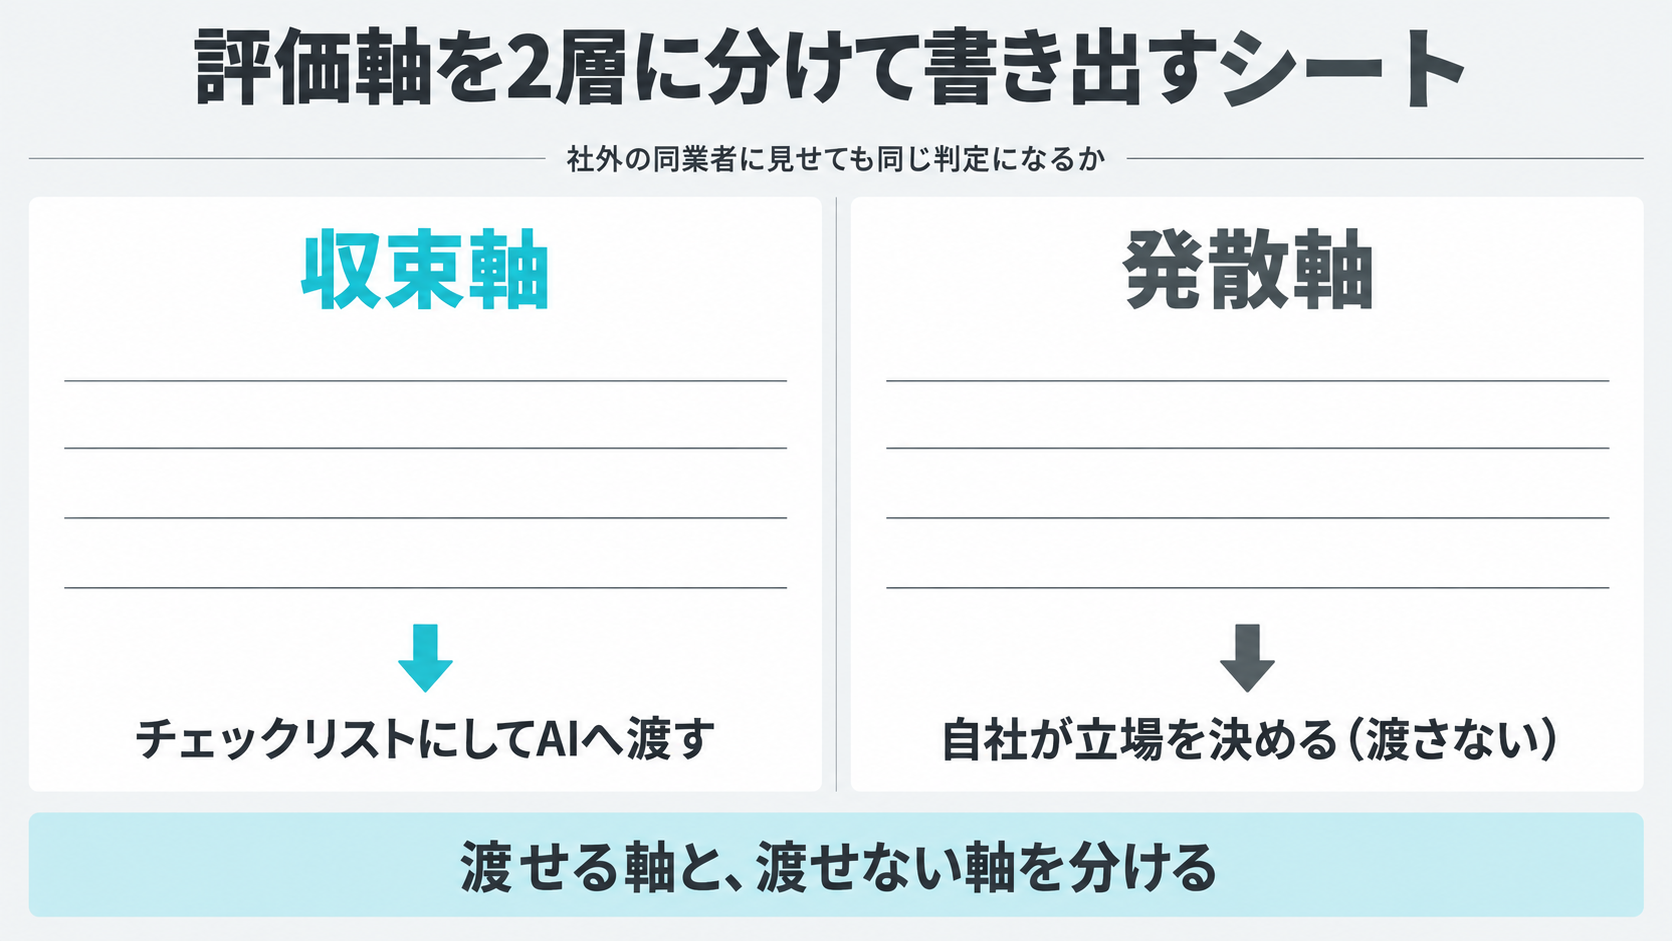
この記事で最も持ち帰っていただきたい作業です。
いま動いている案件で、良し悪しを決めている軸を思いつく限り並べ、収束と発散に振り分けます。
振り分けの問いは1つで足ります。「社外の同業者に見せても同じ判定になるか」です。なるものは収束、割れるものは発散に置きます。
収束軸は、そのままチェックリストにしてAIへ渡せます。プロンプトに条件として書き込む対象がここです。

発散軸は渡せません。自社としてどちらを取るかを決める対象になります。
つまずき方は、すべてを収束軸に寄せてしまう形です。判定がぶれない軸だけを残すと、安全ではあるものの、似た成果しか出なくなります。
3. 単体で判断せず、必ず複数案を並べる
1案だけを見て良し悪しを言う場面を減らし、2案以上を横に並べて比べます。
AIに出させる段階から複数出させ、並べたうえで「どちらがなぜ良いか」を言葉にします。
Human Creativity Benchmark が専門家の判断を集めるときも、作品を比較する形をとっています。並べると、単体では出てこなかった基準が言葉になります。
つまずき方は、案の数だけ増やして比較をしない形です。10案を眺めて終わるなら、1案を見たのと変わりません。
4. 選んだ理由を発散軸の言葉で書く
採用した案について、選んだ理由を2行から3行で残します。
書いたら、その文が収束軸の言葉だけで成り立っていないかを点検します。
読みやすい、誤字がない、階層が整っている。これだけで説明がついてしまうなら、それは品質管理であって Taste の判断ではありません。
「この案件では、正確さより先に驚きを取る」のような、立場を含む言葉が1つは入るのが目安です。
つまずき方は、「なんとなくこちらが良い」で止める形です。理由を残さない限り、次の案件に持ち越せる軸にはなりません。
5. 工程ごとに評価軸を切り替える
アイデア段階・試作段階・仕上げ段階で、見る軸を変えます。
Human Creativity Benchmark は、Ideation・Mockup・Refinement と工程が進むほど、評価者が実際に重視する観点が入れ替わることを報告しています。
広告画像の領域では、仕上げ段階でタイポグラフィへの言及が3%から約34%へ上がったとされています。
レビューの場を開くときに、いまどの工程を見ているのかを先に宣言し、その工程では見ない軸を明示します。
アイデア段階で仕上がりの粗を叩くと、発散軸が先に死にます。冒険的な案が最初の会議で落ちるのは、たいていこの形です。
どの工程に人の判断を挟むかという設計は、Human-in-the-loopの考え方と重なります。
つまずき方は、すべての工程で同じチェックリストを使う形です。
6. ブランド文脈を、渡せないものとして扱う
自社が何を良しとし、何を避けるかを、チームで文書にします。
Anthropic の報告書が「組織の文脈」を人の手元に残る要素として挙げているのは、この部分にあたります。社内の経緯や約束事は、定義上AIの側にはありません。
発散軸のうち、自社として既定値を決められるものを選び、「取る側」と「取らない側」を並べて書きます。
断定的な言い切りは取らない、専門用語はカタカナのまま置かない。このくらいの粒度まで下ろします。
つまずき方は、抽象的なブランドらしさの宣言で止める形です。「誠実に」では判定に使えません。
判定に使える粒度まで下ろすと、その文書がそのまま組織の Taste になります。
明日から変える1つのこと
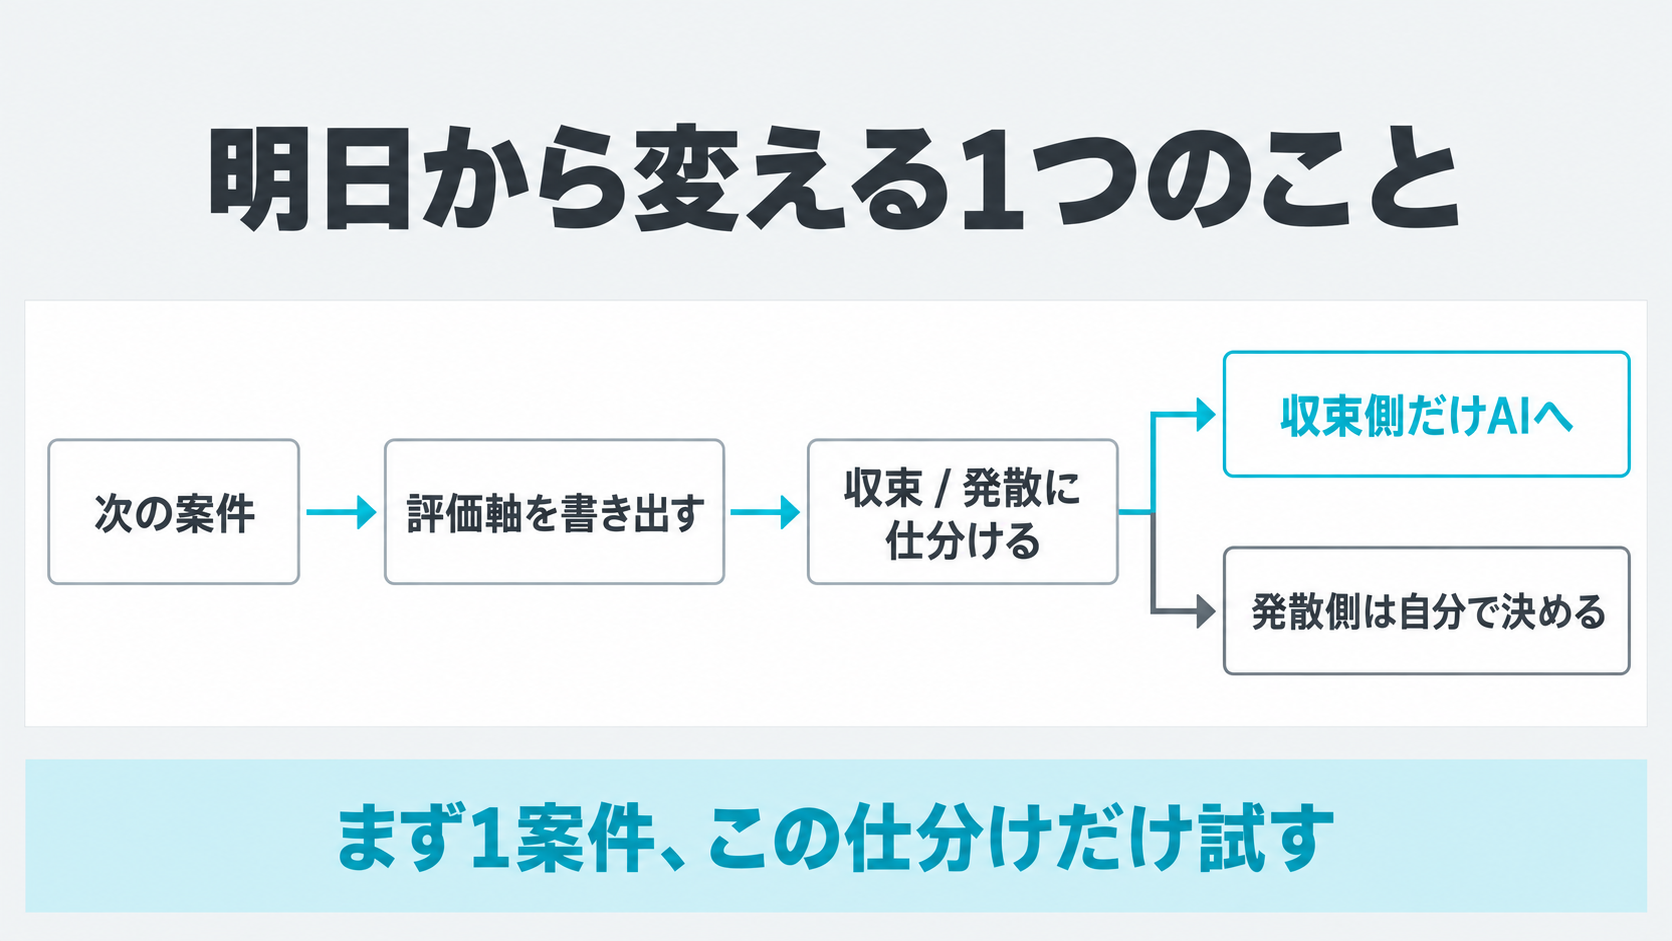
先に断っておきます。この章の手順は研究が推奨しているものではなく、本記事の提案です。
次に動く案件で、1つだけ試していただきたいことがあります。
評価軸を収束と発散に仕分けて書き出し、収束側だけをAIに渡すことです。
これだけで、AIに任せる範囲と、自分が決めなければならない範囲の線が引けます。
線が引けると、議論の形も変わります。
「AIの出力が良くない」ではなく、「この発散軸を自社はまだ決めていない」と言えるようになります。
自社の制作フローのどこに人の判断を残すかを含めて検討したい場合は、お問い合わせからご相談ください。
この記事の出典
- 2026 Agentic Coding Trends Report(Anthropic、2026-09-18確認)
- The Human Creativity Benchmark(Hopkins ほか、arXiv:2606.30561、2026-06-29投稿、2026-09-18確認)
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena(Zheng ほか、arXiv:2306.05685、2026-09-18確認)
- When large language models are reliable for judging empathic communication(Kumar ほか、Nature Machine Intelligence、2026年、2026-09-18確認)
- Augmenting Human Evaluation with LLM Judges(arXiv:2605.16354、2026-05-08公開、2026-09-18確認)。本記事が引いた weighted kappa の0.17から0.86は、同論文が引用している Kumar ほかの報告であり、同論文自身の結果ではありません。
- Does generative AI make us think alike? A systematic review and meta-analysis of homogenisation effects in human-AI co-creation(de Rooij & Biskjaer、Behaviour & Information Technology、2026年)。掲載誌本体のページは2026-09-18時点でアクセスできず、著者所属大学の公式研究ポータルと、著者自身が PsyArXiv に公開しているプレプリントの要旨で内容を確認しました。課題の種類による効果の強弱も、このプレプリントの要旨に記載があります。効果量の数値は本記事では扱っていません。
この記事は役に立ちましたか?
感想は、今後の記事改善に活用します。
関連記事
企業のAI活用は採用でどう伝える?学生に届く「AI活用企業」の見せ方
「生成AIを積極活用しています」だけでは、学生の判断材料になりません。採用サイトに載せたい6つの情報と、学生が生成AIで企業を探し始めた流れを踏まえ、人にもAIにも伝わる採用情報の作り方を調査データから整理します。
AI面接を希望する学生は10.7%|AIを使う就活生が「人に評価してほしい」と答える理由
就職活動でAIを使う学生は84.9%に達する一方、AI面接を希望する学生は10.7%にとどまります。緊張しにくいという利点は認めながら対人面接が選ばれる理由と、学生が安心できる運用条件を最新調査から整理します。
大学生は「AI活用企業」を選ぶ?就活生の好感・不信を最新調査で検証
企業のDX推進が志望度に影響すると答えた27卒は77.1%。一方で、企業の生成AI活用に好感を持つ若手社員は36.4%にとどまり、不信感も22.4%あります。AI活用が採用ブランドになる条件を、調査の母集団の違いまで含めて検証します。
就活生の84.9%がAIを利用|生成AIで新卒採用はどう変わったか【27卒】
27卒では就職活動でAIを使った学生が84.9%に達し、前年の66.6%から大きく増えました。ESの推敲から自己分析や相談まで広がった学生側の使い方と、54.8%が採用業務でAIを使う企業側の実態を、最新調査から整理します。
次のAIツール選びへ
気になるツールを並べて、料金や特徴の違いを確認できます。