Text-to-Imageとは?文章から画像を作る仕組みと権利まわりの注意点
画像生成ツールの設定画面や紹介記事で、Text-to-Image(テキスト画像生成)という言葉を見かけることがあります。
文章を打ち込むと画像が出てくる、という漠然とした理解はあっても、他の生成方式と何が違うのか、権利まわりはどうなっているのかは分かりにくい言葉です。
この記事では、Text-to-Imageが何を指す言葉なのか、文章がどう画像になるのか、生成した画像の権利で確認しておきたい点を、公式ドキュメントの記述から整理します。
権利まわりは断定しにくい話なので、各社の言い方の違いも一緒に見ていきます!
この記事の監修者
AIリスキル株式会社 代表取締役
AIツールギャラリーを運営するAIリスキル株式会社の代表取締役。企業・自治体向けの生成AI研修とAI導入支援を手がけています。
実績: 大阪・関西万博 公式プログラム「AI HEROES COLLECTION」司会進行 / 神戸市デジタル人材育成エコシステム構築事業の運営 / MBS「せやねん!」「よんチャンTV」に生成AIの専門家として出演 / Felo日本初コアアンバサダー / Genspark第1期公式アンバサダー / Skywork公式アンバサダー / AKOOL公式パートナー など
Text-to-Imageとは、文章を入力して画像を出力する方式のこと
Text-to-Image(テキスト画像生成、T2I)は、文章(テキストプロンプト)を入力として受け取り、その内容に沿った画像を出力する生成方式を指す言葉です。
OpenAIの開発者向けドキュメントは、テキストプロンプトをImage APIまたはResponses APIに渡すと、画像データが返る処理として説明しています。
Googleのドキュメントも、レストランの一皿を説明する文章のような例を挙げ、そのテキストから画像を生成する流れを示しています。
Adobe Fireflyの公式ページも、短い文章のプロンプトを入力すると、その内容に沿った画像が生成されると説明しています。
こうした「文章を入力し、画像を出力する」という組み合わせは、生成AIがもつ入出力の組み合わせの一つです。
文章はどうやって画像になるのか
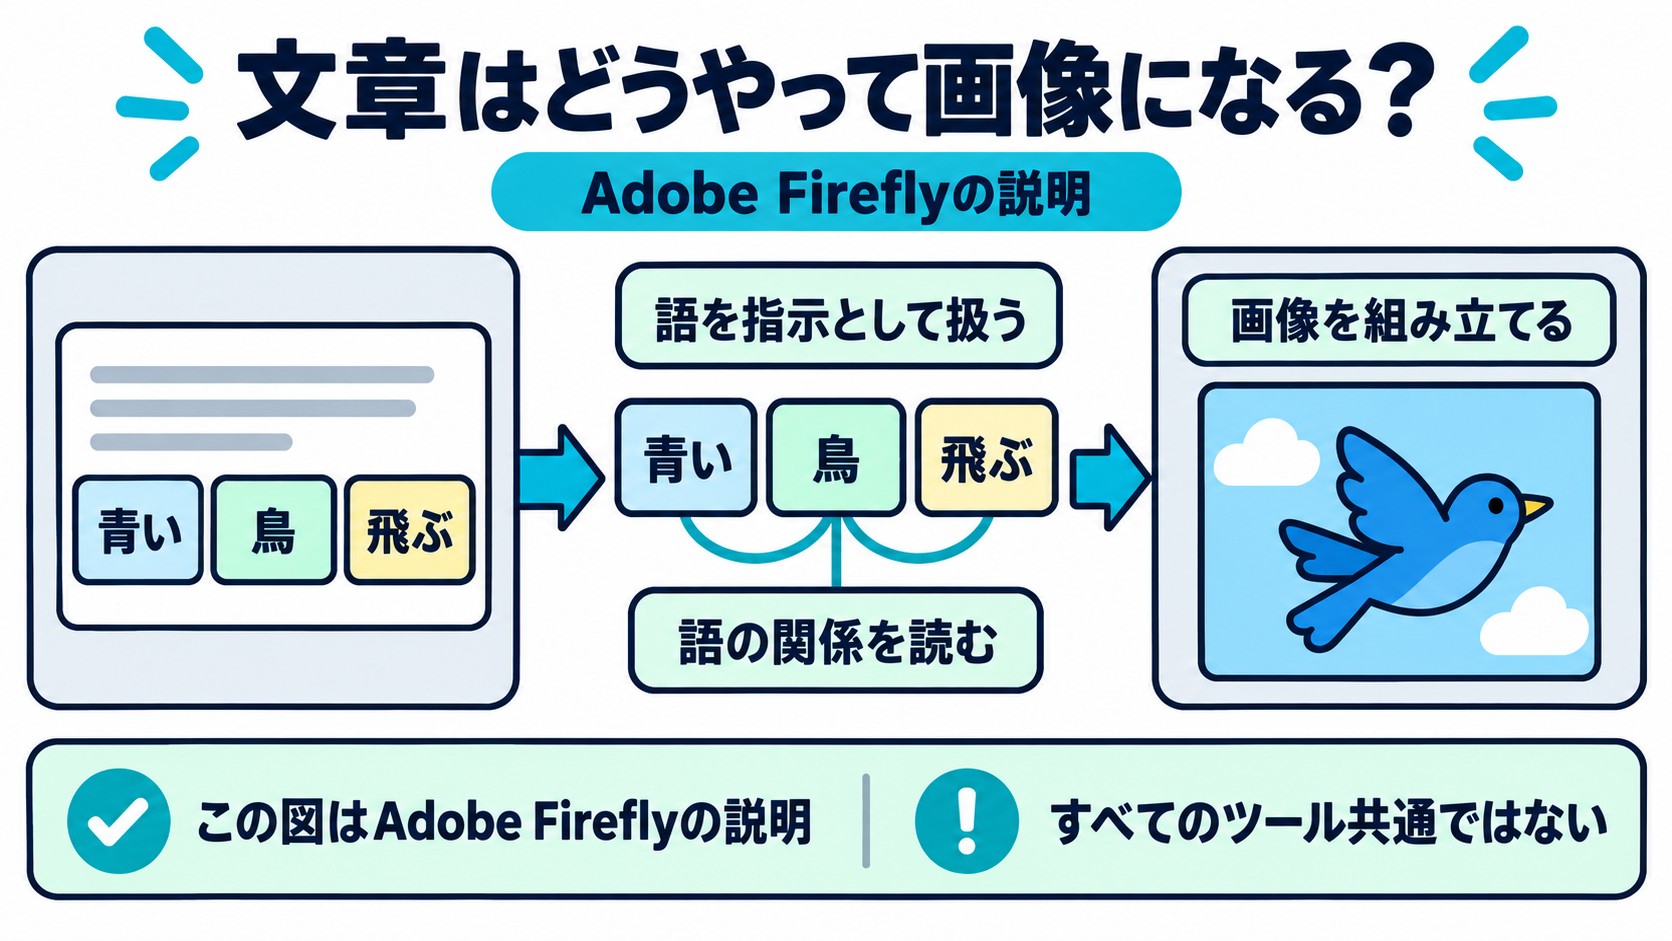
具体的な処理はサービスごとに異なりますが、公式ドキュメントで確認できた説明を紹介します。
Adobe Fireflyの公式ページは、文章に含まれる語のひとつひとつを指示として受け取り、語同士の関係にもとづいて画像を組み立てる、と説明しています。
OpenAIの開発者向けドキュメントは、Responses APIを使う場合、渡したプロンプトをモデルが自動的に書き換えてから生成することがある、とも説明しています。
つまり、入力した文章がそのまま最終的な生成条件になるとは限らず、サービス側で調整が加わることがあります。
この説明はAdobe FireflyとOpenAIそれぞれの公式ドキュメントに基づくものであり、すべてのText-to-Imageツールの内部処理を表しているわけではありません。
1つの指示から何枚の画像ができるのか
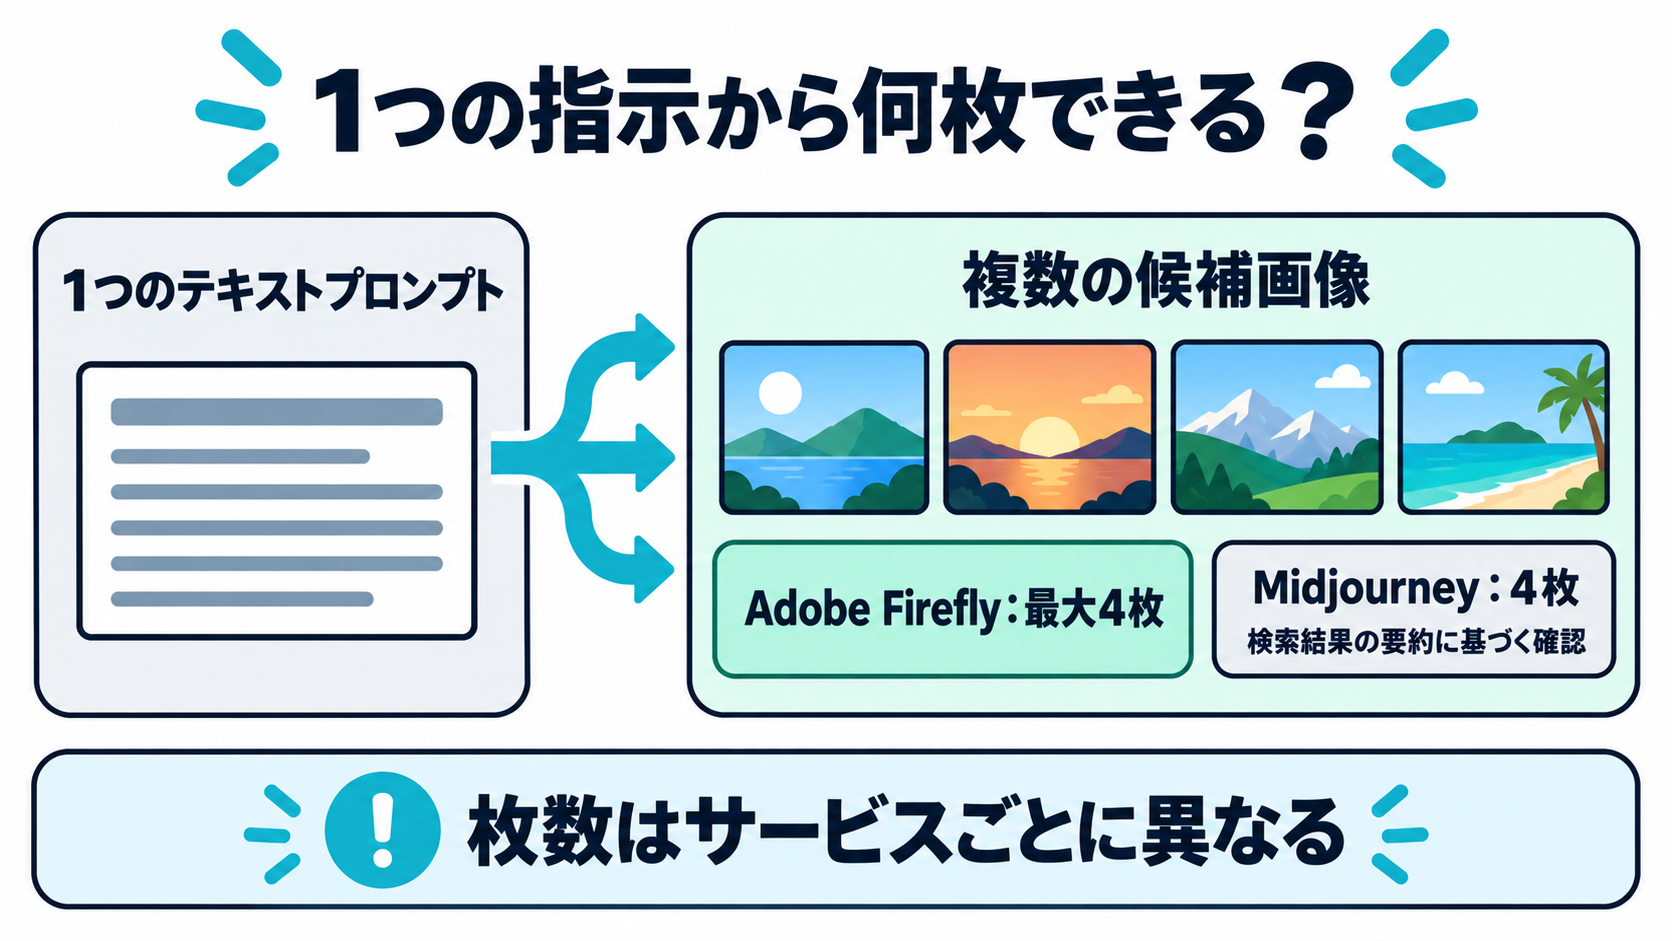
生成される画像の枚数も、サービスによって異なります。
Adobe Fireflyの公式ページによると、1回のプロンプトに対して最大4枚の候補画像が生成されます。
Midjourneyの公式ドキュメント(検索結果の要約に基づく確認)でも、1つのプロンプトから4枚の画像が生成されると説明されています。
この「4枚」という数はAdobe FireflyとMidjourneyという別々の製品が採用している値であり、Text-to-Image全体の標準的な枚数と決まっているわけではありません。
画像を生成するモデルの位置づけは基盤モデルで扱っています。Text-to-Imageで使われるモデルも、この位置づけの中で理解できます。
画像から画像を作る方式・文章から動画を作る方式との違い
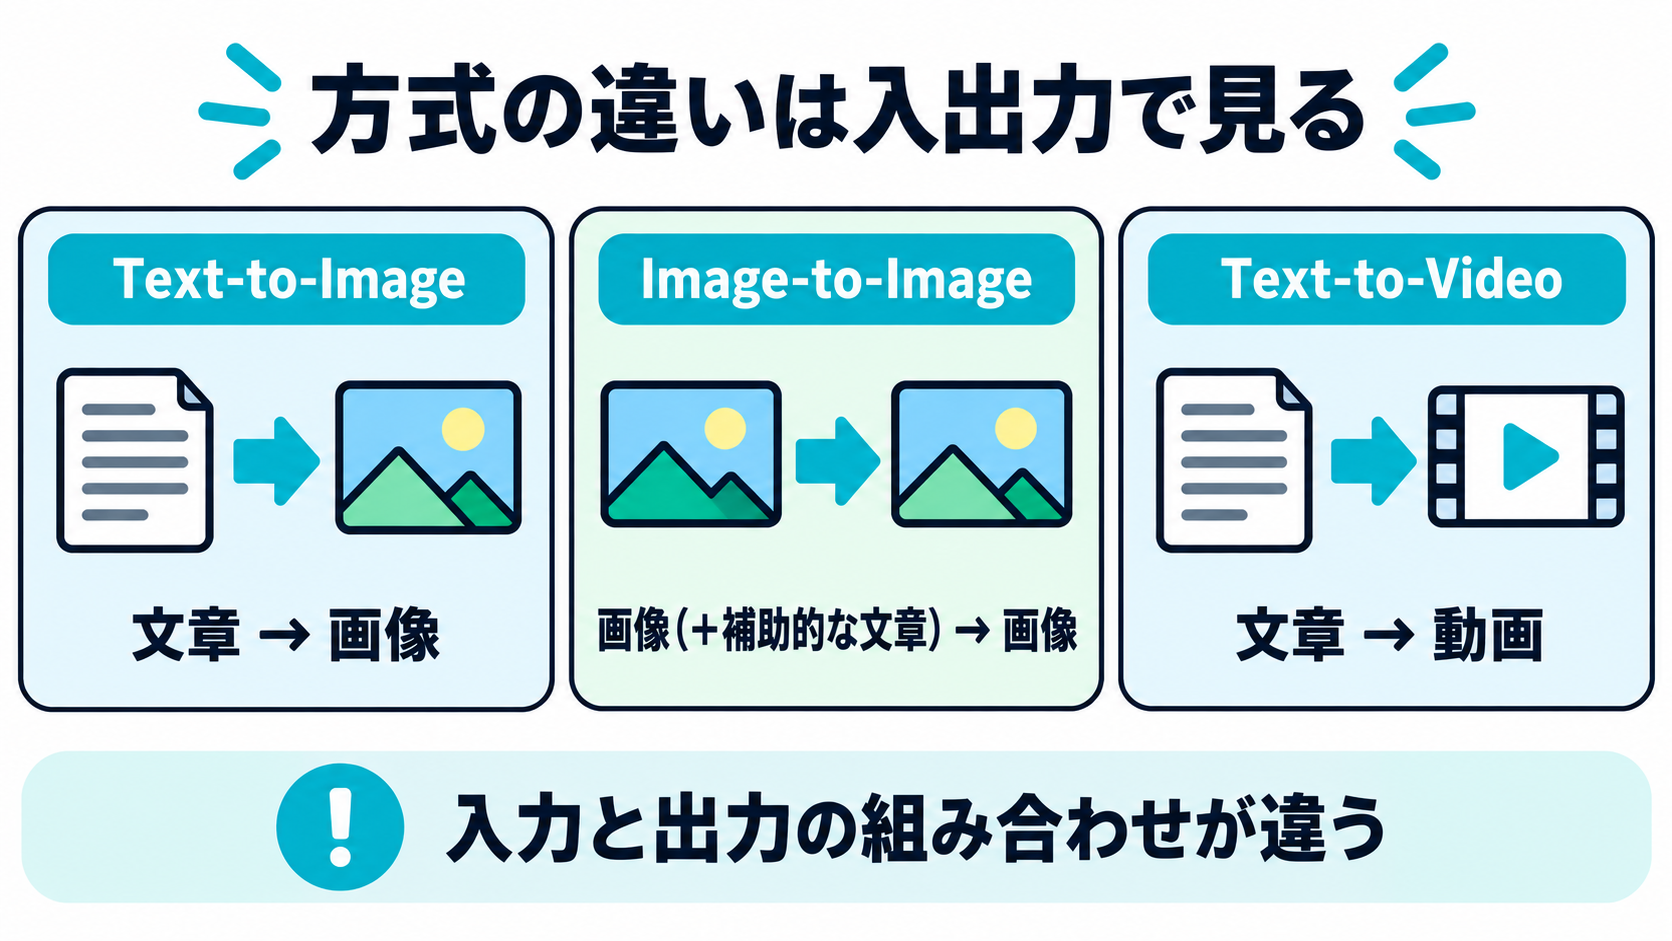
似た名前の方式との違いは、入力と出力の組み合わせで整理できます。
Text-to-Imageは、入力が文章、出力が画像です。
画像を入力にして新しい画像を作る方式は、入力が画像(と補助的な文章)、出力が画像になります。この記事では詳しく扱いません。
文章から動画を作る方式は、入力が文章のまま、出力が画像ではなく動画に変わります。こちらも仕組みの詳細は別の記事の領域です。
つまりText-to-Imageは、入力・出力ともに、これらの方式とは異なる組み合わせを指す言葉です。
プロンプトはどう書けばよいのか
プロンプトの書き方の基本的な考え方はプロンプトで扱っています。

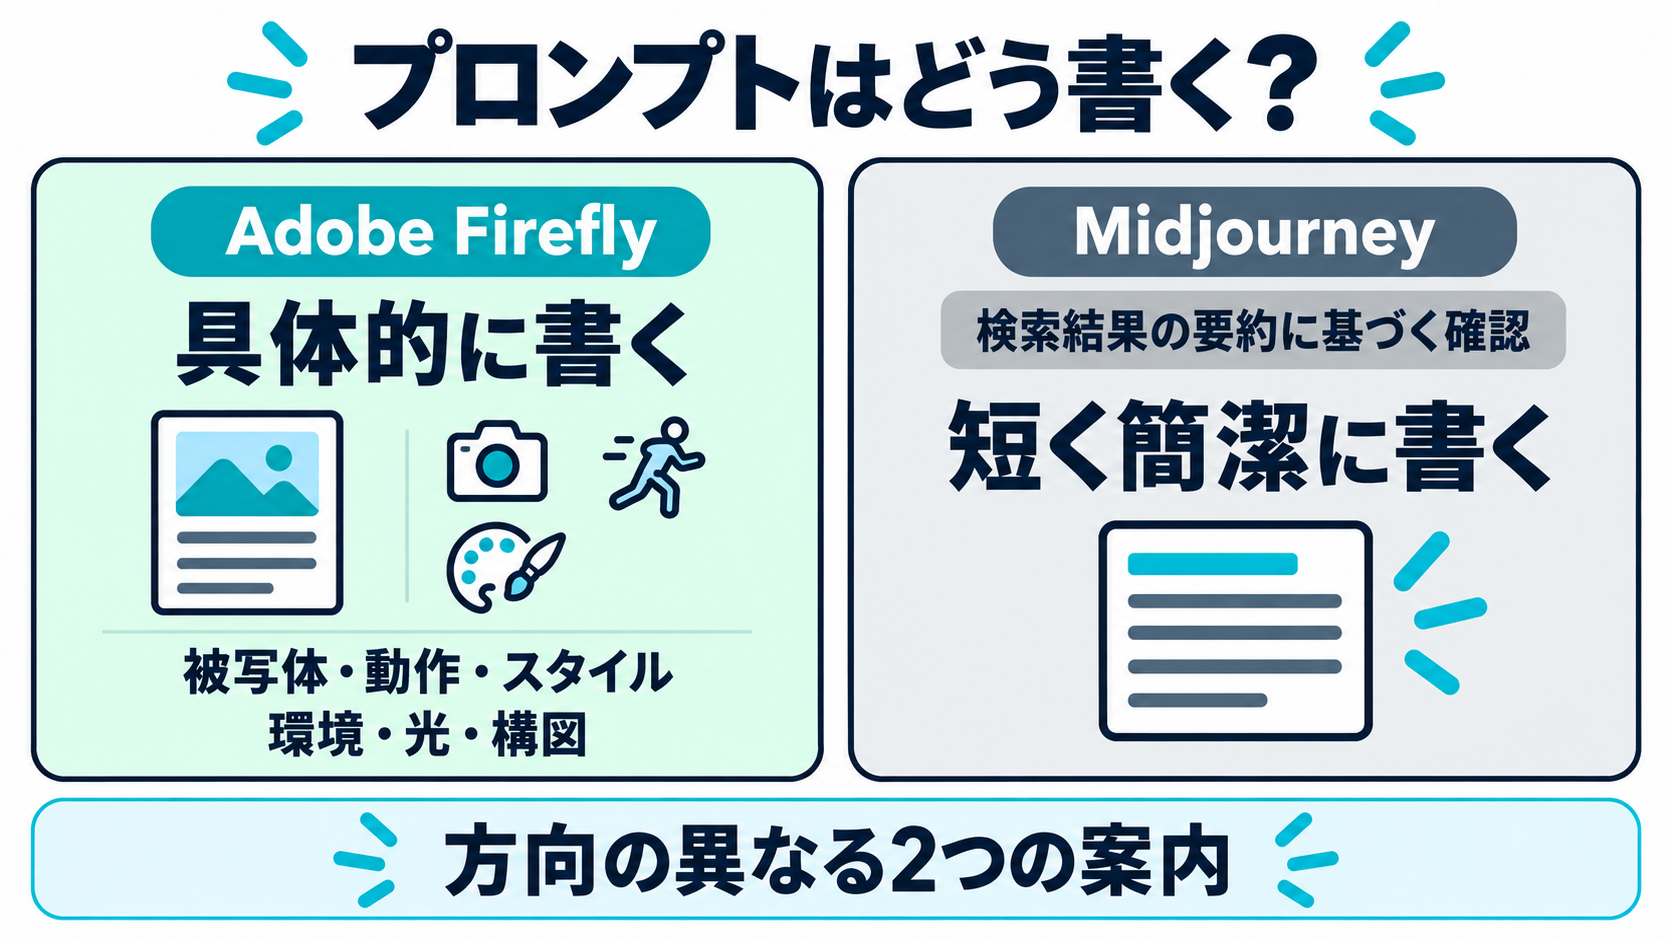
その上で、Text-to-Image特有の案内として、サービスごとに推奨の方向が違う点を押さえておくと役立ちます。
Adobe Fireflyの公式ページは、被写体・動作・スタイル・環境・光・構図を、できるだけ具体的に書くことを勧めています。
一方でMidjourneyの公式ドキュメント(検索結果の要約に基づく確認)は、短く簡潔なプロンプトのほうが良い結果になりやすい、と案内しています。
どちらが正しいという話ではなく、使うサービスの案内に沿って書き方を調整する必要があります。
生成した画像の権利・商用利用はどうなるのか
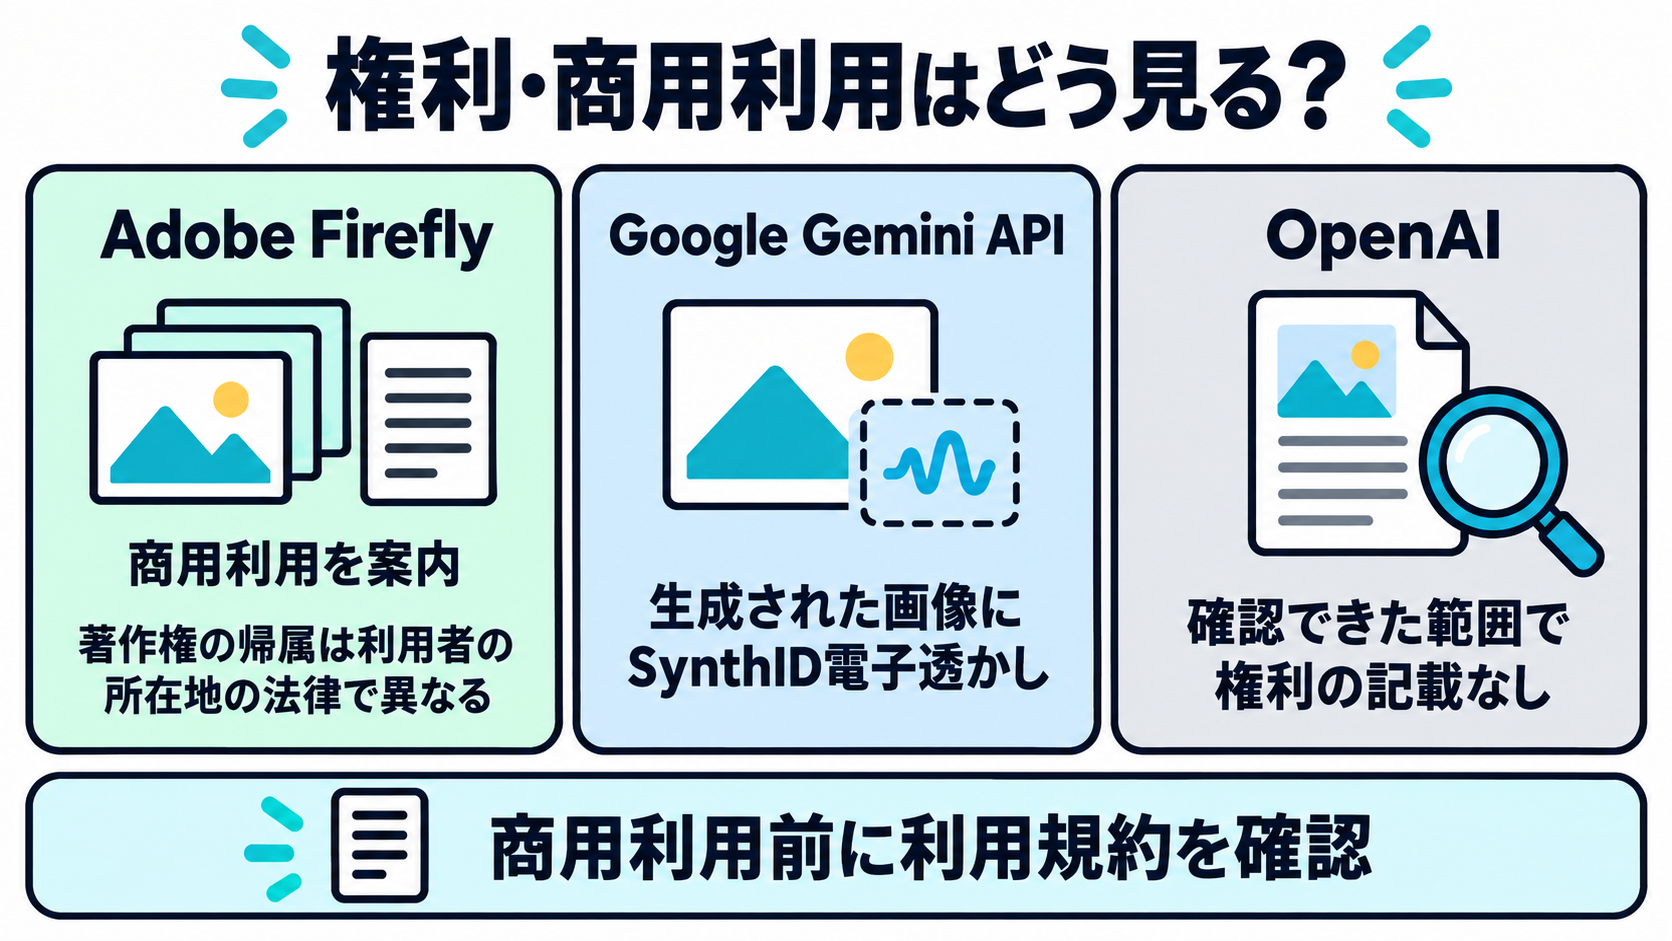
権利まわりの扱いは、サービスによって説明の踏み込み方が大きく異なります。
Adobe Fireflyの公式ページは、ライセンス済みのAdobe Stock画像と著作権が失効した公有画像で学習していることを理由に、生成した画像を商用プロジェクトで利用できるとしています。
同じページのFAQでは、著作権の帰属は利用者の所在地の法律によって異なる、とも明記しています。
Googleのドキュメントは、生成した画像すべてにSynthIDという電子透かしが入ると説明しています。
同ドキュメントは、参照用にアップロードする画像の権利を利用者自身が確認すること、他者の権利を侵害する内容を生成しないことも求めています。
OpenAIの開発者向けドキュメントには、今回確認できた範囲では権利や所有権についての記載はありませんでした。記載がないことをもって問題がないとは判断できません。
権利の扱いはサービスごとに条件が異なるため、商用で使う前には、実際に使うサービスの利用規約を確認する必要があります。
権利面は「保証されている」と思い込まず、使う直前に規約を確認する習慣が安心です!
よくある質問
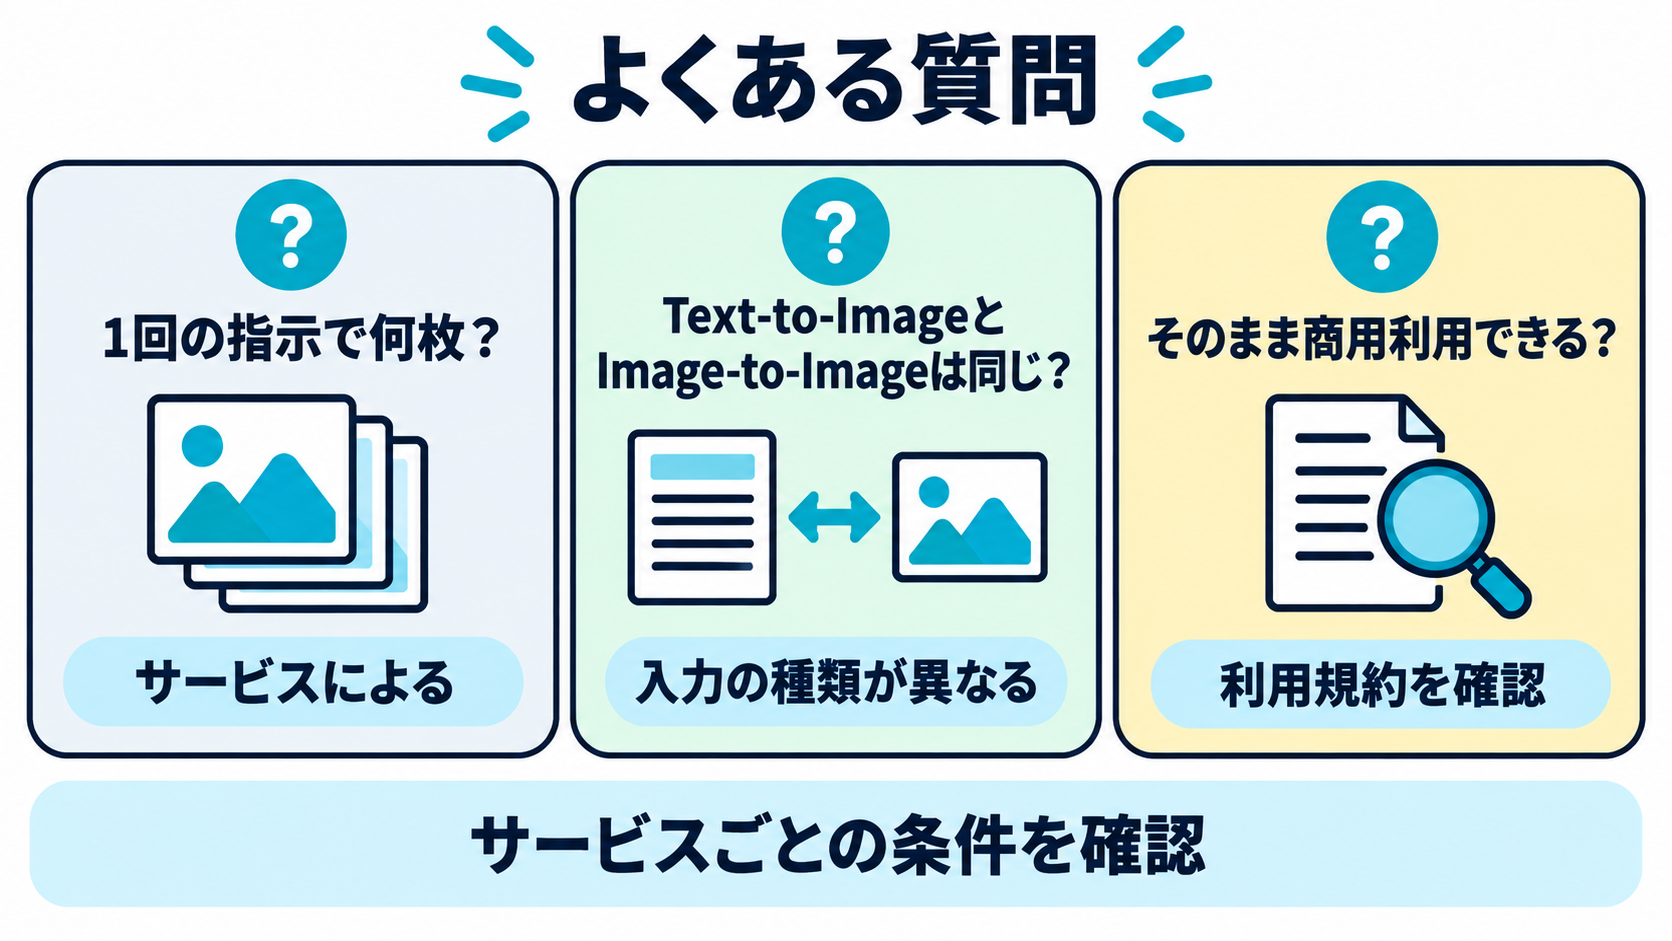
Text-to-ImageとImage-to-Imageは同じものですか
違います。Text-to-Imageは入力が文章で出力が画像の方式です。
Image-to-Imageは入力が画像(と補助的な文章)で出力が画像になる方式です。入力の種類が異なります。
1回の指示で何枚の画像ができますか
サービスによります。Adobe Fireflyの公式ページでは最大4枚、Midjourneyの公式ドキュメント(検索結果の要約に基づく確認)でも4枚という説明が見られました。
同じ枚数ですが、これは2つの製品がたまたま同じ値を採用している事実であり、すべてのText-to-Imageツールが4枚生成するとは限りません。
生成した画像はそのまま商用利用できますか
サービスによって説明の踏み込み方が違います。Adobe Fireflyは商用利用できると案内しつつ、著作権の帰属は利用者の所在地の法律によるともFAQで明記しています。
OpenAIの開発者向けドキュメントには、確認できた範囲で権利についての記載がありませんでした。商用で使う前には、実際に使うサービスの利用規約を確認してください。
まとめ
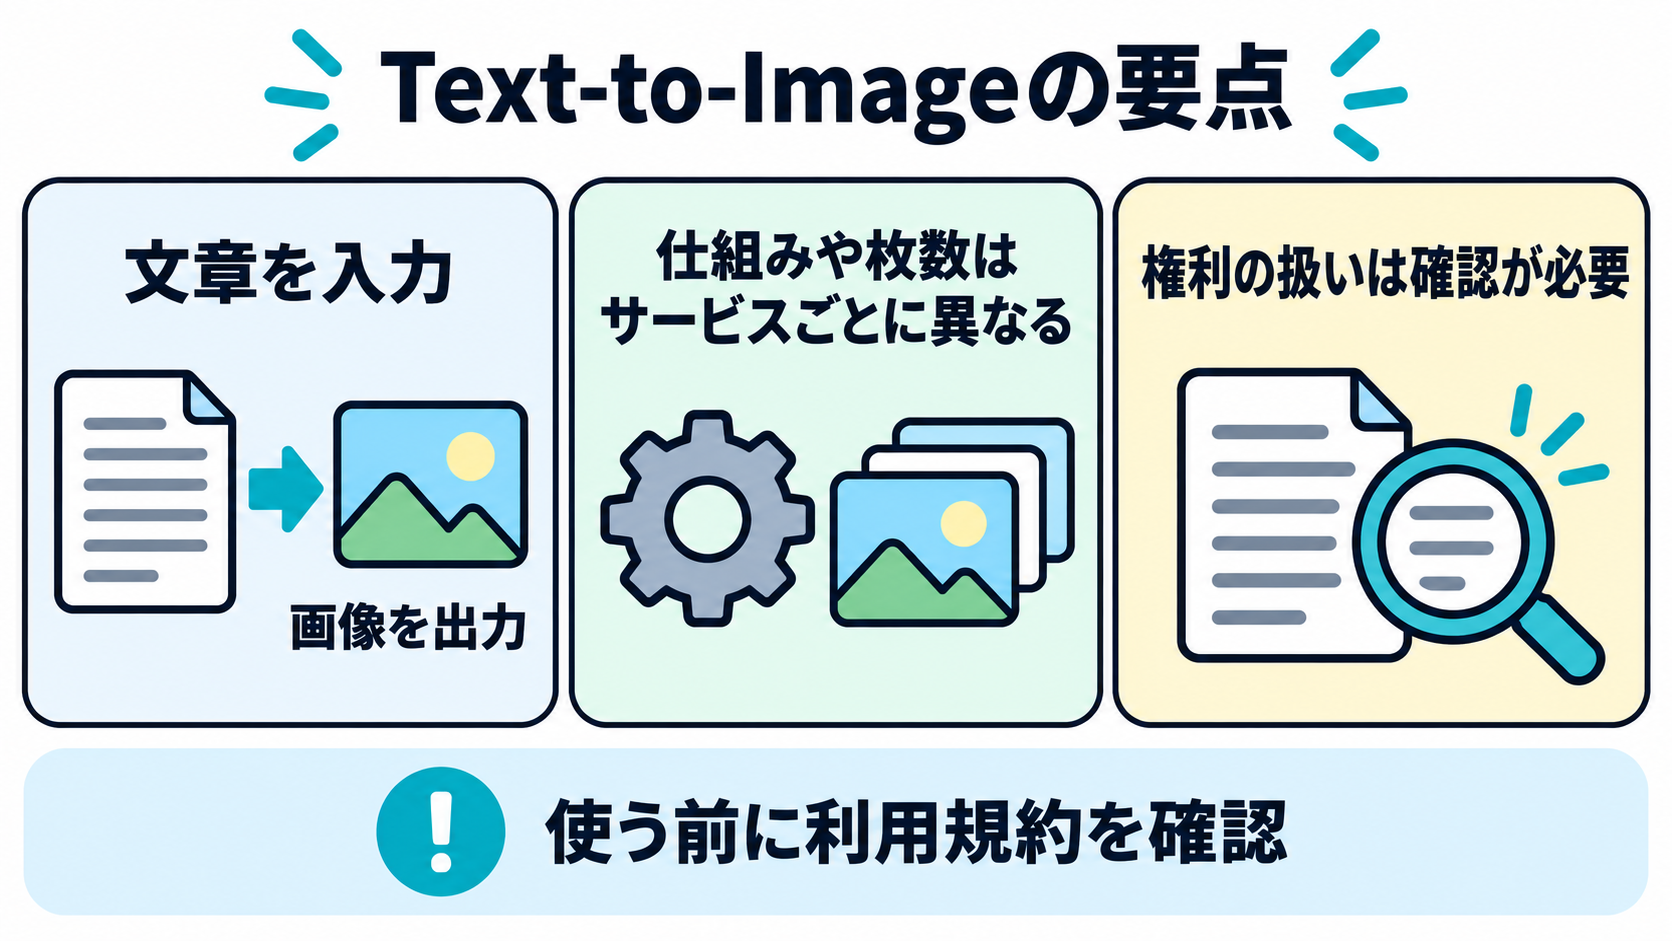
Text-to-Imageとは、文章(テキストプロンプト)を入力とし、その内容に沿った画像を出力する生成方式を指す言葉です。
文章がどう画像になるかの説明や、1回の指示でできる画像の枚数は、サービスごとに異なります。
画像から画像を作る方式や、文章から動画を作る方式とは、入力と出力の組み合わせが異なります。
生成した画像の権利や商用利用の扱いも、サービスごとに条件が異なります。使う前に利用規約を確認することが必要です。
画像生成に使われるモデルの位置づけは基盤モデルで、プロンプトの書き方全般はプロンプトで扱っています。Text-to-Imageの活用や社内導入を相談したい場合はお問い合わせはこちらからご相談ください。
この記事の出典
- Image generation - OpenAI Developers(OpenAI Developers、2026-09-13確認)
- Image generation with Gemini - Gemini API(Google、2026-09-13確認)
- Free Online AI Text to Image Generator - Adobe Firefly(Adobe、2026-09-13確認)
- Midjourney公式ドキュメント(Prompt Basics ほか、docs.midjourney.com。2026-09-13、検索結果の要約に基づく確認)
この記事は役に立ちましたか?
感想は、今後の記事改善に活用します。
関連記事
ジェイルブレイク(Jailbreak)とは?Anthropicの公式説明をもとにした用語の範囲
本記事ではAnthropicの公式説明をもとに、ジェイルブレイクを提供元が設けた制限を回避しようとする試みとして扱います。会社で確認したい自社規程・契約・提供元の説明、相談先・記録の選択肢を整理します。
Zero-shot(例を示さない依頼)とは?業務での使い分けと指示の書き方
Zero-shotとは、AIにお手本の例を示さず、指示と必要な情報だけで頼む書き方です。例を示す場合との使い分け、指示に書く項目、業務で確認したい点を会社員向けに解説します。
Few-shot(少数例プロンプト)とは?AIへの依頼にお手本を添える書き方
Few-shotとは、AIへの依頼文に望む入出力のお手本を少数添え、出力の型や判断の例を示す書き方です。例の選び方、業務データの確認点、構造化出力との違いを解説します。
思考の連鎖(Chain of Thought)とは?AIに途中の考えを順に出させる依頼の仕方
思考の連鎖(CoT)は、AIに結論だけでなく途中の考えや理由を順に出させる依頼の仕方です。推論モデルとの違い、業務で確認したい点、出力をそのまま信じない理由を解説します。
次のAIツール選びへ
気になるツールを並べて、料金や特徴の違いを確認できます。