Image-to-Videoとは?Text-to-Videoとの違いと画像の使われ方
AI動画生成ツールを開くと、「Text to Video」と並んで「Image to Video」というモードが用意されていることがあります。
Text to Videoは文章だけから動画を作ります。Image to Videoは、そこに1枚の画像を入力として加えます。
この記事では、Image-to-Videoが何を指す言葉なのか、Text-to-Videoと何が違うのか、入力した画像が動画の中でどう使われるのかを、実際のツールの仕様で整理します。
画像を入れるとどう変わるのか、ここが一番の引っかかりどころです!
この記事の監修者
AIリスキル株式会社 代表取締役
AIツールギャラリーを運営するAIリスキル株式会社の代表取締役。企業・自治体向けの生成AI研修とAI導入支援を手がけています。
実績: 大阪・関西万博 公式プログラム「AI HEROES COLLECTION」司会進行 / 神戸市デジタル人材育成エコシステム構築事業の運営 / MBS「せやねん!」「よんチャンTV」に生成AIの専門家として出演 / Felo日本初コアアンバサダー / Genspark第1期公式アンバサダー / Skywork公式アンバサダー / AKOOL公式パートナー など
Image-to-Videoとは、画像を入力にして動画を作る機能
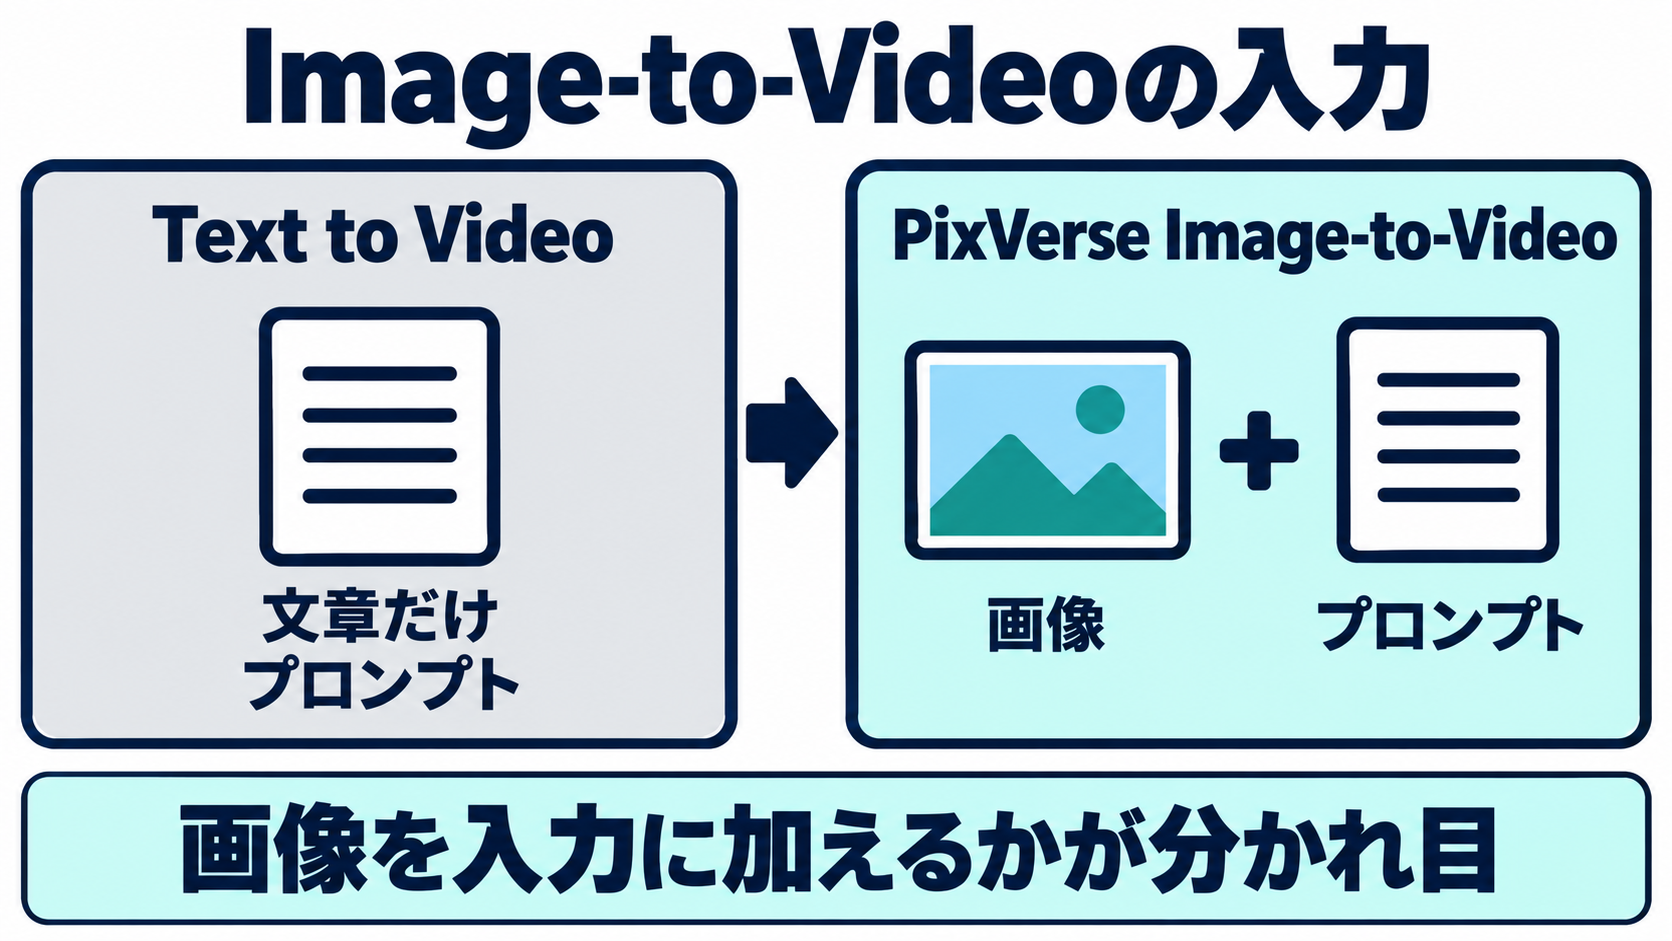
Image-to-Video(画像動画化、I2V)は、1枚の画像を入力として渡し、その画像をもとに動画を生成する機能です。
MiniMaxのAPIドキュメントは、この機能の必須パラメータを「first_frame_image」と呼び、動画の開始フレームとなる画像だと説明しています。
OpenAIのSoraのドキュメントも、「input_reference」という画像入力パラメータについて、入力画像が動画の先頭フレームとして機能すると説明しています。
具体的な実装や画像の扱い方は製品によって異なりますが、画像を入力に含めるかどうかが、Text-to-Videoとの最初の分かれ目です。
Text-to-Videoと何が違うのか
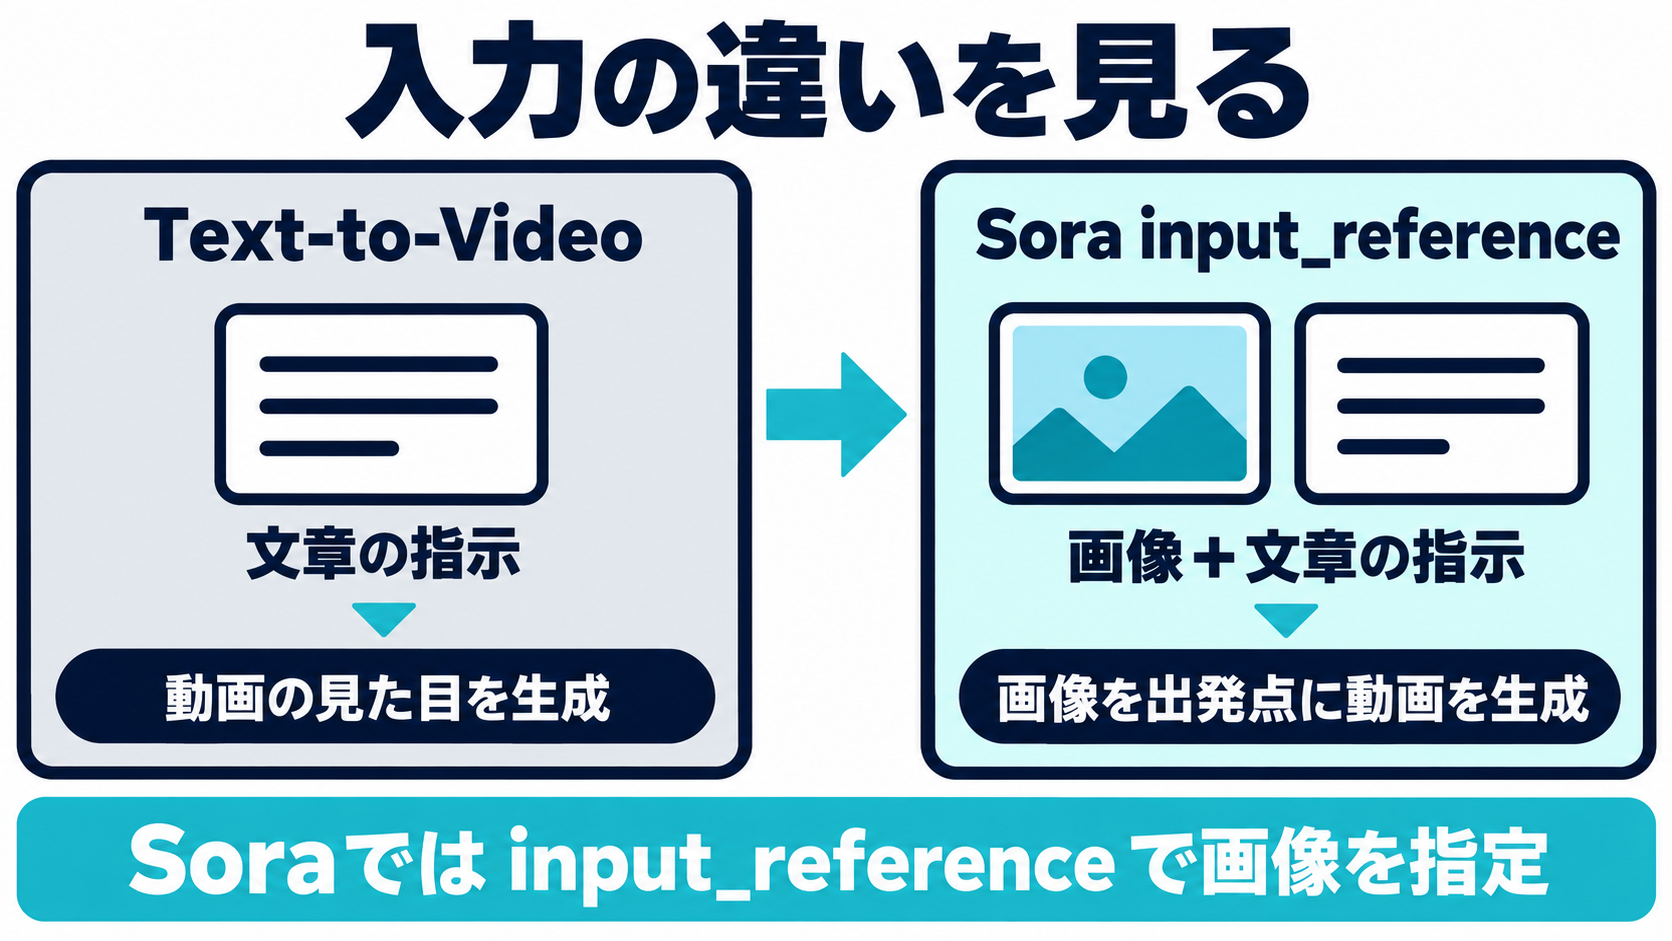
文章だけから動画を作る方式(Text-to-Video)の仕組みそのものは、この記事では繰り返しません。
ここで押さえておきたいのは、入力に画像を含めるかどうかという一点です。
OpenAIのSoraのドキュメントは、「input_reference」という画像入力パラメータを指定すると、その画像が動画の先頭フレームとして使われると説明しています。
裏を返せば、この画像入力パラメータを指定しなければ、文章の指示だけから動画の見た目全体が生成されることになります。
画像を入力に加えると、その画像に写っている構図や被写体を出発点にできます。文章だけの指示では、そこまで具体的な出発点を渡すことはできません。
入力した画像は動画の中でどう使われるのか
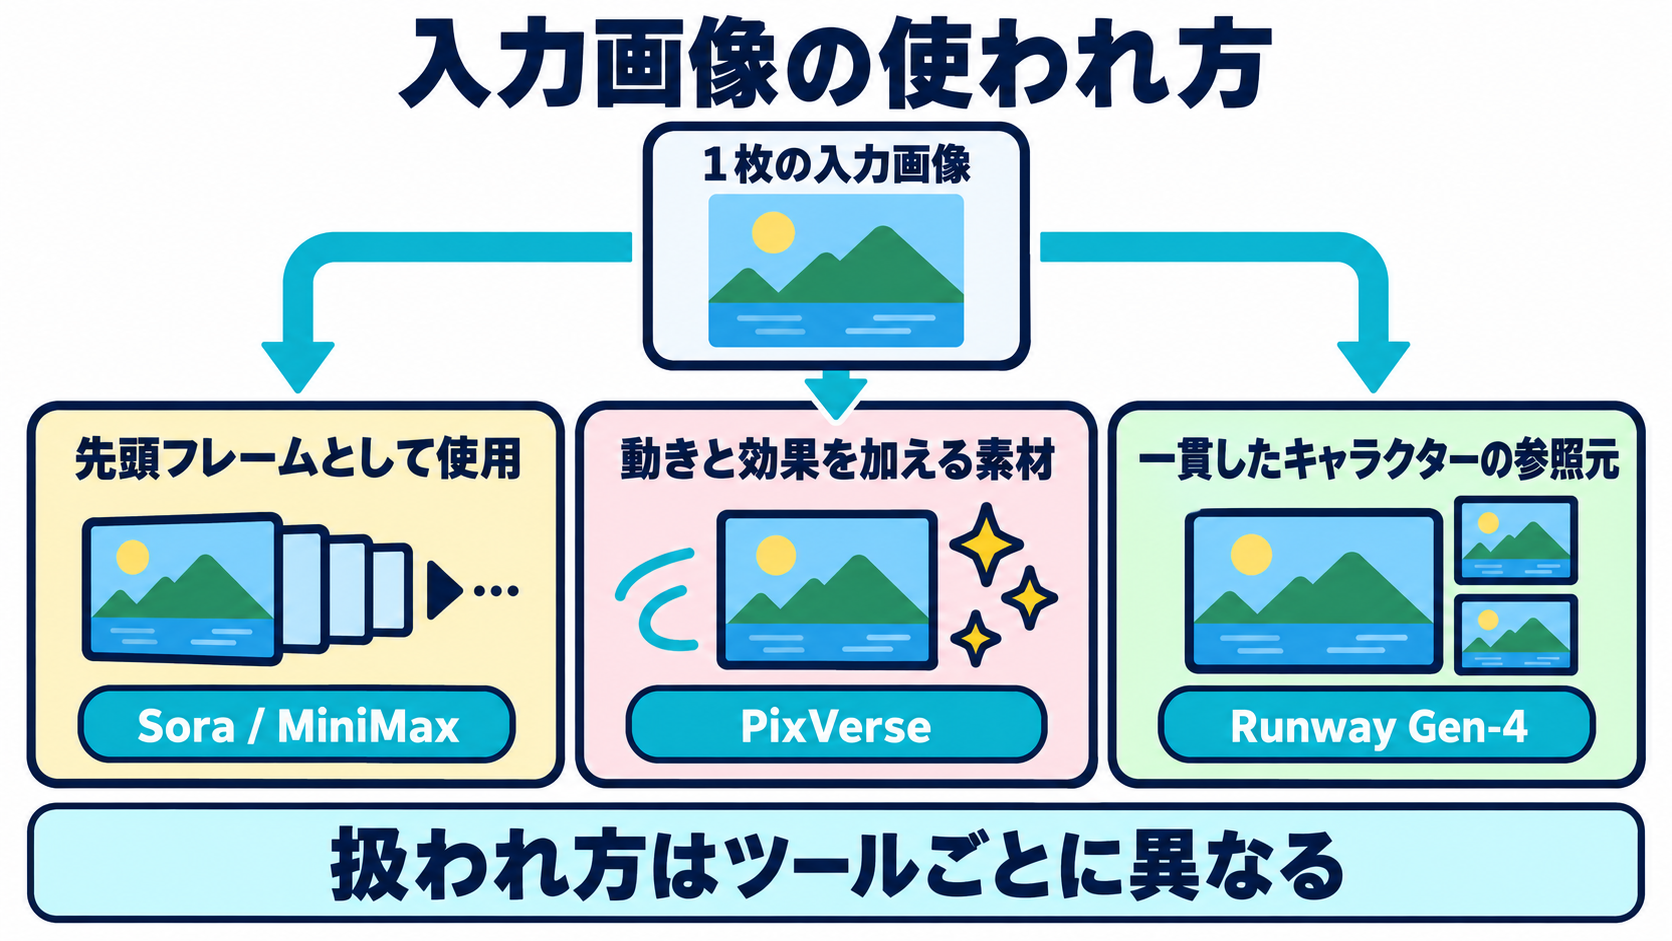
入力画像の扱われ方は、ツールのドキュメントを見る限り一様ではありません。
Soraのドキュメントは、「input_reference」で渡した画像が動画の先頭フレームとして機能すると明記しています。
MiniMaxのAPIも、パラメータ名そのものが「first_frame_image」(先頭フレーム画像)であり、画像を動画の開始点として扱う設計であることが読み取れます。
PixVerseのドキュメントは、この機能を静止画に動きと効果を加えて動的な動画に変換する処理と説明しています。入力画像が技術的に先頭フレームそのものになるとまでは明記されていません。
RunwayのGen-4は、少し違う角度で画像を使います。公式ページは、1枚の参照画像から一貫したキャラクターを、異なる照明や場所でも再現できると説明しています。先頭フレームの固定というより、参照元としての一貫性維持に重心があります。
つまり入力画像がどう反映されるかは、ツールごとのドキュメントで確認する必要がある部分です。
動きはどうやって指定するのか
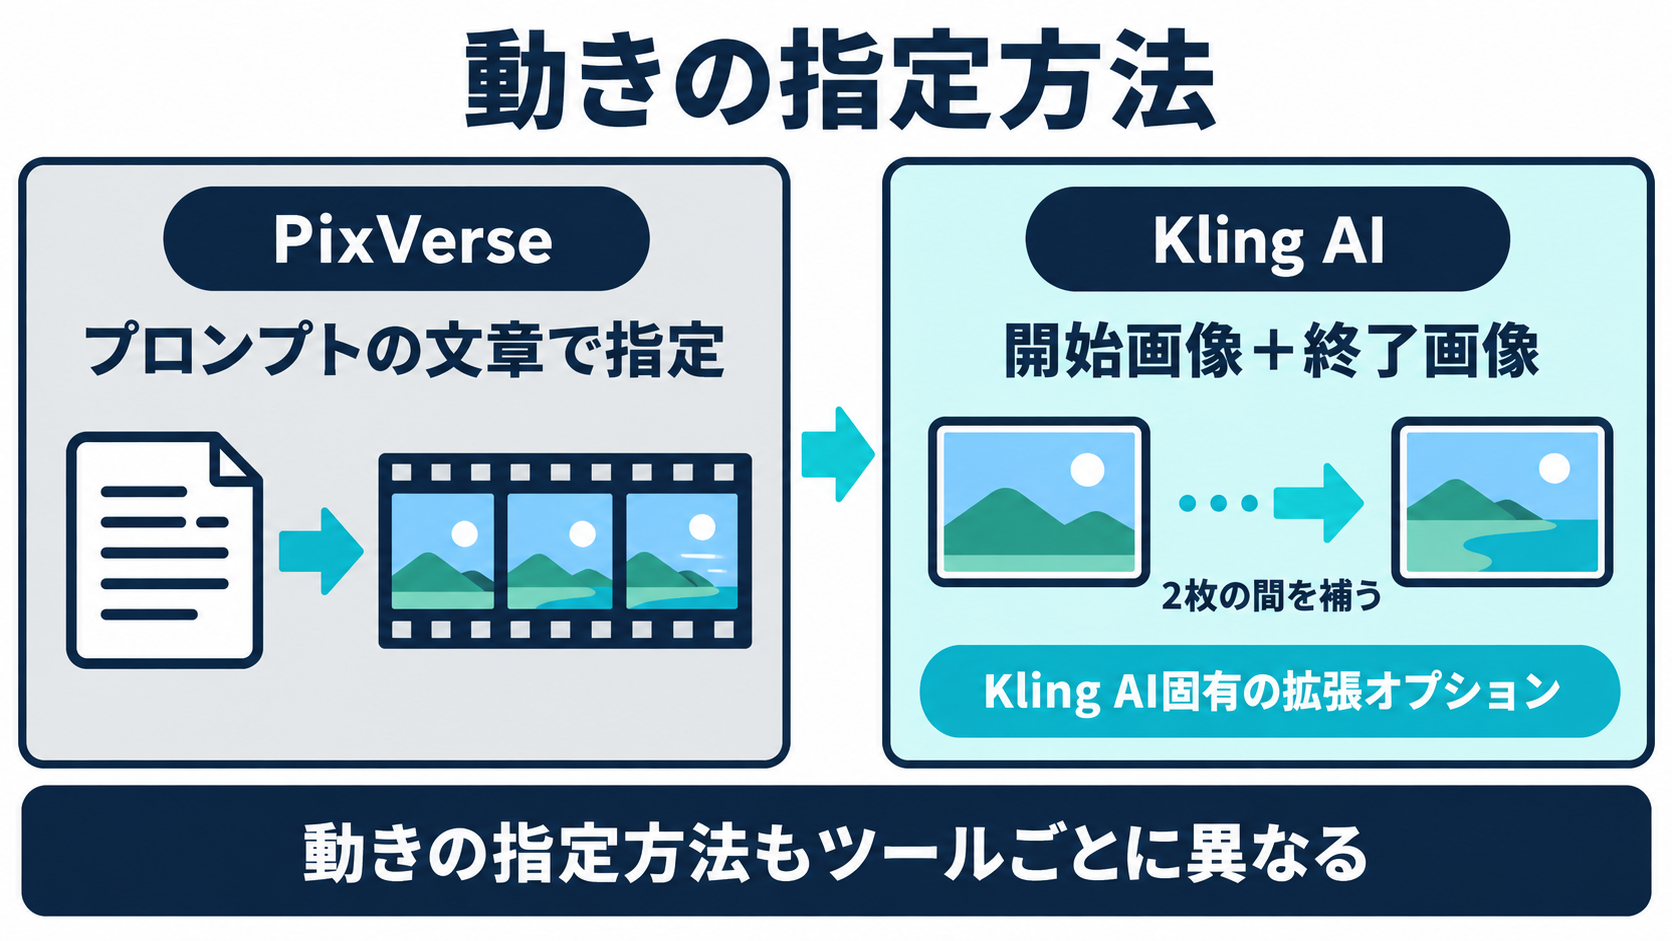
画像を入力に加えても、そのあとの動きの指定方法は1つではありません。
PixVerseのAPIドキュメントは、画像と一緒にプロンプト(5,000文字以内)を渡す構成を示しています。どんな動きにするかは、このプロンプトの文章で指示する形です。
Kling AIは、通常のImage to Video機能に加えて、開始フレームと終了フレームの2枚の画像を指定できる拡張オプションを持っています。公式ページは、この機能がアップロードした2枚の画像を使って間を補う遷移動画を生成すると説明しています。
同じページは、開始と終了の画像の内容が近いほど滑らかな遷移になり、差が大きいとカットが切り替わったような結果になりやすいとも注意しています。
この開始・終了フレームの指定は、確認できた範囲ではKling AI固有のオプションです。他のツールが同じ機能を持つとは限りません。
どんな画像を用意すればいいのか
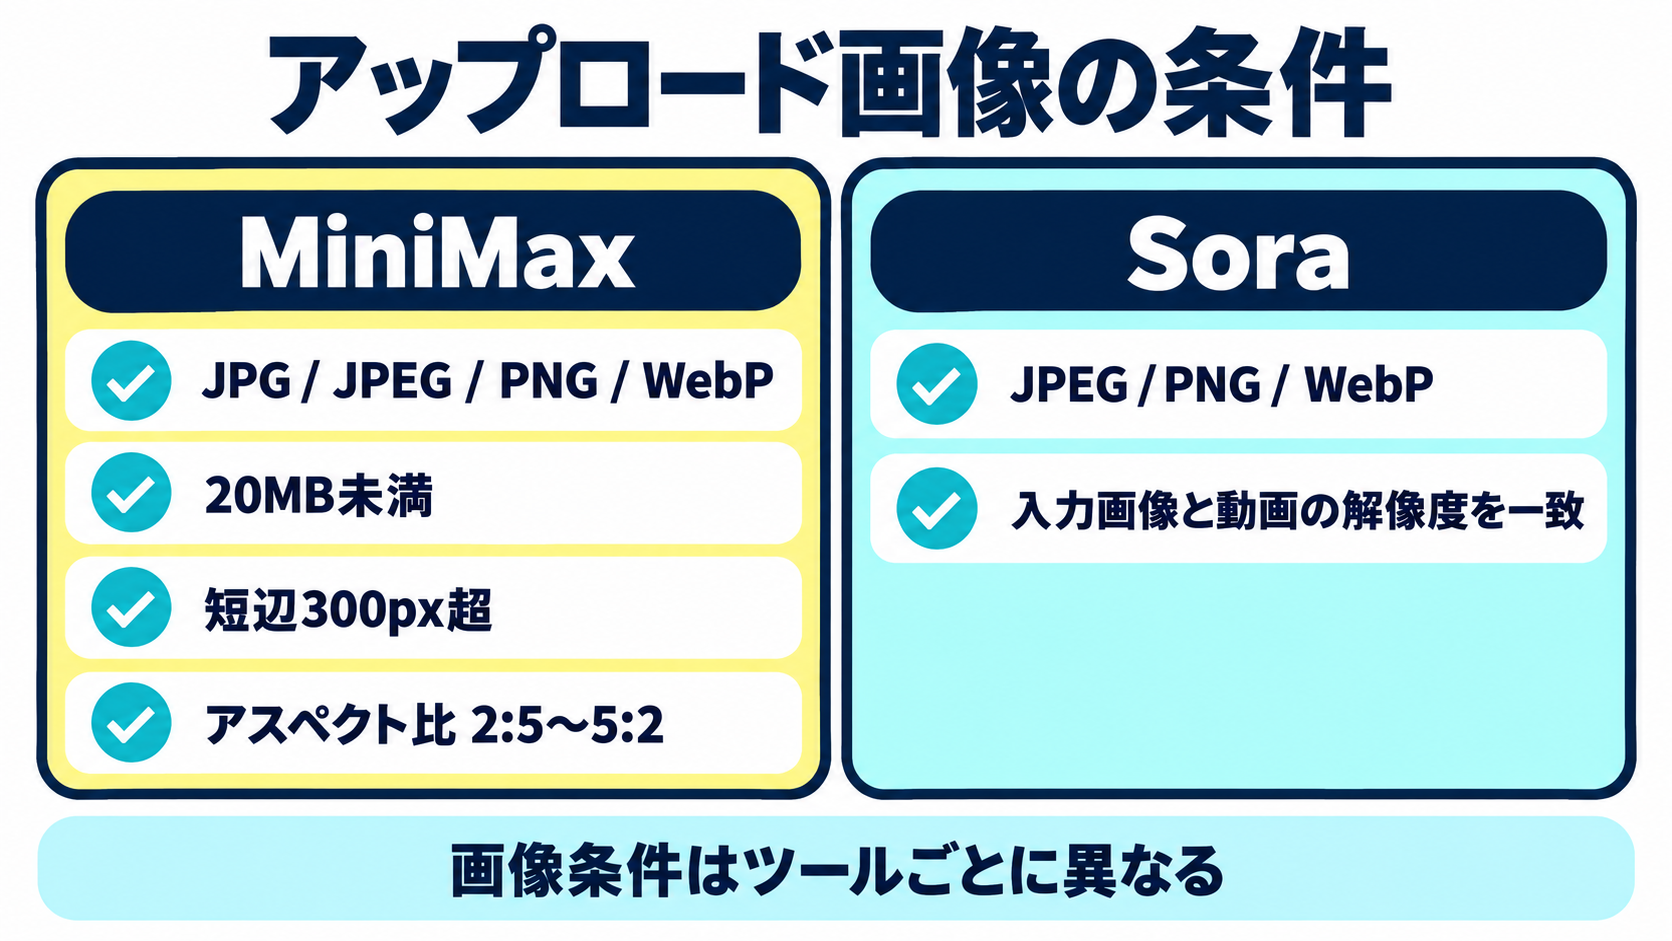
用意する画像の条件も、ツールのドキュメントで確認したほうがよい項目です。
MiniMaxのAPIドキュメントは、画像の形式をJPG・JPEG・PNG・WebPに限定し、サイズは20MB未満、短辺は300ピクセルを超え、アスペクト比は2:5から5:2の範囲に収まることを求めています。
Soraのドキュメントは、入力画像の解像度を、生成する動画の解像度と一致させる必要があると説明しています。対応する画像形式はJPEG・PNG・WebPです。
条件はツールごとに異なるため、使うツールのドキュメントで事前に確認しましょう。
どんな場面に向くのか
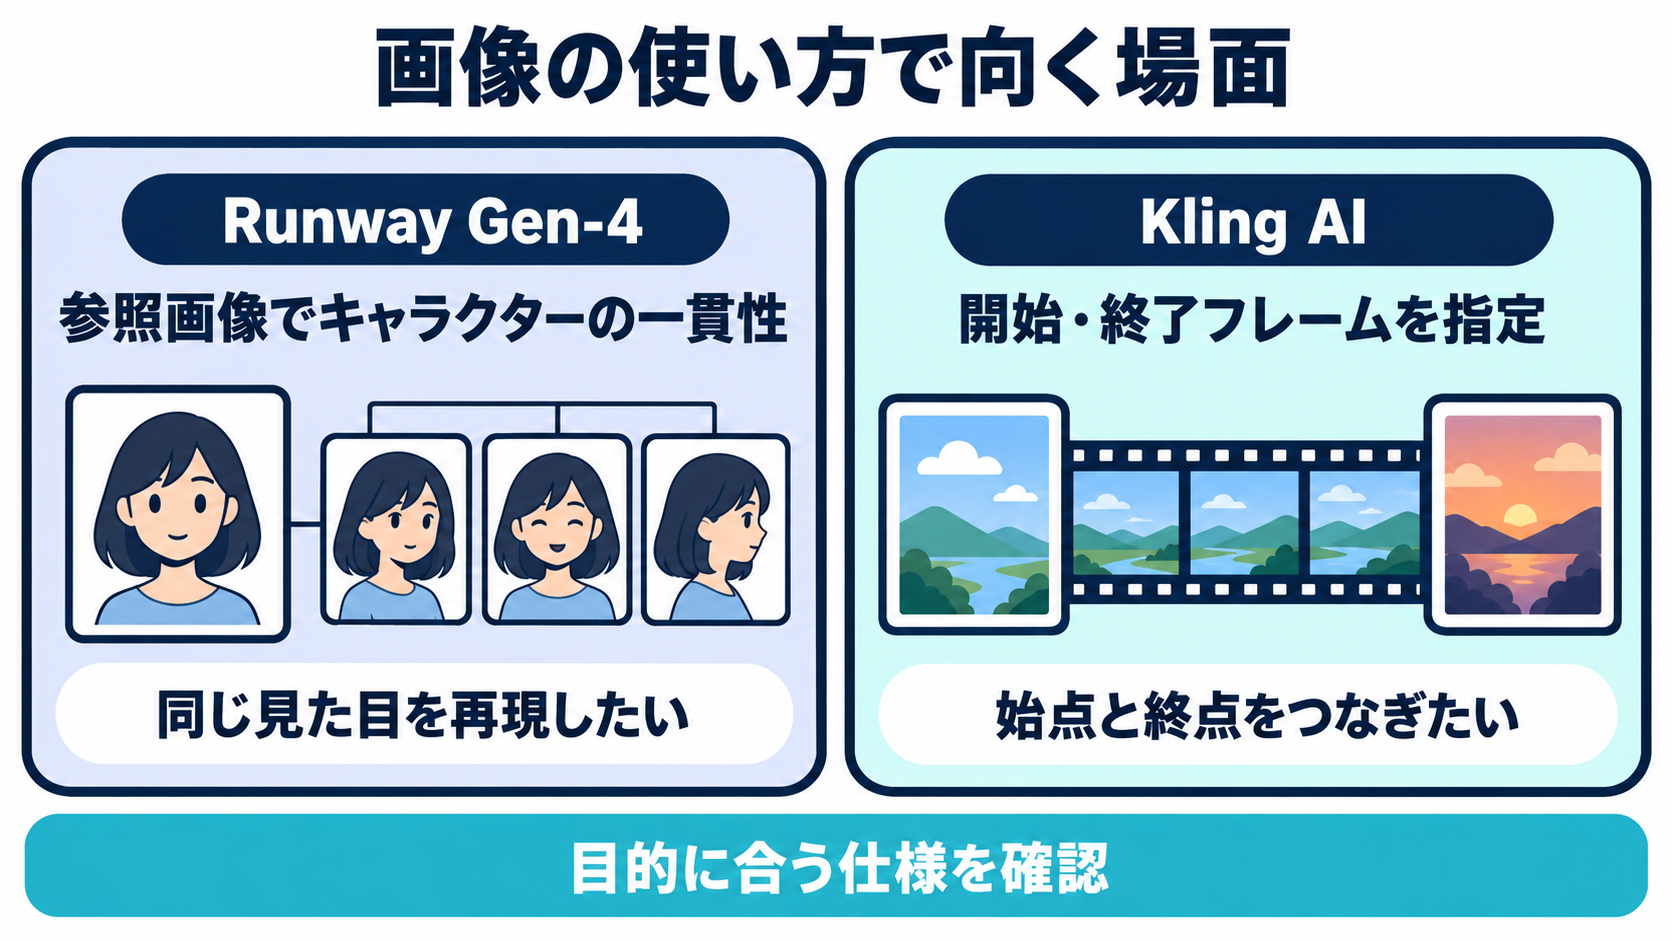
Image-to-Videoが向く場面は、ツールごとの特徴と合わせて考えると分かりやすくなります。
Runwayの公式ページが示すように、1枚の参照画像から一貫したキャラクターを異なる照明や場所でも再現できる、という特徴を持つツールであれば、既存のイラストや写真のキャラクターを別カットでも同じ見た目のまま動かしたい場面に向きます。
Kling AIのstart/end frame機能のように、開始と終了の2枚の画像を指定できるツールであれば、決まった始点と終点をつなぐ遷移動画を作りたい場面に向きます。
どのツールを選ぶかは、この記事の範囲を超えます。用途別の比較はAI動画生成ツール比較で扱っています。
Pika Labsのように、Image to Videoに対応するツールは他にも複数あります。
画像の使われ方も動きの指定方法もツールごとに違うので、候補のドキュメントは必ず確認してください!
よくある質問
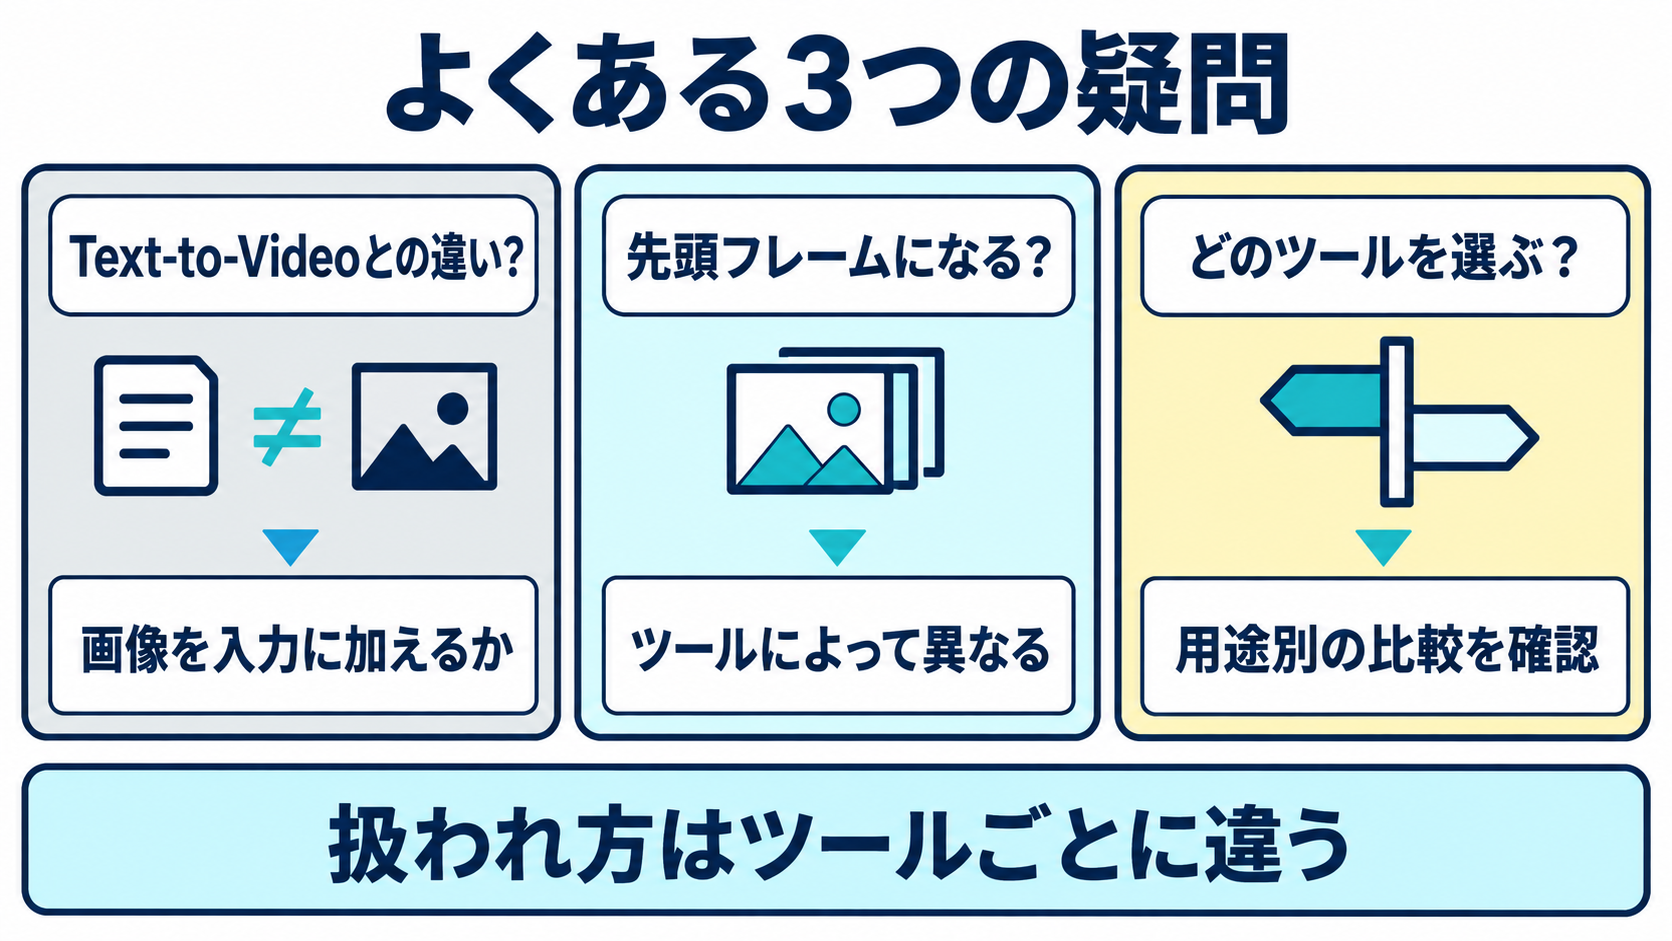
Text-to-VideoとImage-to-Videoはどちらが高品質ですか
この記事の範囲では判定できません。品質は入力の種類だけでなく、モデルやプロンプトの内容によっても変わります。
OpenAI(Sora)のドキュメントが示すのは、画像入力の有無で生成の出発点が変わるという仕組みの違いであり、優劣についての記載ではありません。
入力した画像は必ず動画の先頭フレームになりますか
ツールによります。SoraのドキュメントとMiniMaxのパラメータ名(「first_frame_image」)は、画像を先頭フレームとして扱う設計であることを示しています。
一方でPixVerseのドキュメントは、画像に動きと効果を加えて動画に変換するという説明にとどまり、先頭フレームになるとまでは明記していません。使うツールのドキュメントで確認することをおすすめします。
どのツールを選べばいいですか
この記事は用語の意味と仕組みの整理を目的としており、ツールの選定はカバーしていません。用途別の比較は前段で触れたAI動画生成ツール比較の記事をご覧ください。
まとめ
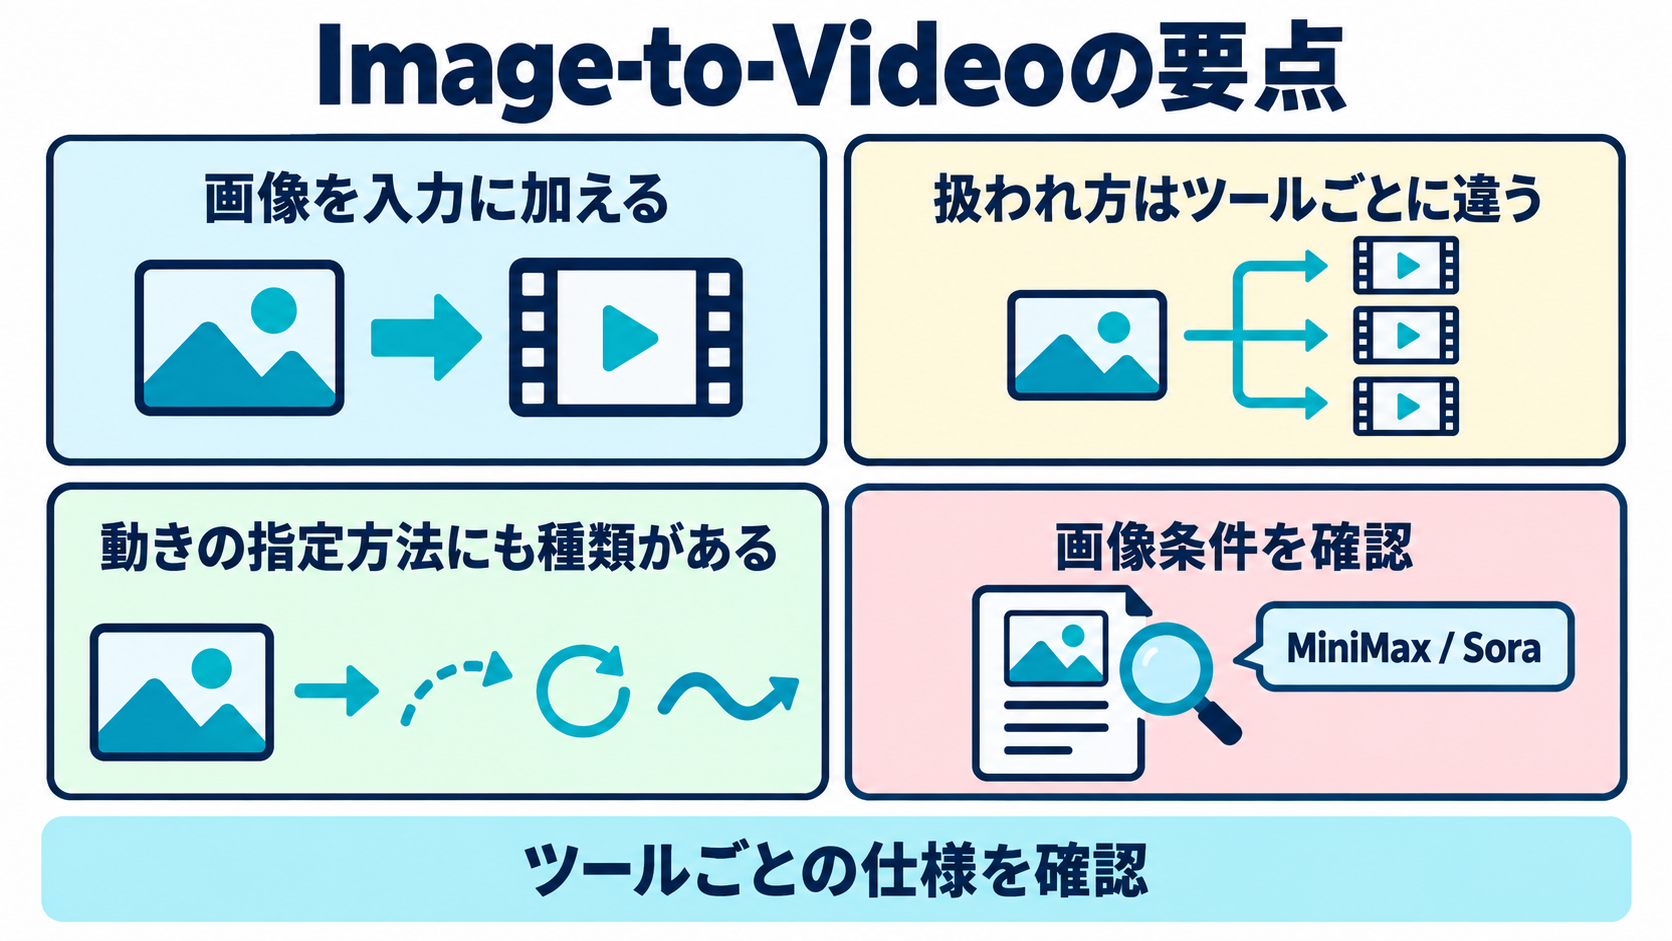
Image-to-Video(画像動画化、I2V)とは、1枚の画像を入力として渡し、その画像をもとに動画を生成する機能です。
Text-to-Videoとの違いは、入力に画像を含めるかどうかです。OpenAI(Sora)のドキュメントが示すとおり、画像入力パラメータを指定するかどうかで生成の出発点が変わります。
入力画像の扱われ方はツールごとに異なります。SoraとMiniMaxは画像を先頭フレームとして扱う設計であることが読み取れ、PixVerseは動きと効果を加える処理として説明され、Runwayは一貫したキャラクターを再現する参照元として使われます。
動きの指定方法にも種類があります。PixVerseはプロンプトの文章、Kling AIは開始・終了フレームの2枚指定という拡張オプションを持っています。
用意する画像にも条件があります。MiniMaxはファイル形式・サイズ・アスペクト比を、Soraは動画の解像度との一致を求めています。
生成AI全体の位置づけは生成AIとはで扱っています。動画生成の導入や社内活用を相談したい場合はお問い合わせはこちらからご相談ください。
この記事の出典
- Image-to-Video Task - Models - MiniMax API Docs(MiniMax、2026-09-13確認)
- Image-to-Video generation - PixVerse Platform Docs(PixVerse、2026-09-13確認)
- Kling AI Video Start & End Frames Guide(Kling AI、2026-09-13確認)
- Introducing Runway Gen-4(Runway、2026-09-13確認)
- Video generation with Sora - OpenAI API(OpenAI、2026-09-13確認)
この記事は役に立ちましたか?
感想は、今後の記事改善に活用します。
関連記事
ジェイルブレイク(Jailbreak)とは?Anthropicの公式説明をもとにした用語の範囲
本記事ではAnthropicの公式説明をもとに、ジェイルブレイクを提供元が設けた制限を回避しようとする試みとして扱います。会社で確認したい自社規程・契約・提供元の説明、相談先・記録の選択肢を整理します。
Zero-shot(例を示さない依頼)とは?業務での使い分けと指示の書き方
Zero-shotとは、AIにお手本の例を示さず、指示と必要な情報だけで頼む書き方です。例を示す場合との使い分け、指示に書く項目、業務で確認したい点を会社員向けに解説します。
Few-shot(少数例プロンプト)とは?AIへの依頼にお手本を添える書き方
Few-shotとは、AIへの依頼文に望む入出力のお手本を少数添え、出力の型や判断の例を示す書き方です。例の選び方、業務データの確認点、構造化出力との違いを解説します。
思考の連鎖(Chain of Thought)とは?AIに途中の考えを順に出させる依頼の仕方
思考の連鎖(CoT)は、AIに結論だけでなく途中の考えや理由を順に出させる依頼の仕方です。推論モデルとの違い、業務で確認したい点、出力をそのまま信じない理由を解説します。
次のAIツール選びへ
気になるツールを並べて、料金や特徴の違いを確認できます。