Jevとは?文章を返さないAIが保証するのは「型」だけ|構造化出力との違いと早期アクセスの条件
Jev(ジェブ)は、文章を返さないAIです。渡した状況に対して、あらかじめ決めておいた選択肢や点数、Yes/Noの確率だけを返します。
いま試せるのは開発元から早期アクセスの案内を受けた人だけで、一般提供の時期は公表されていません。今日の時点で決められるのは、自分の処理がこの形に合うかどうかまでです。
合うかどうかは、速さや料金の公表値だけでは決まりません。効いてくるのは、何が保証されて何が保証されないのか、公表値がどういう条件で出た数字なのか、日本語で使うと何が変わるのかの3点です。
この記事では、この3点に沿ってJevの現在地を確認していきます。読み終えると、いまの分類処理を作り直すべきか、それとも待つべきかを判断できます。
この記事を読むと、Jevが何を保証して何を保証しないのかがわかります!
この記事の監修者
AIリスキル株式会社 代表取締役
AIツールギャラリーを運営するAIリスキル株式会社の代表取締役。企業・自治体向けの生成AI研修とAI導入支援を手がけています。
実績: 大阪・関西万博 公式プログラム「AI HEROES COLLECTION」司会進行 / 神戸市デジタル人材育成エコシステム構築事業の運営 / MBS「せやねん!」「よんチャンTV」に生成AIの専門家として出演 / Felo日本初コアアンバサダー / Genspark第1期公式アンバサダー / Skywork公式アンバサダー / AKOOL公式パートナー など
はじめに:Jevは「文章を返さないAI」
Jevは、TypeSafe AIが2026年9月15日に早期アクセスを開始したAPIです。同社はこれを「System One Model」という新しいモデル分類の第1号だと説明しています。
この呼び方は同社が提唱しているもので、業界で定着した用語ではありません。同社はこの分類を、ソフトウェアの内部で速い判断を担うモデルだと位置づけています。
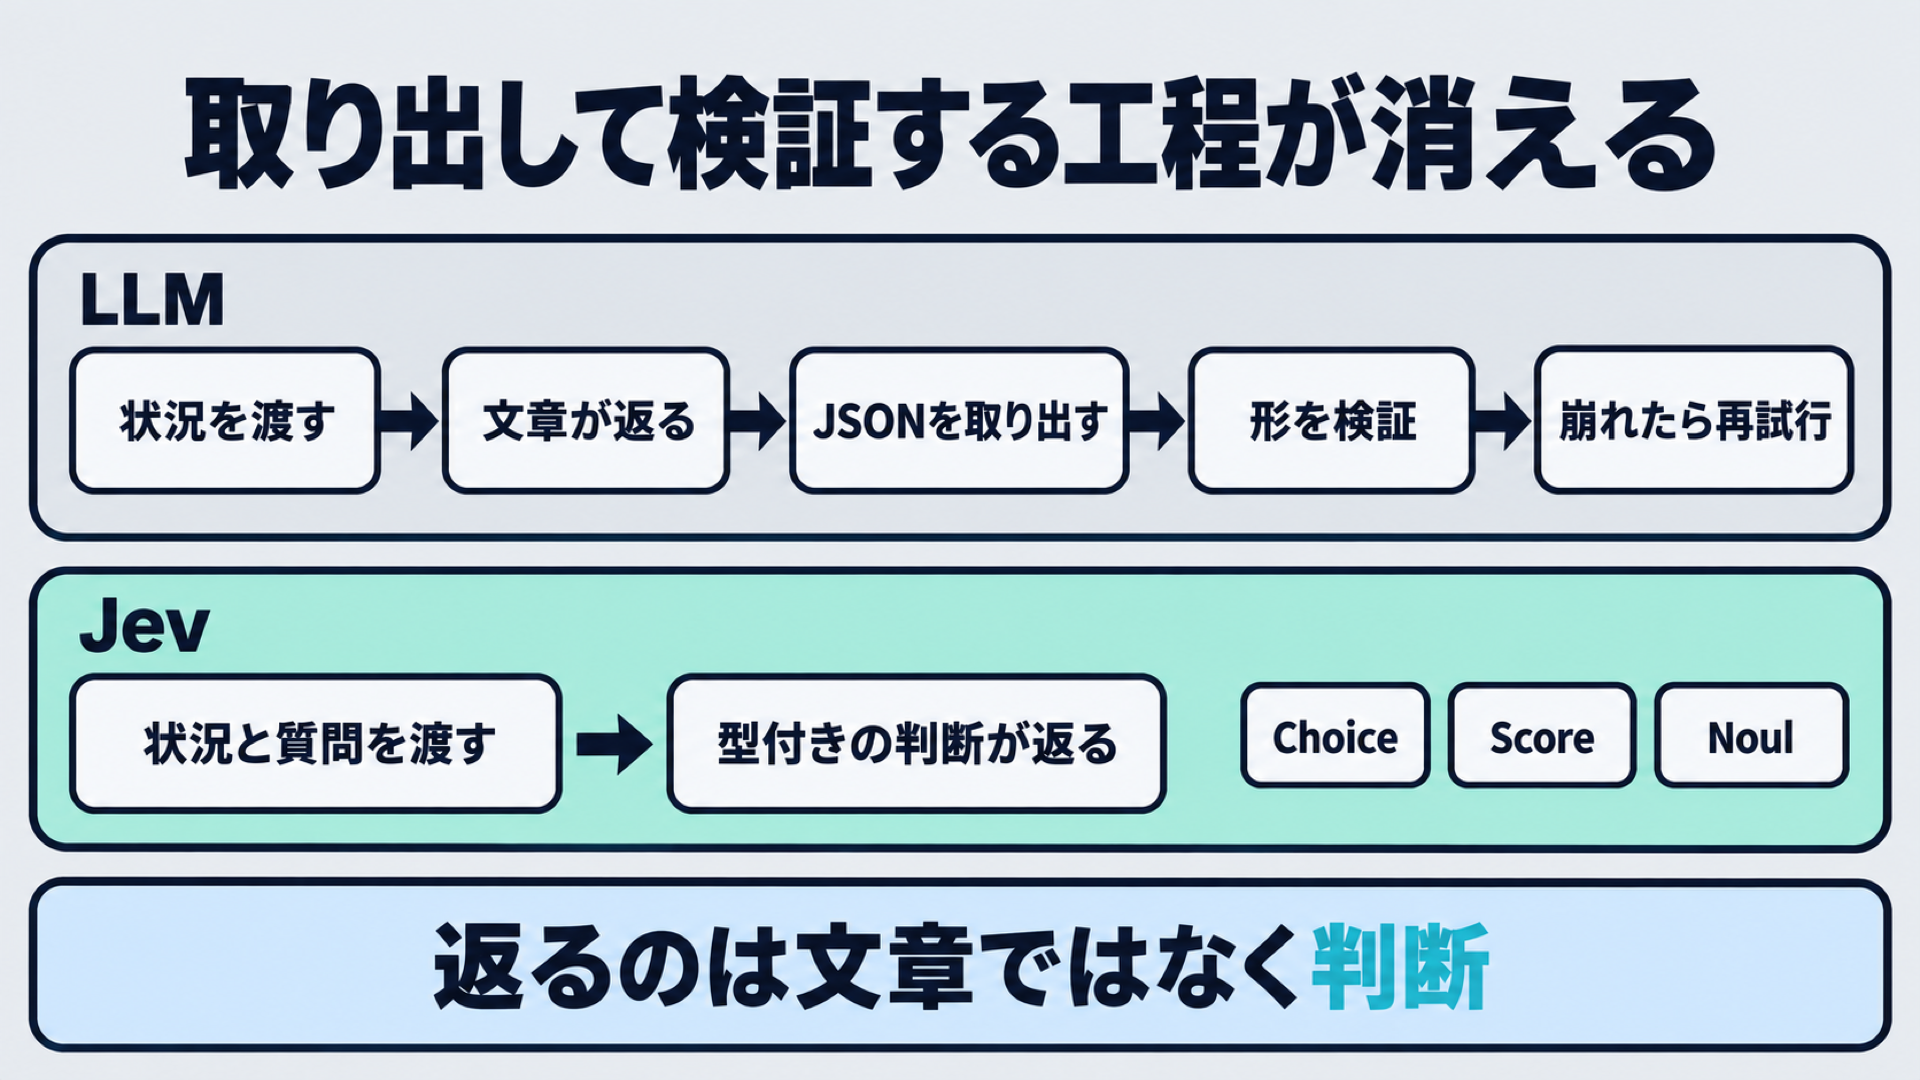
LLMに文章を書かせて判断させる作り方では、返ってくるのは文章です。そこからJSONを取り出し、形が正しいかを検証し、崩れていれば頼み直す処理が必要になります。
Jevはこの経路そのものを短くしようとしています。
返ってくるのは文章ではなく確率つきの判断
Jevに渡すのは、状況を表す文章と、それに対する質問のセットです。質問には3つの型があります。
- Choice: 用意した選択肢から1つを選び、各選択肢の確率と確信度を返す
- Score: 決めた範囲のなかで点数を付ける
- Noul: Yes/Noを確率で返す
たとえば問い合わせの本文を渡し、「どの部署か」をChoiceで、「緊急度」をScoreで聞く、という使い方になります。複数の質問は1回の呼び出しでまとめて処理されます。
Choiceの選択肢は255個まで指定できると公表されています。返ってくる値は必ずこの選択肢のなかに収まるため、取り出して解析する手間がかかりません。
開発元と、いま使える人
開発元のTypeSafe AIは、創業者のDiogo Almeida氏が率いています。同氏は以前OpenAIに在籍し、言語モデルが指示に従うための手法の研究に関わっていました。
約2年の非公開期間を経て、今回の発表に至っています。
提供形態は早期アクセスのみで、waitlistから案内を受けた開発者が使える状態です。同社は案内を進めているとしていますが、一般提供の日程は公表されていません。
つまり現時点では、業務システムへ組み込む段階の製品ではありません。なお、Jev本体は画像の入力に対応していないと明記されています。
構造化出力そのものの仕組みから確認したい場合は、構造化出力とはをあわせてご覧ください。モデルの分類という見方に関心があれば、小規模言語モデル(SLM)も参考になります。
いまの構造化出力と何が違うのか
JSONで返してもらう方法は、既存のLLMにもすでにあります。そのため新しさは「形が返ること」ではなく、その形がどう守られるかにあります。
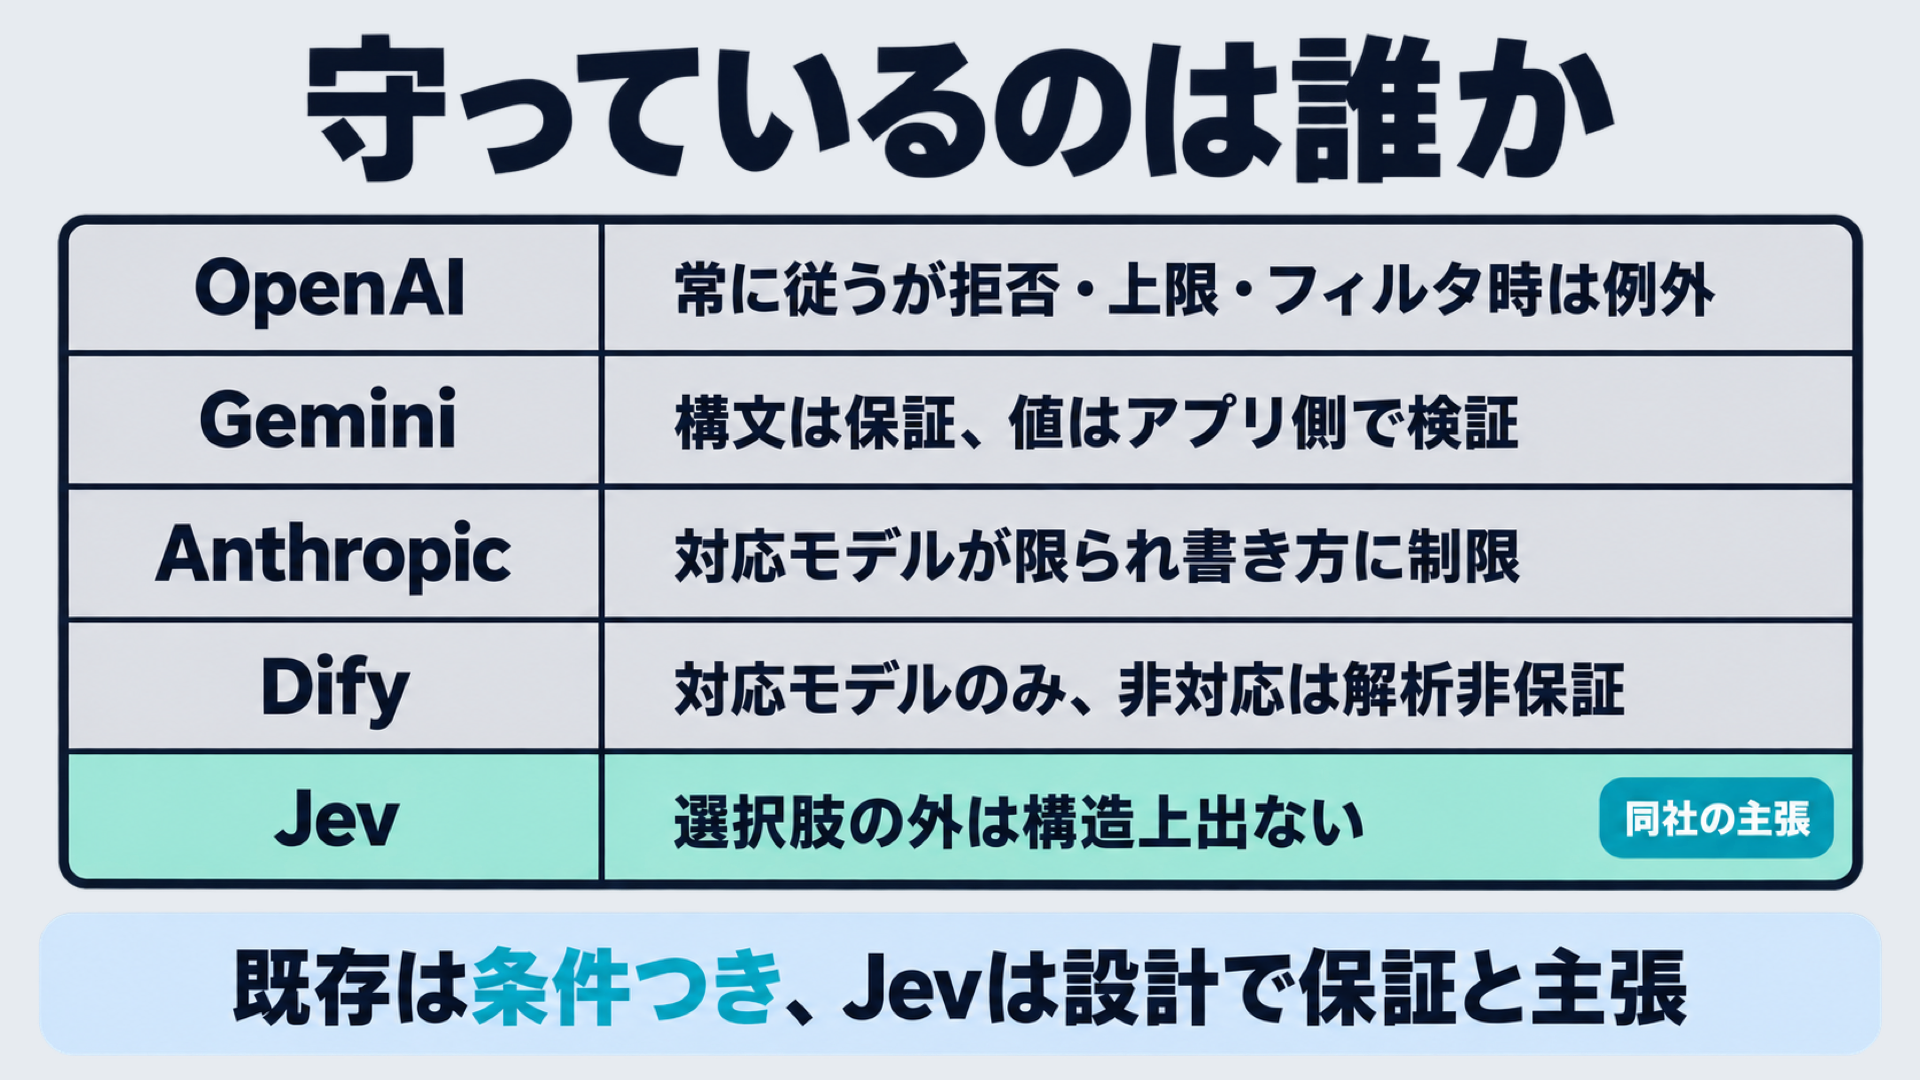
違いは「誰が形を守っているか」にあります。既存の方法はモデルと提供元の実装が守っていて、Jevは設計そのもので守ると主張しています。
既存は「提供元ごとに保証の強さが違う」
当サイトで主要な提供元の公式説明を確認したところ、構造化出力の保証の条件はそれぞれ違いました。
| 提供元 | 保証の条件 |
|---|---|
| OpenAI | 指定した形に常に従う。ただし拒否・上限到達・フィルタ作動時は例外 |
| Gemini | 構文の正しさは保証。値の妥当性はアプリ側での検証が必要 |
| Anthropic | 対応するモデルが限られ、スキーマの書き方にも制限がある |
| Dify | 対応モデルを選んだ場合のみ。非対応モデルではプロンプト扱いで解析は非保証 |
そのため「構造化出力を使えば必ず指定形式で返る」とは言い切れません。詳しい条件は構造化出力とはで提供元ごとに整理しています。
ChatGPTのようなLLMで分類処理を書いたときに、形式エラーへの備えが必要になるのはこのためです。
Jevは「型の正しさは設計で保証される」と主張している
Jevでは、答えの候補を呼び出しの前に決めます。選択肢の外の値は構造上出てこないため、形式エラーは起きないという説明です。
同社は構造化出力のエラー率を0%と公表しています。ただしこれはアーキテクチャから導かれる数学的な保証であり、実測値ではないと公式に明記されています。
文章を生成する機能そのものを持たないことが、この設計の代償です。チャットもコード生成も、文章による説明の出力もできません。
保証されるのは型で、判断の正しさではない
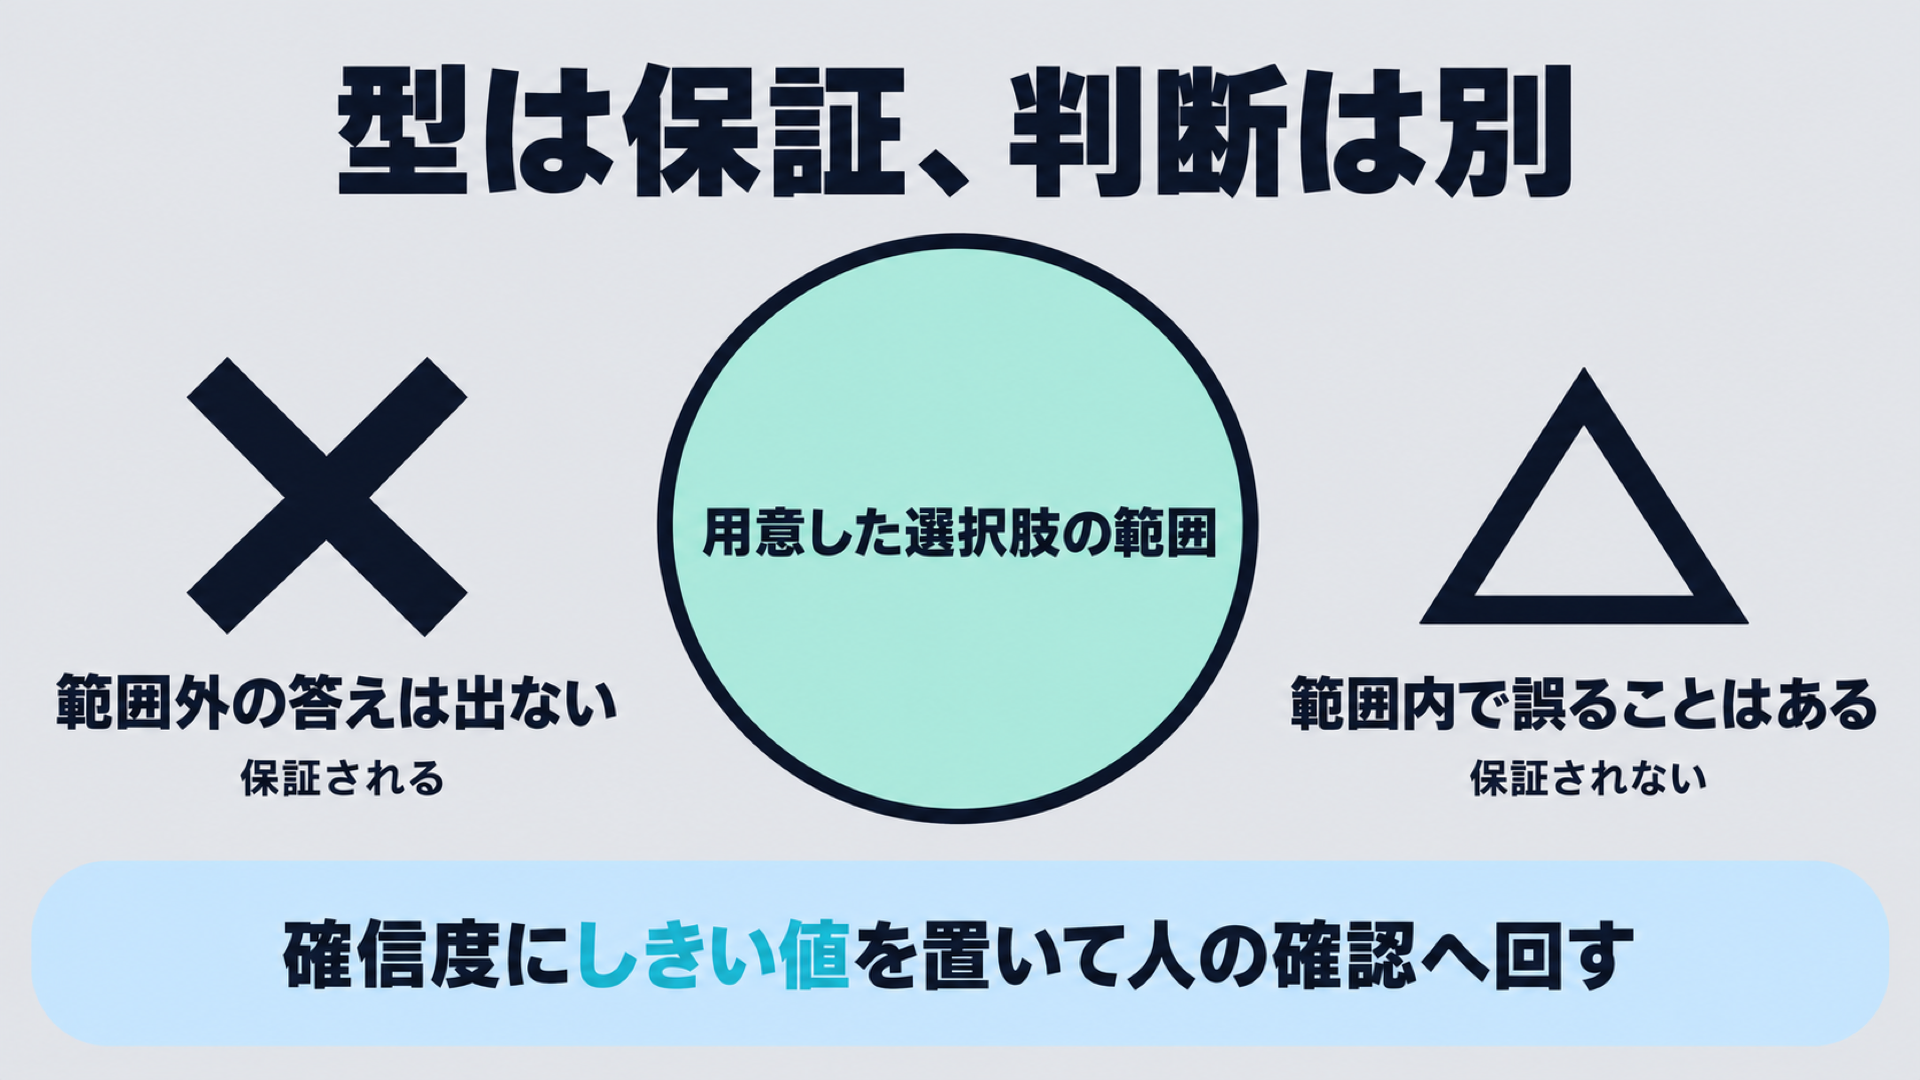
ここは誤解しやすいところです。「ハルシネーションしない」という表現は、指定した選択肢の外の答えや、決めた構造に合わない出力が出ないという意味にとどまります。
用意した選択肢のなかから誤った選択肢を選ぶ可能性は残ります。 型が正しいことと、判断が正しいことは別だという指摘は、国内外の解説で共通しています。
そこで確信度にしきい値を設け、自動で処理する範囲と人が確認する範囲を分ける運用が勧められています。形式の検証が減るぶん、判断の検証は自分で設計する必要があります。
公表されている速度と料金、どこまで確かなのか
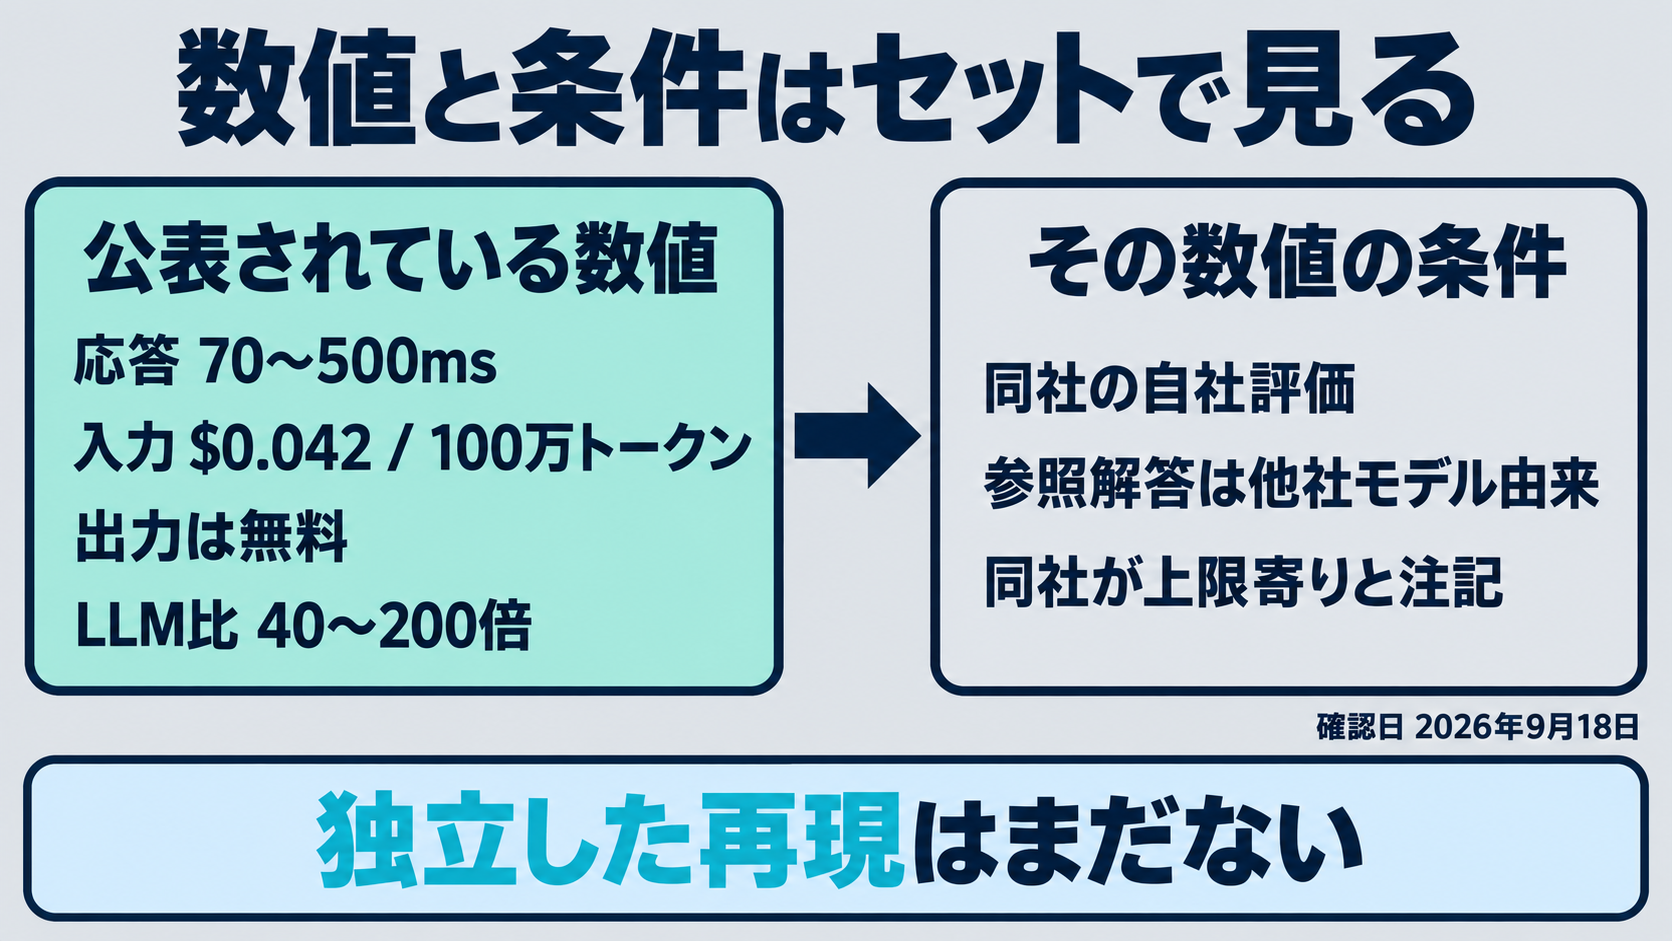
公表値はいずれもTypeSafe自身が出した数字です。読むときは、数字とあわせて測定条件を見る必要があります。
同社の公表値では、応答は70ミリ秒から500ミリ秒で終わるとされています。同じ処理をLLMに任せた場合との比較では、40倍から200倍速いと説明されています。
料金は入力100万トークンあたり0.042ドルで、出力トークンは無料だと公表されています。課金されるのが入力だけという形は、判断を大量に呼ぶ使い方を想定したものです。
速度と価格はどの条件で出た数字か
速度とコストの大きな倍率は、同社が用意した業務ワークフローの評価で出たものです。同社はこの倍率を、幅のなかで上限寄りの値だと自ら注記しています。
この評価には、条件の偏りが指摘されています。ワークフローを作ったのが同社自身のチームであり、正解とされる答えも他社の既存モデルの出力に基づいているためです。
そのため精度が既存モデルと並ぶという見方は、独立した再現が出るまでは有望な見込みとして扱うのが妥当だとされています。
価格が続くかは分からない
料金については、同社が補助されていないことを証明できないと自ら述べています。そのうえで、長期的には上がるより下がる見込みだと説明しています。
つまり現在の単価を前提に長期の費用を積む段階ではありません。利用量の上限も公表されていません。
業務のデータを送る場合は、利用規約とデータの取り扱い条件、保持期間もあわせて確認が必要です。料金と同じく、早期アクセスで実際に触れる段階で詰める項目になります。
日本語で使うと何が変わるのか
同社の公表値には、日本語で使った場合や日本から呼んだ場合の条件は含まれていません。この点については、実際にJevを動かした方の報告が公開されています。
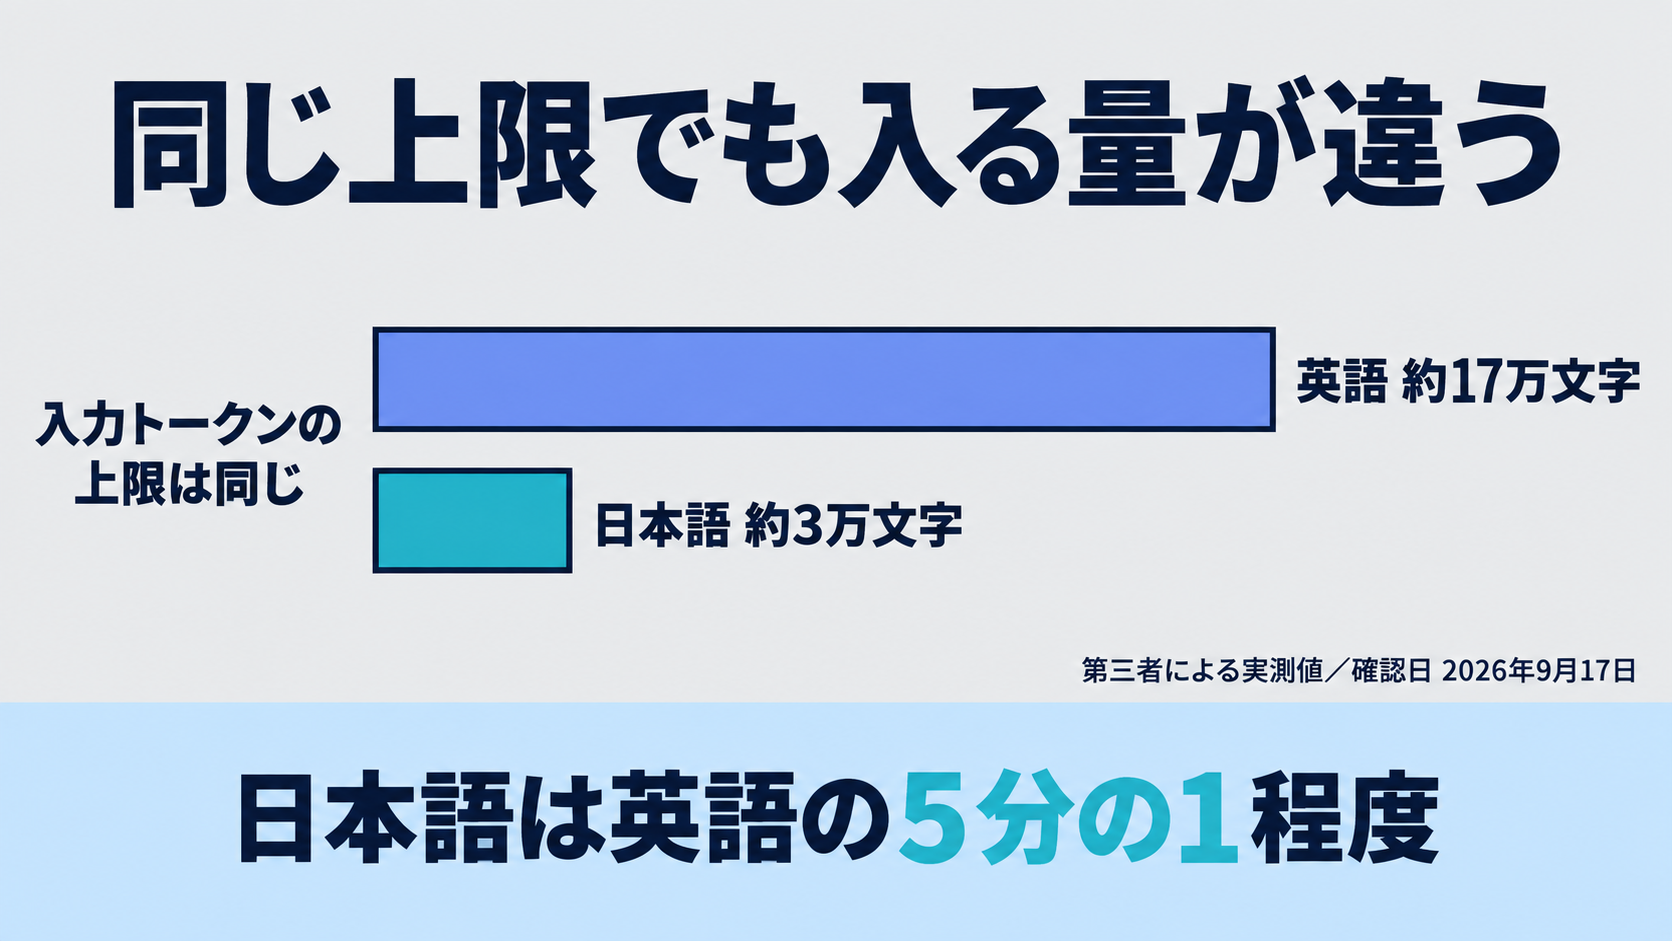
以下は開発者の@kiarina37氏が2026年9月17日に公開した実測で、検証コードと生データもあわせて公開されています。当サイトでは再現しておらず、独立に検証されたものではありません。
まず入力できる分量が変わります。日本語は1文字がほぼ1トークンに相当するため、状況を渡す欄に入るのは約3万文字だったと報告されています。
同じ条件で、英語なら約17万文字が入るとされています。5倍以上の差です。
なお同氏は、トークン上限の内訳が公式ドキュメントの説明と食い違っていた点も挙げています。上限を超えた場合はエラーで落ちるため、黙って切り詰められる心配はないとされています。
次に応答時間です。日本国内の開発マシンから短い質問を送った場合の中央値は、205ミリ秒から215ミリ秒だったとされています。
この70ミリ秒について、同社の拠点に近い米国西海岸などからの測定値だと説明する解説もあります。測定地はTypeSafeの公表資料には書かれていないため、日本から呼ぶ前提で見積もるなら自分の環境で測るのが確実です。
運用面では、質問文を何語で書くかが効くという報告もあります。8言語の本文を分類したところ、質問文を英語で書けばどの言語の本文でも英語とほぼ同じ判断になり、質問まで各言語に訳すと選択肢の書き方によってぶれたとされています。
ただし同氏は留保も示しています。長文から一文を探す検証では題材を意図的に易しくしたこと、多言語のデータはネイティブによる校正を経ていないこと、緊急度などのラベル付けに作成者の主観が入ることが挙げられています。
数値の詳細や検証の手順は、記事末の出典に挙げた本人の投稿とリポジトリで確認できます。自社で判断する際は、自分のデータで同じ測り方をするのが確実です。
向く処理と、向かない処理
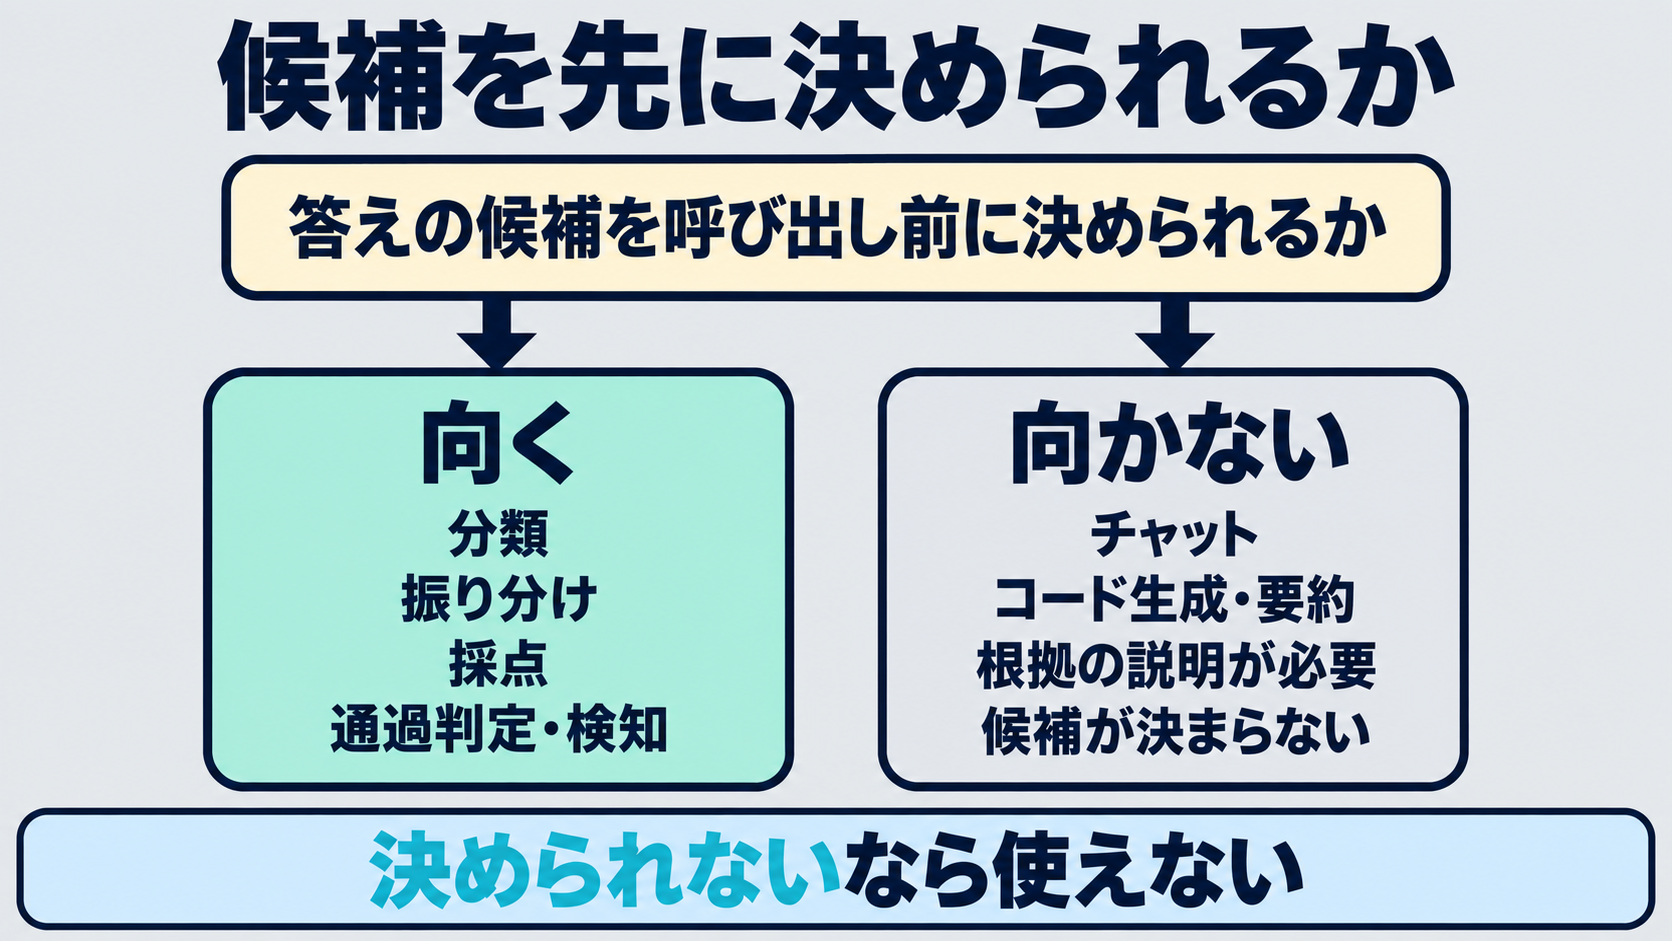
向くかどうかの分かれ目は、答えの候補を呼び出しの前に決められるかどうかです。ここが決まらない処理では、Jevの設計そのものが成立しません。
向く:選択肢が事前に決まっている繰り返しの判断
同社が挙げているのは、分類、振り分け、スコアリング、処理を通すかどうかの判定です。いずれも答えの候補が先に決まっていて、同じ判断を何度も繰り返す処理です。
出力の検証にも向くとされています。他のモデルの出力を採点したり、ジェイルブレイクの試行を検出したりする使い方です。
大量のデータを1件ずつ判定していく処理も、課金が入力だけという料金の形と噛み合います。
向かない:説明が必要な処理と、選択肢が決まらない処理
文章を出せないので、チャットでの応対やコード生成には使えません。要約や下書きの作成も対象外です。
判断の根拠が自然言語で返らない点は、運用上の制約として指摘されています。確率は返りますが理由の説明は返らないため、不具合の切り分けや、根拠の記録が求められる領域の監査では扱いにくくなります。
途中の考え方を残したい処理には、そもそも別の種類のモデルが向いています。詳しくは推論モデルで整理しています。

答えの候補を事前に列挙できない問題にも使えません。選択肢を決めることが設計の前提になっているためです。
早期アクセスを待つ間にできること
Jevはまだ試せる人が限られています。ただ、待っている間にやっておくと役に立つことがあります。
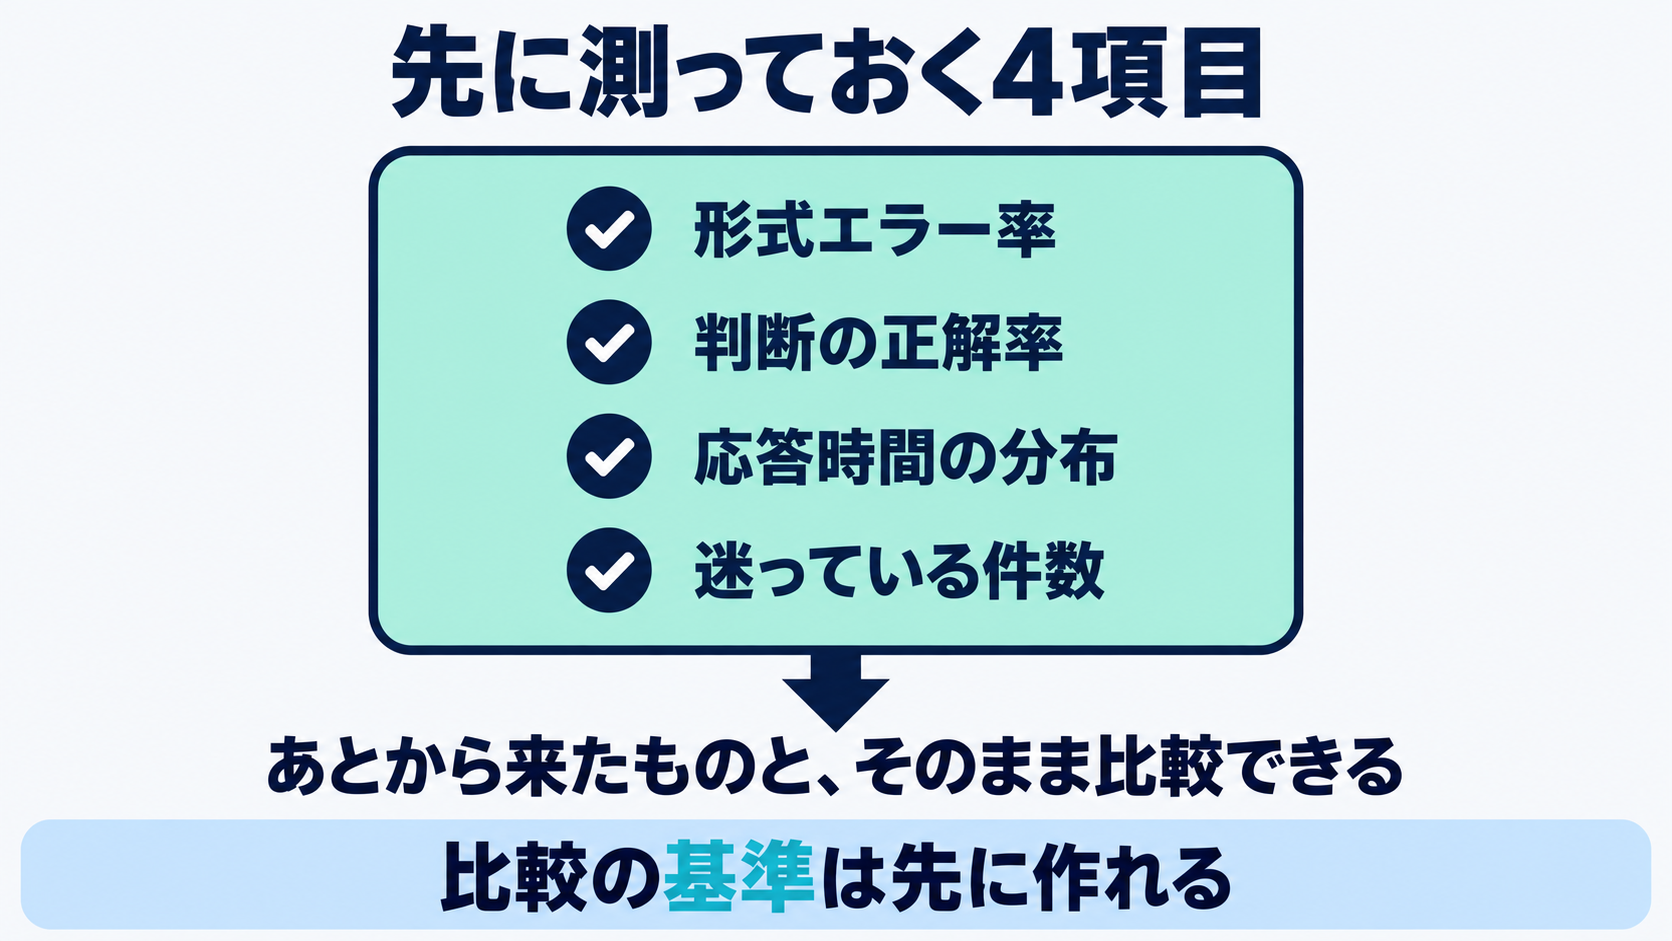
いま動いている分類処理が、どこでどのくらい壊れているかを自分のデータで測っておくことです。次の4点を記録しておくと、Jevを試せるようになったときにそのまま比較できます。
- 形式エラー率: 指定した形で返らなかった件数と、再試行にかかった回数
- 判断の正解率: 自社でラベルを付けたデータに対して、どのくらい正しく分類できているか
- 応答時間: 実際に呼んでいる場所から測った値。平均ではなく分布で見る
- 迷っている件数: 確信度が中間に寄った件数と、それを今どう扱っているか
この4点は、Jevが一般提供されなかったとしても価値が残ります。既存のモデルを入れ替える判断にも、人が確認する範囲を決める判断にも同じ数字を使えます。
判断の結果を実際の業務フローへつなぐ部分は、n8nのようなツールで先に組んでおくこともできます。判断を返す部分を後から差し替えられる形にしておくと、比較が楽になります。
測るのは今の仕組みでかまいません。比較の基準さえあれば、あとから何が来ても判断できます!
よくある質問
チャットボットに使えますか
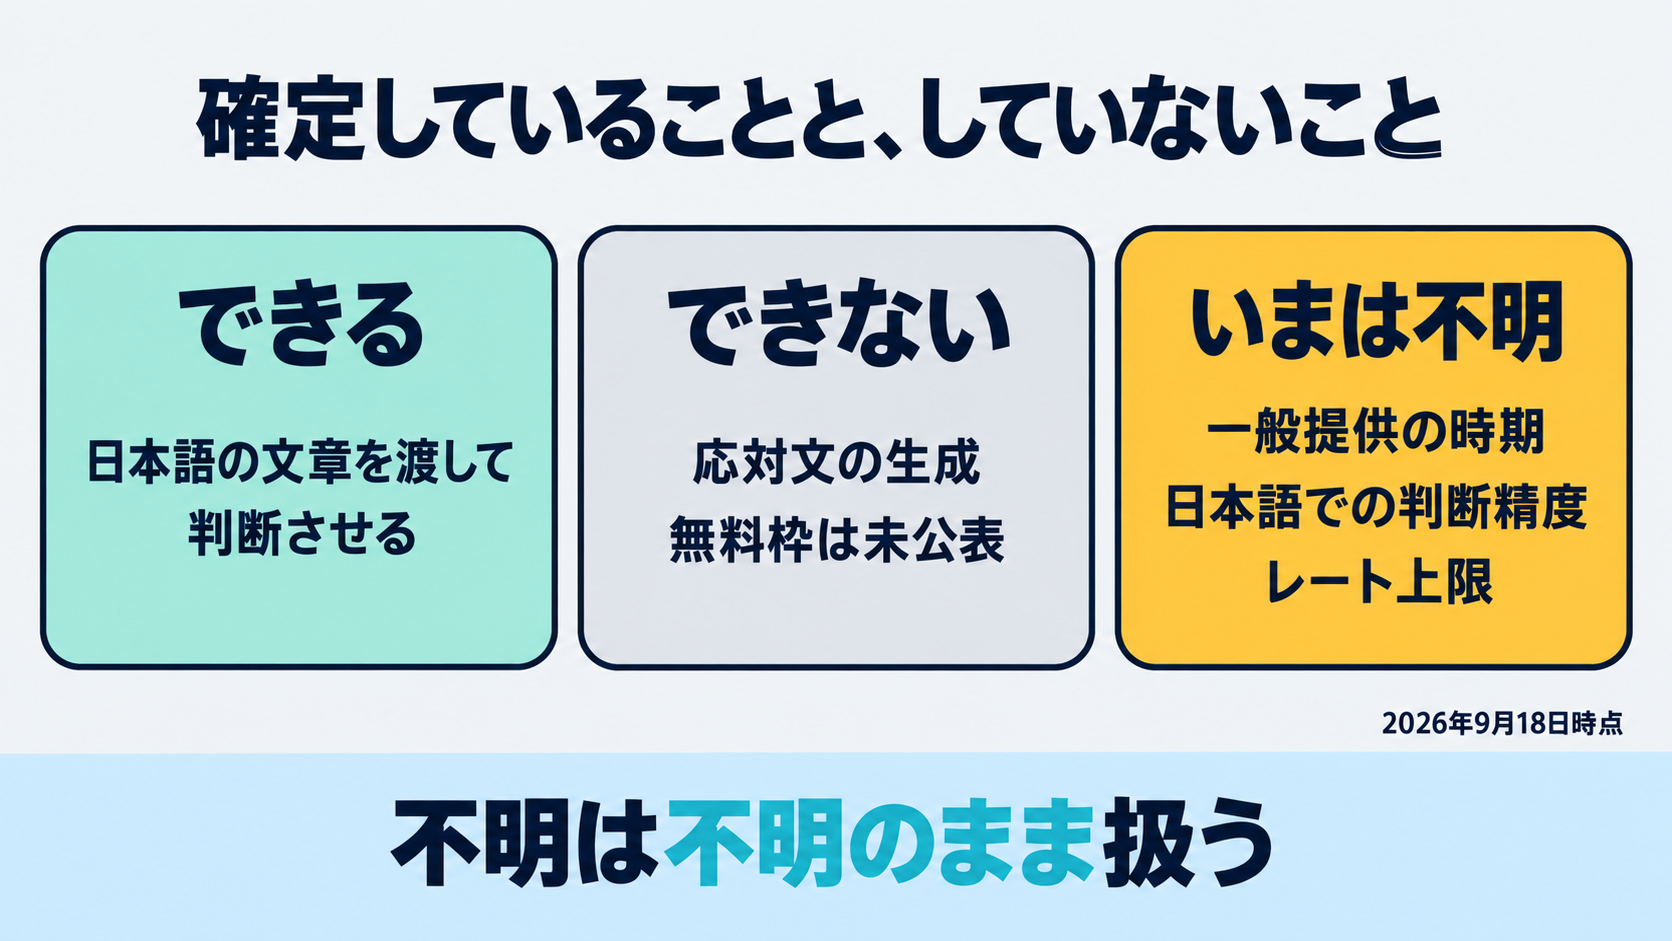
応対の文面を作ることはできません。Jevは文章を生成する機能を持たないためです。
ただしチャットボットの内部で、問い合わせの振り分けや通過判定だけを担わせる使い方はできます。文面の生成は従来のLLMと組み合わせることになります。
無料で試せますか
無料の枠は公表されていません。料金は入力トークンに対する従量課金で、月額のプランは示されていません。
早期アクセスもwaitlist制のため、登録してから順番を待つことになります。
日本語は使えますか
日本語の文章を渡して判断させることはできます。ただし入力できる文字数は英語より大幅に少なくなると報告されており、判断精度については独立した検証が出ていません。
自社のデータで確かめるのが確実です。
既存のLLMを置き換えるものですか
置き換えではなく、分類や振り分けのような判断部分だけを担う位置づけです。同社の説明も、文章が必要な処理を対象にしていません。
いつ一般提供されますか
公表されていません。開発元は、waitlistの順に案内を進めていると説明しています。
まとめ
Jevは、文章を返さず、決めておいた選択肢や点数、確率だけを返すAPIです。形式エラーが起きない設計は、分類や振り分けを大量に呼ぶ処理と噛み合います。
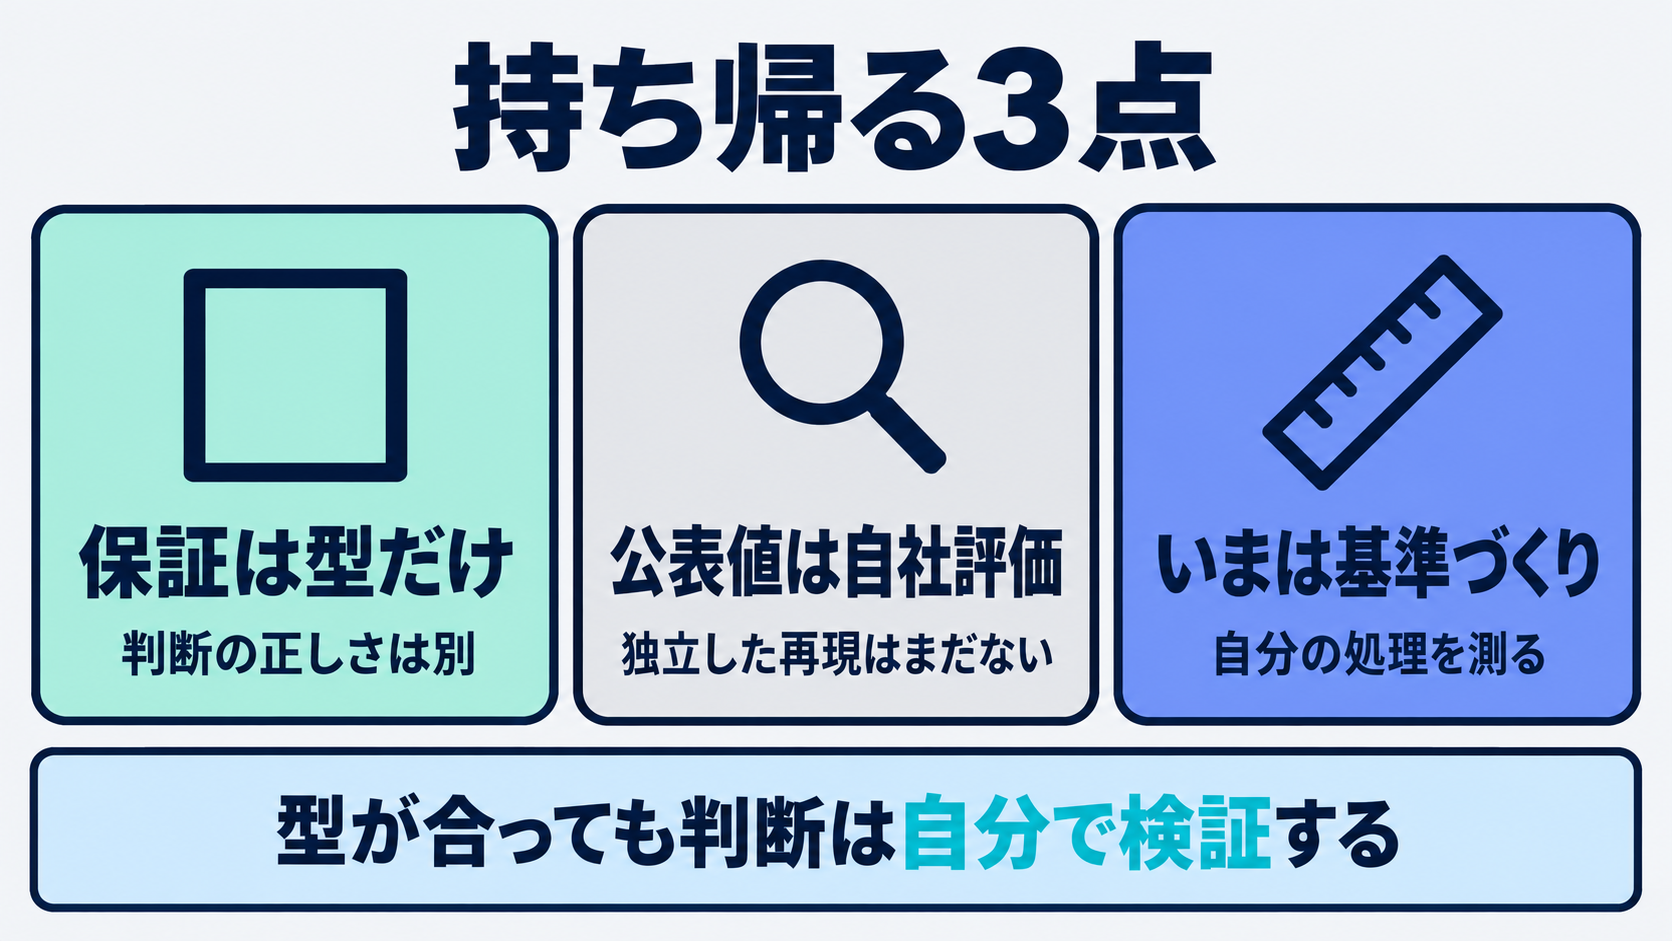
ただし保証されるのは返り値の型と候補の範囲で、判断そのものの正しさではありません。速度と料金の公表値も同社自身の評価によるもので、独立した再現はまだ出ていません。
日本語で使う場合は入力できる文字数が英語より大幅に少なくなり、日本から呼ぶ応答時間も公式値とは差があると報告されています。早期アクセスがwaitlist制である今の段階では、いま動いている処理の壊れ方を測り、比較の基準を作っておくのが現実的な進め方です。
分類や振り分けをどこまでAIに任せるかは、対象の業務と件数、そして誤ったときの影響の大きさで変わります。既製のAPIで足りるのか、作り込みが必要なのかを整理する段階からご相談いただけます。
この記事の出典
- Introducing System One Models & Jev(TypeSafe AI、2026年9月15日)
- TypeSafe AI 公式サイト(TypeSafe AI、2026年9月17日確認)
- TypeSafe AI、AIモデル「Jev」の早期提供を開始(gihyo.jp、2026年9月)
- 高速な判断に特化したAI - TypeSafe「Jev」 と System One Model(npaka、2026年9月)
- Jev: TypeSafe's System One Model That Never Hallucinates(DataCamp、2026年9月)
- Jevの実測に関する投稿(@kiarina37、2026年9月17日)
- typesafe-jev-evaluation(検証コードと生データ)(@kiarina37、2026年9月17日)
この記事は役に立ちましたか?
感想は、今後の記事改善に活用します。
関連記事
Nebius Token Factoryとは?料金の決まり方とOpenAI互換APIの使い方
Nebius Token Factoryは、DeepSeekやQwenなどオープンソースのモデルを、提供元が自社のGPUで動かしながらOpenAI互換APIで呼び出せる推論プラットフォームです。料金はトークン単価制で、OpenRouterなどのゲートウェイとは取り次ぐか自社で動かすかという立ち位置が異なります。
OpenRouterとは?料金の仕組みと手数料の実額、始め方
OpenRouterは、1つのAPIキーで複数の会社のAIモデルを呼び分けられる中継サービスです。無料のモデルもありますが、主要なモデルはクレジットの前払いが要り、購入時にも費用が乗ります。
OrcaRouterとは?OpenRouterとの違い・料金・使い方
OrcaRouterは、GPT・Claude・Geminiなど200以上のAIモデルをOpenAI互換の1つのAPIで呼び出せるAIゲートウェイです。トークン単価への上乗せはなく、HackerプランとTeamプランのトップアップ手数料は0ドルと料金ページに明記されています。
【2025最新】コンテキストエンジニアリングとは?プロンプトエンジニアリングとの違い、ChatGPTでの活用法を解説
生成AIを日常的に使っている方で、「プロ
次のAIツール選びへ
気になるツールを並べて、料金や特徴の違いを確認できます。